
[从零训练一个
机房里有了位置,服务器之间也有了通路。我把正式训练前的验收流程摊开,先找材料进入GPU的位置,再找参数保存的位置。5,120张B200要连续训练约76天,这两条路都必须在开跑前接顺。
验收表原来只有“读取成功”和“保存成功”两项。看起来都对,却回答不了真正要问的事:下一批材料准备得慢,GPU要等多久?训练日历已经排到76天,跑到第十天停机,进度又能从哪里接回来?我在两行后面分别加上时间与恢复要求,存储的任务一下子变具体了。
这两个问题把存储的工作分开了。一头要把教材持续送到GPU,另一头要把已经学到的东西保存下来。先沿读入路径走,再沿保存路径走,需要多少空间、读写多快和买什么设备,才能由这两件具体的事算出来。
下一批材料,卡在了哪一段?
先去找即将送入GPU的材料。第九篇已经把文字转成token编号,整理成训练序列。打开文件,主体像[418, 732, 25, …]这样一串整数,实际编号由分词器决定。
完整文件放在共享存储,640台训练服务器从同一版本的教材库取材料。哪台读哪一部分,由训练程序按配方分配。材料有了统一出处,接着要解决的是每批怎样及时到手。
我把路径拆成几段:先从共享库取近期要用的文件,放到服务器自己的固态硬盘;再抽出当前一批编号,放进服务器内存,最后送到GPU。GPU算这一批时,程序已经准备下一批,读取与计算便能接起来。
反复回共享库取,路就走得太勤。材料会打乱、混合,也会重复阅读,近期文件留在机器身边更合适。于是每台先划1TB本地缓存,按接下来的取样计划填充、替换。
这时,5T token完整库存留在共享存储,各台按需取文件,GPU只接眼前一小批。教材沿“共享库→本地硬盘→内存→GPU”接力,下一批的准备时间就有了可以观察和改进的位置。
共享存储:多台服务器都能访问的文件存放系统。本文用它保存统一的训练材料和近期进度。
缓存:把近期会用到的内容放在更近的位置。这里指服务器自己的固态硬盘空间。
预取:在当前一批还没有处理完时,提前准备下一批材料。
5T token的教材,为什么只占20TB?
回到容量表,5T与10T又并排出现。第七篇定的是约5T独立合格库存目标,训练累计读10T,有些材料会被读不止一遍。
一本500万页的教材,累计读到1,000万页,书架也不必再放一套。取样程序再次找到原来的页,就能重读。硬盘按独立库存算,训练量按累计读过的token算。
再把每个编号的格式放进来。本计划一号4字节,5T编号主体就是:
5万亿个编号 × 每个4字节 = 20万亿字节 = 20TB
20TB比直觉小得多。沿着文件再看一次,里面存的是编号,编号对应的向量由模型在训练时查出来。每次出现的token无需在教材文件里带着一整条向量,体积差别就在这里。
编号主体之外,程序还得快速找到每份文档的位置和长度,索引因此也要占空间。我给正式教材留30TB可用空间,20TB放编号,其余放索引、文档边界等配套内容。
原始网页和清洗前后版本另放归档。当前训练工作区留选定版本,GPU来取时,拿到的就是这次训练要用的那套材料。
为什么编号按4字节计算?
编号格式要和词表对上。Megatron的数据集实现会按词表大小选整数格式,这份计划采用大词表的4字节int32。制作完文件,再把分词器、编号类型和实际大小放在一起核对,容量账就有了实物依据。
TB:本文按十进制计算,1TB等于1,000GB。20TB描述文件有多大。
索引:记录文档位置和长度的信息,帮助程序直接找到需要的内容。
跑到第十天,怎样保存已经学到的东西?
读入这条路接顺以后,再把训练日历翻到第十天。到这个位置,参数会经历许多次更新,只留最初的模型就接不上这段工作。因此验收表上的“保存成功”,必须包含“现在跑到哪里”的完整记录。
这份存档叫检查点。模型的参数、训练步数、材料读取位置一并留下,恢复时才知道接着哪里继续。先从最直观的权重开始数。
500B即5,000亿参数,每个按2字节保存:
5,000亿 × 2字节 = 1TB
1TB权重存好了,还没把训练接全。负责调整参数的优化器,会参考过去的更新情况来决定下一步怎样动;丢了这些记录,它就接不上原来的调整过程。
把一个参数的账本打开,就能看到缺的是什么:模型计算时用一份省空间的数值,更新时另保留更精细的副本,让细小变化尽量留下来。Adam还记着两组历史,一组跟踪梯度总体朝哪走,一组跟踪梯度通常多大,分别帮助调整方向和步幅。第十六篇会跟着一个数逐步看它怎样更新。此刻先把这页账复制到5,000亿个参数上,容量便出来了。
选定常见的混合精度Adam方案,在一个完整训练步结束后,三部分主要状态一起保存:
| 保存什么 | 为什么要存 | 容量 |
|---|---|---|
| 模型当前权重 | 恢复模型此刻的参数,每个2字节 | 1TB |
| 更高精度的主权重 | 更新参数时使用,每个4字节 | 2TB |
| Adam的两组历史状态 | 延续此前的更新方向和幅度,每个参数共8字节 | 4TB |
| 合计 | 每个参数共14字节 | 7TB |
合计7TB。刚才只需搬一小批教材,保存进度却要把整个500B模型的当前训练状态留下,写入规模一下子大了起来。
这7TB由集群分担,各训练进程写自己负责的分片,拼起来才是完整存档。步数、学习率安排、随机状态和材料位置也跟着保存。NVIDIA检查点文档把这些内容纳入完整恢复流程,下一次启动便有据可接。
前面训练内存算过8TB,这里少了1TB,也有具体原因。运行训练步时还要保存梯度,用它完成参数更新;检查点选在更新结束后写,下一步的梯度恢复后重新计算。因此这份主状态按7TB存,运行内存和存档按各自时点计算。
检查点:某一时刻的模型和训练状态存档。恢复它,可以接着此前的进度训练。
优化器:根据计算出的梯度调整模型参数的算法。它保存的历史状态,会影响下一次怎样调整。
BF16与FP32:保存数字的两种精度。本文分别按每个数字2字节和4字节计算。
留三份存档,为什么要备四份空间?
接着决定多久留一次进度。我先把间隔放在一小时,快速共享存储保留最近三份。10:00那份完成后,10:40机器故障,可以回到10:00,重跑后面40分钟。这比重新开始十天训练有了明确的恢复边界。
间隔越短,故障后通常少重算一些,代价是更频繁地写盘。一小时先作为起点,试跑时测保存与恢复耗时,再结合故障情况调整,频率就能顺着实际代价来选。
刚写下“三份”,还漏了正在写的第四份。新存档完整写好、检查通过之前,旧三份都得保留;确认成功后,才删除最旧的。所以同时占用的是:
三份已完成 + 一份正在写 = 4 × 7TB = 28TB
28TB之外再给配套文件和写入过程留位置,近期检查点分到35TB。
但三份都在同一共享系统,一旦存储本身出问题,恢复路径仍然只有一条。于是每天挑一份完整检查点,复制到独立归档,长期进度有了另一处落点。
按76天主训练,每天一份,每份连同配套文件先留7.5TB,归档账是:
76份 × 7.5TB = 570TB
向上留到600TB,也就是0.6PB,专门放这76天的每日检查点。原始材料与清洗版本另有归档额度,不挤进这一行。
最近三份方便迅速重启,每日一份保留长期进度,并给共享系统故障留出恢复路径。存档去哪和为什么留,终于能一一对上。
归档:保存需要长期保留、但平时较少读取的文件。本文的检查点归档放在独立系统中。
PB:1PB等于1,000TB。这里0.6PB就是600TB。
空间够了,还要等多久?
空间数出来以后,验收表里的时间一栏还空着。教材库装得下,并不保证开机时取得快;检查点写得进去,也不保证保存不会拖住训练。两头各要有一个时间目标。
先算持续输入。累计10T编号,每号4字节,76天有效输入约40TB,平均每秒约6.1MB。这个平均数并不大,因为GPU要对每批编号背后的模型做大量计算。
可冷启动时,640台的缓存都空着,平均数回答不了眼前的排队。于是另设集中装载测试,按真实分配读取一份20TB编号主体,目标十分钟:
20,000GB ÷ 600秒 ≈ 33.3GB/s
换算后将共享读取验收目标取40GB/s。它对应开机时集中搬教材,6.1MB/s对应76天平均交给模型的编号量。两者放在不同时间尺度,差距就说得通了。
真实分配还会读索引,同一文件也可能送往几台机器。测试把这些重复传输计入,记录各机器何时准备好,才能知道启动到底等了多久。
再看每小时那份7TB存档,给完整保存留十分钟,其中包括状态整理、传输、检查和最终确认。我先把五分钟分给纯数据传输:
7,000GB ÷ 300秒 ≈ 23.3GB/s
于是持续写入目标取25GB/s。测试时让训练继续读教材,同时写检查点,看GPU会不会被拖着等。能后台保存的部分与计算重叠,实际暂停多久仍单独记下来。
采购单至此有了具体任务:教材按时装载,一份约7TB存档十分钟内完整可用。40GB/s读、25GB/s写都是为这两件事设的验收目标,用我们的文件与程序来验证。
GB/s:每秒传输多少GB,描述读写速度。TB回答“能装多少”,GB/s回答“搬得多快”。
异步保存:先形成一致的训练状态,再由后台继续写文件,让部分保存工作与训练重叠。
这些要求,落到哪一套设备上?
带着容量与速度要求再选设备,选择才有依据。30TB教材加35TB近期检查点是65TB,转换和版本切换还需要周转空间。我把DDN AI400X3M的120TB可用档放进采购方案。
DDN的2026年官方介绍列出120TB、250TB、500TB可用方案。先选120TB,让每一块空间都对应当前要做的工作:
| 用途 | 安排多少 | 为什么 |
|---|---|---|
| 正式教材和配套文件 | 30TB | 20TB编号主体,再留索引等空间 |
| 最近的训练存档 | 35TB | 保留三份,同时写一份 |
| 数据转换和版本切换 | 35TB | 切换时容纳一套30TB材料的临时副本及处理文件 |
| 后续余量 | 20TB | 随实际文件开销与实验需求分配 |
| 合计 | 120TB | 按实际可用容量验收 |
服务器身边的1TB缓存和独立0.6PB归档,也在机房图里各占一个位置。640台缓存合计640TB,分散在不同机器,还可能装着重复文件;共享工作区的120TB仍独立计数。
沿蓝线走,教材从共享存储到本地缓存,再入内存与GPU;沿橙线回来,训练状态写入共享区,每日再复制一份到独立归档。三处存储围绕同一次训练形成了完整的来回。
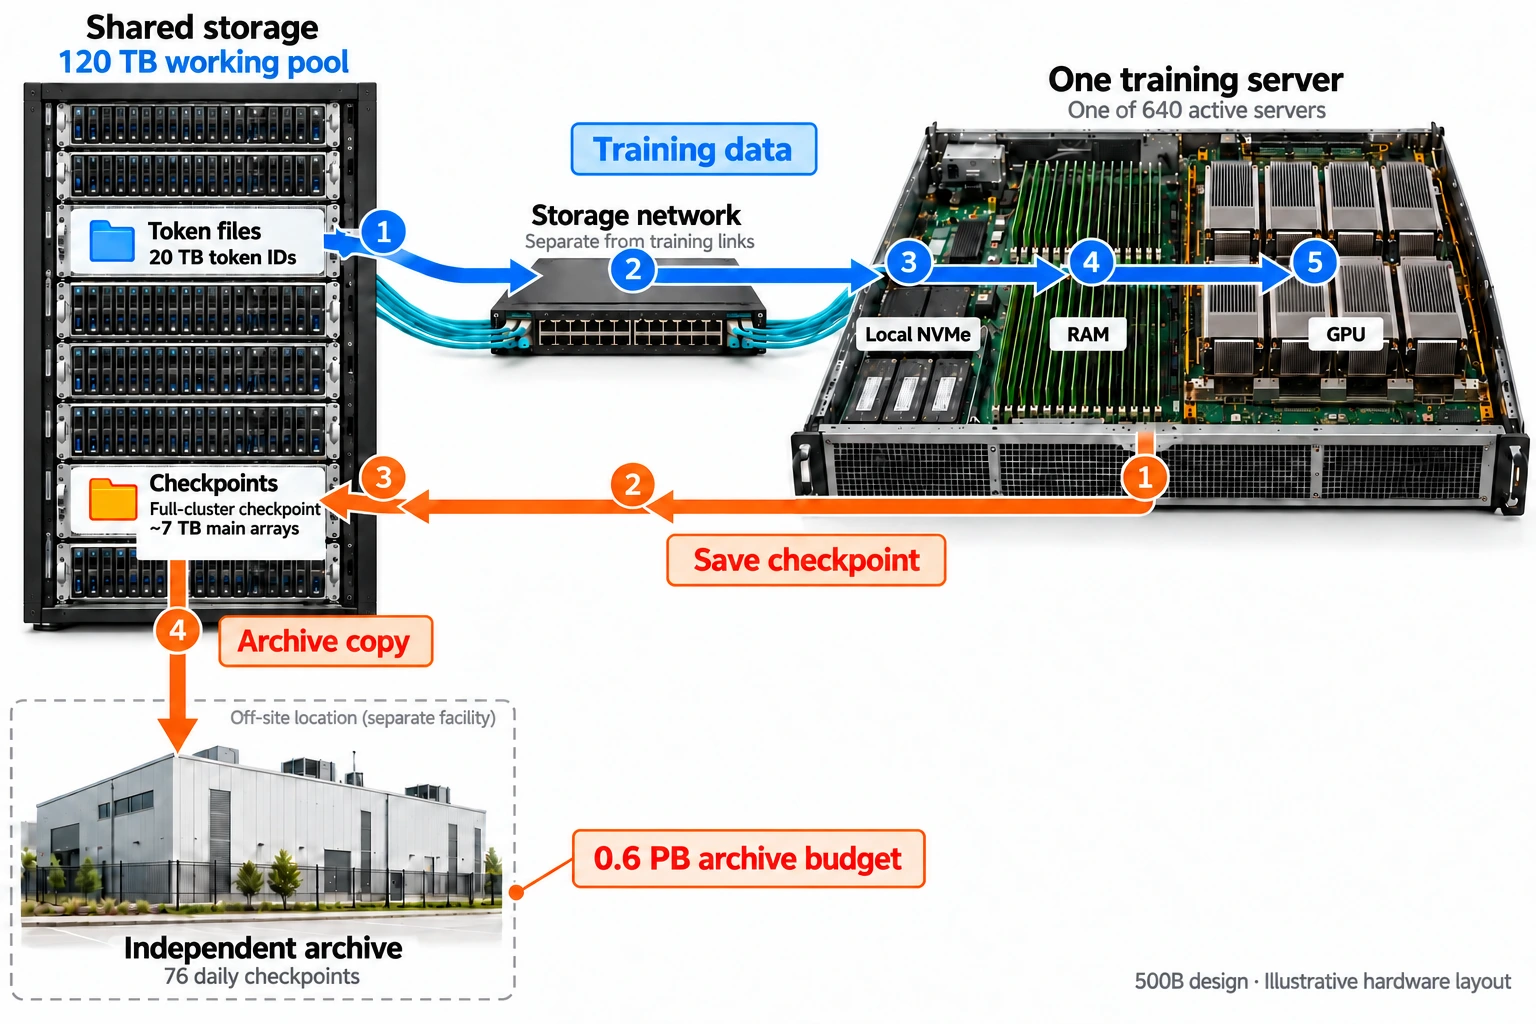
沿蓝线看教材读入,沿橙线看进度保存。设备布局为规划示意;点击图片查看高清原图。
交付时,需要的是640台服务器都能访问的完整系统。这套120TB配置要同时接受读40GB/s、写25GB/s测试,软件、连接和盘的耐久也一起进入集成清单。
采购与集成时,把这些项目写进清单
要让目录真正被各台机器共同访问,订单包括AI400X3M、配套ES400NVX2管理节点、EXAScaler文件系统软件与支持。系统和数据保护占用扣除后,文件真正能用到120TB,才符合容量要求。
这些文件还需要自己的网络。第十二篇端口已经分给GPU通信,存储按独立200GbE要求配置额外网卡与交换机,并核剩余槽位和PCIe连接。单链路200Gb/s标称约25GB/s,实际文件速度更低,存储侧因此要靠多条连接承接集群并发,最终按整体目标验收。
本地1TB先从整机固态盘划工作配额,系统盘占用、盘数、实际可用空间写入集成表。换一台机器,缓存可以重新从共享库填充,统一教材仍有出处。
容量够,盘也要承受反复写入。每小时7TB,一天约168TB逻辑写入;删除旧存档能腾位置,已经发生的写入却还计入寿命。供应商按真实大小、频率、期限核耐久与更换方案。
平台峰值先用来筛选,最终仍让这套120TB配置一边读教材、一边写真实检查点,留下持续速度、GPU等待和完整保存时间。
可用容量:扣除系统与数据保护开销后,真正能分配给文件的空间。
最后,真的停下来,再接着训练一次
文件写完,还差一次最关键的验证:它能不能把训练真的接回来?我把这一步列成完整演练。先运行、保存,再主动停止,用备用机替换一个位置,然后从存档恢复。
先核所有分片齐全、检查通过,才将它标为可恢复。启动后对照参数、优化器状态、步数、材料位置,接着继续跑一段,与未中断对照比较,按实现允许的数值差异核结果。
共享存储与独立归档各做一次,存档的两条路径都要走通。目录里有文件只是中间一步,能接着训练才算交付。
| 要验证的事情 | 本计划的目标 |
|---|---|
| 教材有地方放 | 共享系统120TB可用,按上表划分空间 |
| 开始时拿教材够快 | 按真实分配装载20TB编号主体,目标十分钟,重复传输计入测试 |
| 训练时可以边读边存 | 并发验收读40GB/s、写25GB/s,并记录GPU等待时间 |
| 一份进度能及时保存 | 约7TB主状态及配套文件,目标十分钟内完整可恢复 |
| 出故障以后能继续 | 从共享存储和独立归档各恢复一次,核对训练状态与后续结果 |
最终留下的安排是120TB共享区、每台1TB缓存和0.6PB独立日归档。材料一批批进,进度每小时出一份,机器停下来也有路接回去。硬件与数据的来回通了,还有一层要补齐:这些机器上的软件,怎样共同执行同一个训练任务?
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。