
[从零训练一个
教材有了去处,训练进度也有了存档位置。我登录第一台八卡B200,准备让它读一小份材料。终端里的命令要经过一整套软件,才能落到GPU上。640台机器都要这样工作,第一台怎么装,就成了后面所有机器的起点。
先把目标压到最小:训练几步,保存,关掉进程,再从保存的位置继续。能把这条路走通,才把同一环境搬到其他服务器。最后5,120张GPU训练500B时,至少不会因为每台装得不一样,连问题出在哪里都找不到。
我把软件清单放在这个小任务旁边。一项软件只有解决了眼前的一个障碍,才知道为什么需要它,装好以后也才知道怎样验收。
一条训练命令,究竟经过谁?
名字很多,先顺着任务走。Ubuntu与驱动让机器能用硬件;任务提交后,Slurm分配机器,Pyxis与Enroot启动所选环境;到了每一步训练,Megatron安排分工,PyTorch做计算与求导,GPU计算库和NCCL分别负责计算、交换结果。自动装机工具则把验证好的底层环境复制到其他机器。
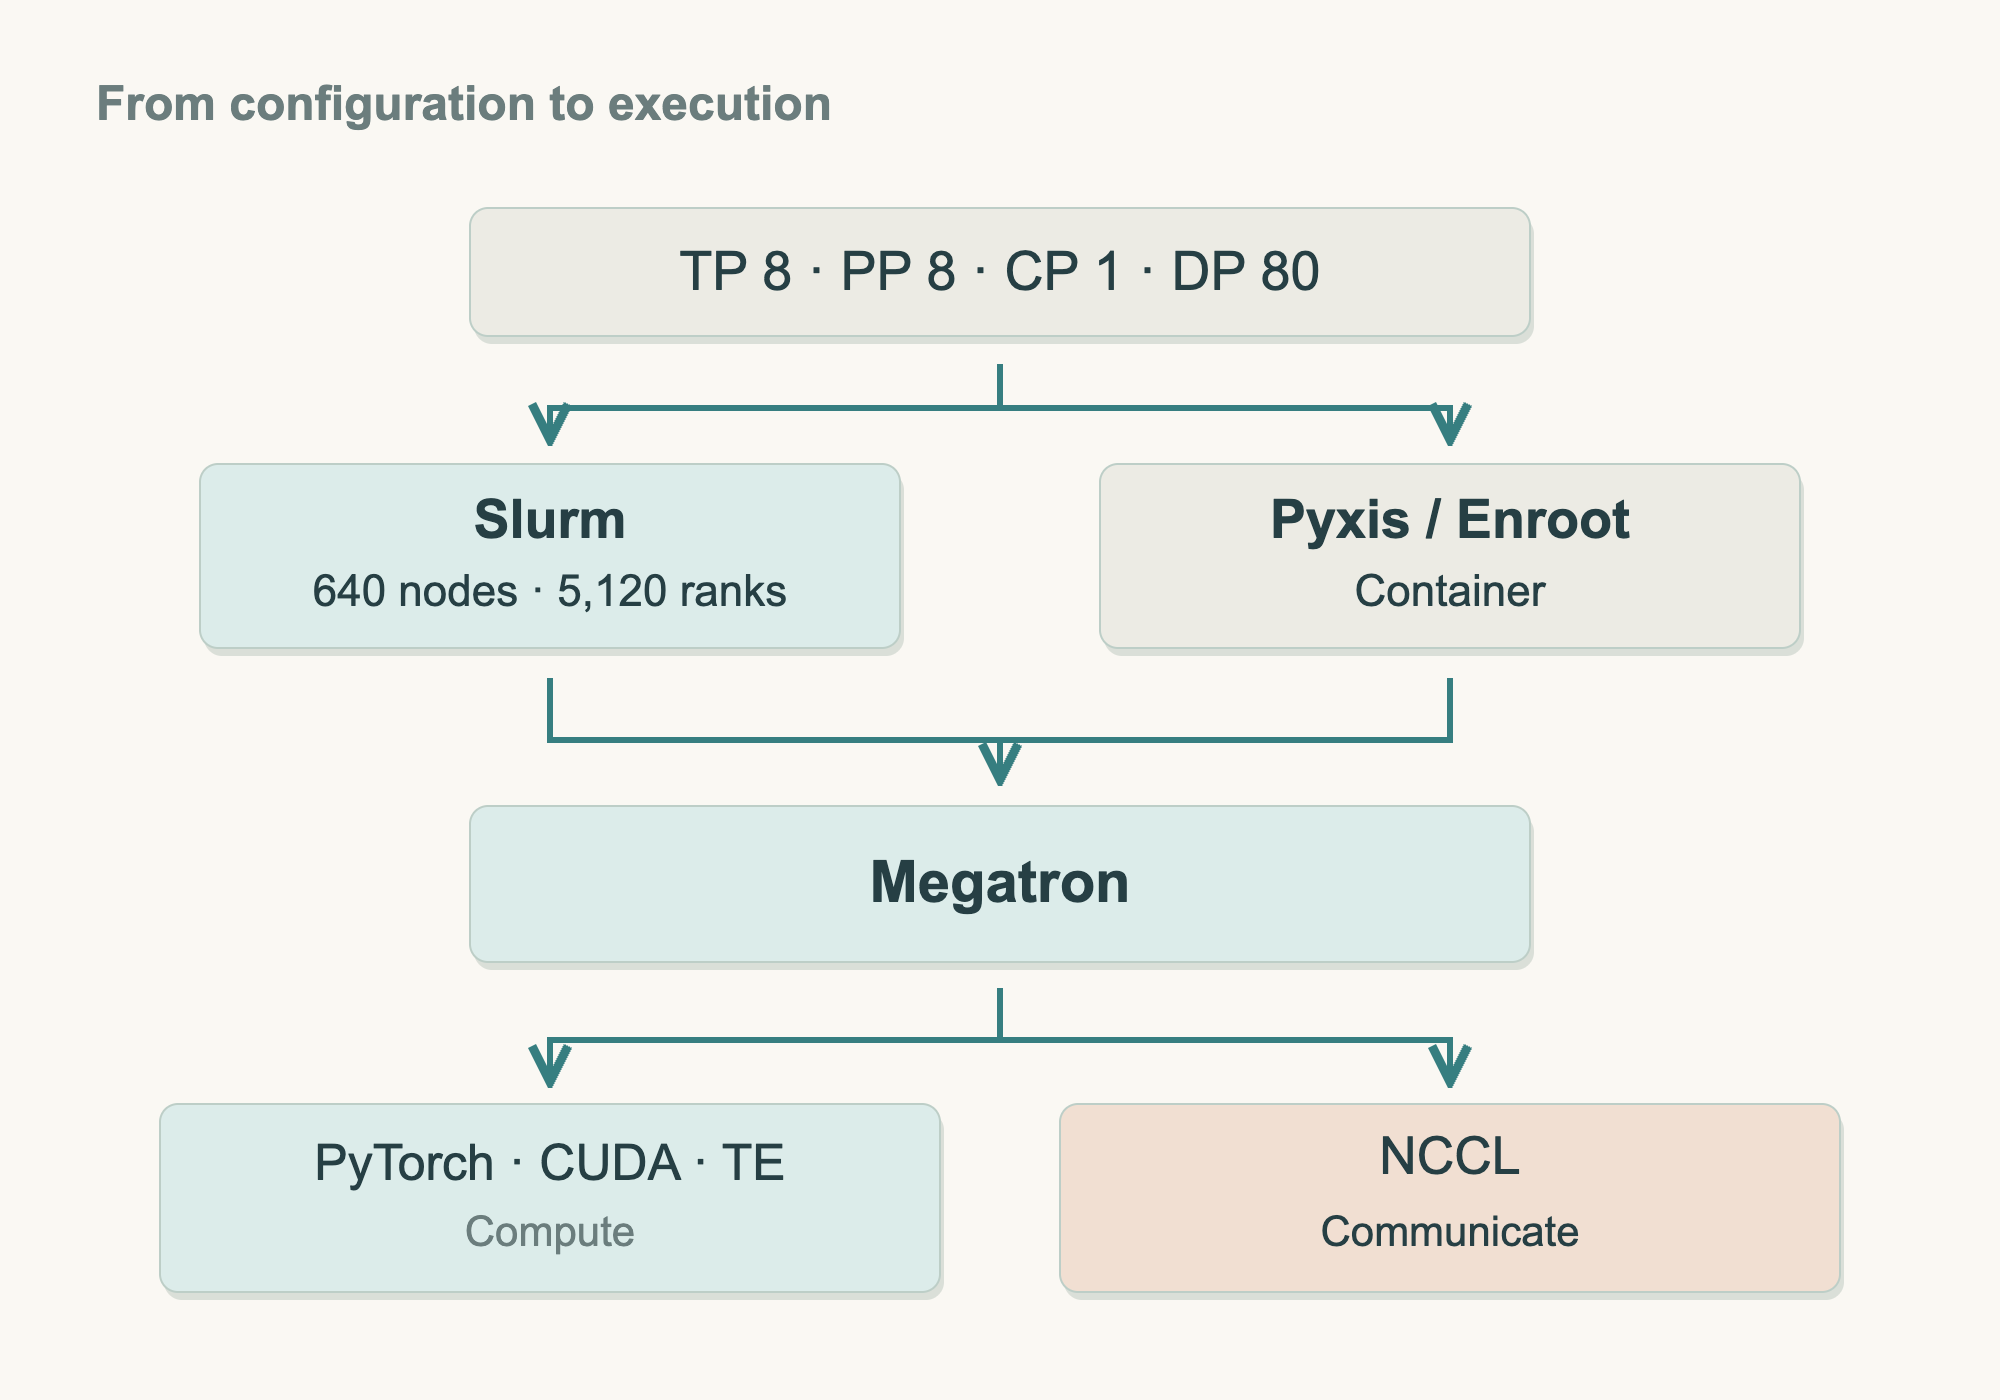
这张图先解决“谁负责什么”。从上往下,任务经过各层,最后抵达GPU。图里的具体并行配置留到下一篇拆开,现在先让最底下的第一台机器可用,再把整条路接起来。
先让这台机器认得8张GPU
第一件事是让操作系统认出八张卡。我选择服务器厂商支持的Ubuntu组合,把操作系统、内核、GPU驱动和机内互连管理服务一起固定。Ubuntu管理硬件与程序,其余软件让它正确使用B200及卡间连接。
自己定制Linux当然更自由,组件与更新节奏都能自己选,兼容验证也随之归到自己身上。这批硬件统一,最需要的是稳定的配套关系与明确的维护路径。我接受厂商版本约束,把精力留给训练和批量运维,让640台从同一组合开始。
支持清单要落实到所购型号。NVIDIA的DGX OS便在官方支持表里列出DGX B200要求;我们的整机也要拿到对应清单、安装介质与重装说明,采购验收时确认具体版本。
有预装系统,就对清单逐项核版本;重装也沿同一清单进行。Ubuntu的apt负责下载、安装软件并记录依赖,我把它指向厂商或NVIDIA官方仓库,指定软件与版本。后面自动装机,复制的就是这些明确步骤。
NVIDIA驱动部署文档也推荐包管理器来管理驱动分支、升级与配套软件。独立.run安装器提供更自主的安装过程,我们选择固定仓库与软件包,换取可重复执行、可查记录的安装路径。
驱动安装并重启以后,先运行nvidia-smi点名:八张B200应全部出现,状态正常。接着看卡之间的路。B200使用第四代NVSwitch,按官方文档和整机支持组合装Fabric Manager与NVLink Subnet Manager,核服务与链路。认到卡、卡能互联,两件事都通过,底层才准备好。
现在系统能看到八张卡,也有可检查的互连状态。下一道障碍随之来到:写在Python里的训练,靠谁交给这些卡执行?
内核:操作系统中直接管理硬件资源、协调程序运行的核心部分。
GPU驱动:让操作系统与GPU交互的软件,负责显存、计算任务和设备管理等工作。
包管理器:下载、安装和更新软件,并记录软件依赖关系的工具。
apt是Ubuntu使用的包管理器。
Fabric Manager:管理服务器内GPU互连的软件服务,在B200系统上与NVLink Subnet Manager配合工作。
NVLink Subnet Manager:参与管理B200服务器中NVSwitch连接的软件服务。
卡能看见了,Python怎样交给它计算?
训练程序要读token、算预测、根据误差调整参数。Python写下这个过程,真正的大量乘加与求导,还需要一套计算工具接手。
我选PyTorch来组织模型计算与梯度,它调用CUDA运行时和GPU计算库,再经驱动交给B200。矩阵乘法便可使用cuBLAS的实现。这条调用链先记成:
训练程序 → PyTorch和GPU计算库 → 驱动 → B200
逐个装也能凑出这套工具,但版本配合要自己逐项处理。这里选官方训练容器为起点,直接带来配好的组合。容器是程序启动时使用的独立软件环境,镜像是创建环境的模板;同一镜像交给下一台,训练程序也有了同样的起点。
PyTorch:帮助我们定义模型、执行计算并求出梯度的基础框架。
CUDA:NVIDIA的GPU计算平台。这里主要使用它的运行时和计算库,让程序在GPU上完成计算。
容器镜像:包含程序及其依赖软件的模板,启动容器时用它创建运行环境。
参考机先用Docker启动容器。不过外面能认到GPU,里面也得能访问。于是按NVIDIA Container Toolkit安装指南,在驱动与Docker准备好以后安装配套工具,配置GPU访问,再进测试容器点一次八张卡。
这一进一出,也把职责分开了。底下的系统与驱动负责硬件,里面的Python、PyTorch和计算库负责程序。训练代码更新,主要换镜像;宿主系统继续按确认过的组合维护。
但容器里能计算,教材还在外面的存储上。把第十三篇的教材目录与检查点目录接进来,读入、保存才有了实际路径。容器关掉或换版本,文件仍留在外部存储,训练进度也跟着保住。
Docker:构建容器镜像和启动容器的工具。本计划用它构建镜像,并在参考服务器上排查问题。
NVIDIA Container Toolkit:帮助容器使用服务器上的NVIDIA GPU设备和驱动能力的工具。
基础计算有了,谁把训练流程接起来?
基础计算有了,500B训练还要把模型构造、保存、恢复与多卡协作连起来。我选择Megatron Core以及同一版本Megatron-LM训练代码来组织,再加入项目自己的实现与配置。
从官方发布版本的构建配方开始,保留它选定的基础容器与依赖,在上面加入项目改动,最后生成自己的训练镜像。这样每一项改动都有出处,官方组合也能原样追溯。
开发中临时补一个Python包很方便,推广到640台之前,却必须把它写回构建配方,生成新镜像。沿上游的uv与锁定文件管理依赖,uv sync --locked按已锁定结果准备环境;声明对不上就停下来报错,版本关系先在构建时处理好。
手装的自由留在开发阶段,正式环境由统一构建交付。代价是维护构建记录、版本与验收,收益是所有机器拿到同一份可以核对的产物。
Megatron Core:用于大模型训练的组件库。训练程序把其中的模型、并行计算和检查点等组件连起来,完成一次训练。
锁定文件:记录项目实际选择了哪些依赖版本的文件,用来重新建立相同的依赖组合。
展开看:这次采用的版本与构建方法
截至2026年10月29日,本计划保留已发布的Megatron Core 0.19.2,使用同一标签下的官方容器构建文件。该文件以nvcr.io/nvidia/pytorch:26.06-py3为基础镜像,并提供锁定依赖。
26.06容器说明列出的组合是Ubuntu 24.04、CUDA 13.3.0和PyTorch 2.13.0a0+8145d630e8。Ubuntu在这里指镜像内的用户空间,宿主机仍按服务器厂商支持列表选择。Megatron的配方把NCCL设为2.30.7-1+cuda13.3,并处理其他依赖。
具体做法是取回Megatron-LM仓库,切换到core_v0.19.2,记录git rev-parse HEAD的完整结果,使用该版本docker/Dockerfile.ci.dev中名为main的阶段构建依赖环境,再把同一提交的训练代码加入最终项目镜像。项目镜像可以命名为shan-training:mc0.19.2-cu13.3。NVIDIA的基础镜像名称保持原样。
安装前按容器发布说明核对CUDA的驱动要求、服务器厂商支持范围与已知问题。构建时保存基础镜像摘要、构建参数、锁定文件、构建日志和最终镜像摘要。这里选定的是待验收基线;完成单机计算、通信和恢复测试后,再把它推广到其他服务器。
展开看:pip、venv、Conda和源码安装分别做什么?
pip负责安装Python包;venv为项目建立独立环境,让不同项目的包分开保存。Conda也能按环境定义管理软件。这些工具都能用于项目开发。我们的正式构建沿用上游的uv和锁定文件,集中维护一套依赖定义。
增加一个包时,要检查它会不会连带替换官方组合中的PyTorch或其他核心依赖。驱动仍由服务器的系统安装流程管理。
如果需要修改训练实现,或编译自己的GPU算子,就取回指定版本的源码,用匹配的CUDA Toolkit和编译工具构建,再把产物加入项目镜像。安装步骤写进Dockerfile,源代码记录完整提交号,这样另一位同事可以找到相同代码和构建方法。
Python虚拟环境:为一个项目单独保存Python包的环境。
算子:程序中的一项计算,例如矩阵乘法。它的GPU实现通常称为kernel。
CUDA Toolkit:NVIDIA的GPU开发工具集,包含编译器、运行时和相关工具与库。
Dockerfile:记录容器镜像构建步骤的文件。
代码提交号:标识代码仓库某次修改的唯一编号。
跑一小段训练,看看能不能接着学
装完并不等于这套软件能一起工作。我拿一个小模型和固定材料,把最初那个目标拆成四道检查,先让故障在第一台暴露出来。
先查设备:宿主机里八张B200正常,进入容器再查一次,两边的设备对应得上。这样能把硬件访问的问题与模型代码分开。
再查计算:单卡先算一个已知答案,然后让小模型完成预测、梯度与更新,核数值、梯度和参数变化。正式要用的BF16、注意力与融合算子一起放进这个小任务,避免小样例跳过了真正需要的计算路径。
BF16:一种每个数占2字节的浮点格式。本计划用它完成一部分训练计算,同时保留需要更高精度的状态。
一张卡能算,八张卡怎样证明能合作?我给它们依次放上1到8,让各卡求和并拿到同一个答案。八张卡最后都应得到36。
这次交换叫AllReduce,由NCCL执行。程序指定需要交换的数据,通信库负责完成求和等操作,机内和跨机都能用,职责见NCCL官方说明。小数字对上以后,再换几种大数据量,留下耗时和日志,后面的机器就有参照。
AllReduce:合并各个参与设备上的数值,再让每个设备得到合并结果。这里使用求和。
NCCL:NVIDIA的GPU通信库,负责求和、广播和收集等数据交换操作。
最后把保存与恢复接进来。从第十三篇的目录读取真实格式token,安排100步,第50步写检查点,然后关闭进程。新进程只拿这份存档,继续到第100步。
换进程是关键。参数、优化器、步数、随机状态与读取位置都必须从存档回来,材料顺序与学习率才能接上。PyTorch保存加载教程也把仅存权重与完整恢复训练区分开来。
再连续跑100步作对照,固定环境、材料顺序和计算设置,比较关键状态与数值差异。允许误差在测试前确定,浮点与部分GPU算子对逐位一致性的影响按PyTorch可复现性说明核对。
四关通过,第一台才成为参考机。设备、计算、通信、恢复都有证据以后,再向其他机器推广。500B实际吞吐和整份7TB存档写入,后面放大规模时继续验。
640台一起用,谁分机器、谁启动任务?
参考机上可以直接启动程序。640台就不同了,谁拿哪一组机器,什么时候启动,坏一台怎么办,都得有统一入口。复制环境之前,先把任务的指挥权安排好。
我选Slurm。训练任务先申请整组节点,分配后启动、监控进程,小测试也进队列申请资源,并按账户记使用量。Slurm官方说明里的分配、并行作业管理与排队,正对应这些工作。
这640台的主要任务是长时间同步训练500B:许多GPU同时计算,又持续交换结果。Slurm围绕这种并行作业组织资源,适合这批专用机器。控制服务、节点服务、记账与故障处理,一起纳入运维交付。
Kubernetes也可以组织分布式训练,优势在于把训练、在线推理与多团队应用放进统一平台;已有成熟团队时,这些能力值得复用。我们的主集群专做训练,混合在线服务收益较小,因此选定Slurm,集中维护这一条路线。计算和通信的实际速度,仍由任务测试回答。
Slurm:给集群任务分配计算资源,并负责排队、启动和监控的调度系统。
Kubernetes:管理容器化工作负载的平台,可以组合服务、批处理和分布式训练能力。
机器分好,容器还需要真正启动。这里用Pyxis把容器任务接入Slurm,Enroot提供运行环境。用户提交任务后,选定镜像就在分配到的节点上运行。
参考机上的Docker负责构建和排错,正式运行走Slurm、Pyxis、Enroot,所以同一套验收也要在这条生产路径上重跑。GPU、目录、通信、恢复都确认以后,源镜像按摘要固定,导入产物另存校验值,再分发给节点。
Pyxis:把容器任务接入Slurm的插件。
Enroot:将容器镜像导入并运行成用户空间环境的工具。
镜像摘要:根据镜像内容生成的标识,用来确认取回的是同一份镜像。
展开看:其他平台怎样做,我们要维护什么?
Kubernetes可以配合Kueue管理队列和配额,用Kubeflow Trainer组织分布式训练。GPU Operator可以自动管理GPU驱动、Container Toolkit、设备插件和监控等组件。管理员还需要安排这些组件的配套升级,以及共享集群的权限、配额和隔离。
这条路线的收益是复用统一的应用平台;维护范围也包括所选的队列、训练控制器、网络和设备集成。本计划选Slurm,并把主机软件交给统一装机配方管理。
Apptainer也是支持GPU的容器运行工具,适合采用它作为统一运行环境的计算中心。我们的生产环境使用Pyxis和Enroot,集中维护一种启动方式。Pyxis官方说明要求它匹配部署的Slurm版本,这项关系也要进入版本清单。
Kueue:Kubernetes上的排队与配额管理系统,决定任务何时获得运行资格。
Kubeflow Trainer:在Kubernetes上组织分布式模型训练的组件。
GPU Operator:在Kubernetes上自动管理GPU相关软件组件的工具。
让每台机器按同一份配方安装
启动方式定了,下一步得让每台空机器变成这台参考机。要复制的有两份成果:底层系统与项目训练镜像。
镜像从团队仓库取,底层则用一份自动装机配方。厂商支持Ubuntu组合仍保持不变,安装由PXE、Ubuntu autoinstall、cloud-init、Ansible依次接手:
| 装机过程 | 使用的工具 | 做完得到什么 |
|---|---|---|
| 机器从网络取得启动程序 | PXE | 空盘机器也能进入安装流程 |
| 按配置安装Ubuntu | Ubuntu autoinstall | 磁盘和操作系统准备好 |
| 设置每台机器自己的信息 | cloud-init | 机器名、网络和用户准备好 |
| 安装固定软件与配置服务 | Ansible | 同一套驱动、服务及运行工具,并留下执行记录 |
这几个步骤分别能对照Ubuntu autoinstall、cloud-init和Ansible官方说明。通用配方保留一份,地址与身份逐台提供,验证后的系统镜像和包也归档,重装与回退就有了原路。
也比较过集成平台。NVIDIA Base Command Manager把节点、镜像、分发、更新集中起来,可以减少自行串接工具的工作,同时增加这套平台的维护与集成责任。
这里最终选独立工具组合,由20人团队中的基础设施人员和集成商共同交付装机配方。版本、配置、验收一起审查,安装编排、日志与记录也明确列入交付。工具之间需要我们接起来,但每台机器都有同一份权威配方可追查。
PXE:让服务器通过网络取得启动程序的方法。
cloud-init:按配置完成系统初始化的工具。
Ansible:按配置批量安装软件、设置服务和管理服务器的工具。
下一次升级,怎样留住这次的可用环境?
推广先从一小批开始。每台核设备、计算、机内通信,失败节点修复复验后再加入,再逐批扩展。跨机通信与整体性能进入下一层集群验收,安装问题就不必等640台一起启动才发现。
日后升级仍走这条路。代码或依赖有变,重新构建镜像,参考机先跑短训练和恢复,再到小批,最后逐步切换。旧镜像留在仓库,出现问题仍能找回上一版。
版本名还不够,还要记摘要。Docker文档说明同一标签可以指向更新内容;标签便于人读,摘要才能固定具体产物。一次更新生成一个新产物,记录新摘要,验过再用,环境的变化也就可追溯了。
内核或驱动更新则安排维护窗口,保留能恢复的系统镜像和软件包,重启重新验收。训练环境回退时,还要检查旧版本能读准备恢复的检查点,软件回去了,进度也得接得上。
最终交给下一位工程师的是可重做的流程:按记录装系统,取指定镜像,接教材与存档目录,跑同一套测试,再依据通过条件判断结果。
展开看:环境交接时留下哪些记录?
| 记录 | 用来做什么 |
|---|---|
| 硬件、固件、操作系统、内核和驱动版本 | 确认机器与底层软件条件 |
| 配套管理服务、容器运行工具、软件包与配置 | 重装相同的系统和生产运行环境 |
| 训练代码提交号、依赖锁定文件和构建配方 | 找回当时的程序及构建方法 |
| 源镜像摘要、导入产物校验值 | 取回同一份训练环境 |
| 训练配置、分词器、样例数据及校验值 | 重跑相同的训练样例 |
| 启动命令、目录位置、通过条件和测试日志 | 让同事重新执行并判断结果 |
| 上一版环境、检查点兼容性记录 | 在更新出现问题时恢复训练 |
能重复安装、核清内容、自动验收、在更新后恢复,这些才让2026年的这套装机方法适合长期训练。第一台的成功有了复制办法,故障也有回程。
但参考机上跑通的还是小模型。把它换成500B,仅一份权重就超出单卡容量。软件现在有了,下一步要告诉它们:同一个模型,怎样分给5,120张卡?
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。