
[从零训练一个
上一篇把机器、电与散热放进同一张机房方案。图上三个厅已经连起来了,真正走到机柜背面,连线却必须回答一个更具体的问题:手里这一根光纤,究竟插哪个口,另一头又去哪里?
我先拿出一张服务器接线单。八卡B200整机、ConnectX-7网卡、400G InfiniBand交换机、光模块与光纤,都沿用第三篇的选择。先接通一个出口,认清每个零件,再把这条规则扩到一柜、一组和三个厅。这样到最后,安装人员可以按表找实物,下一位维护的人也能把线原样接回去。
一根线的另一头,究竟要去哪里?
第一条线还没动手,先在总图上找目的地。厅A放pod1、2,厅B放pod3、4,厅C放pod5和核心。每个pod是一组接入网络的服务器。厅A的一台机器想把结果送到厅B,可以沿这条路:
服务器 → leaf → 本组汇聚 → 核心 → 对方组的汇聚 → leaf → 服务器。
Leaf紧挨服务器,汇聚把同一组leaf接起来,核心连接不同组。同pod两台机器挂在不同leaf时,经过本组汇聚即可转向;跨pod才继续走核心。图上每一段箭头,下面都要落成模块与光纤。我从最底下的服务器开始接,让这条路逐段有着落。
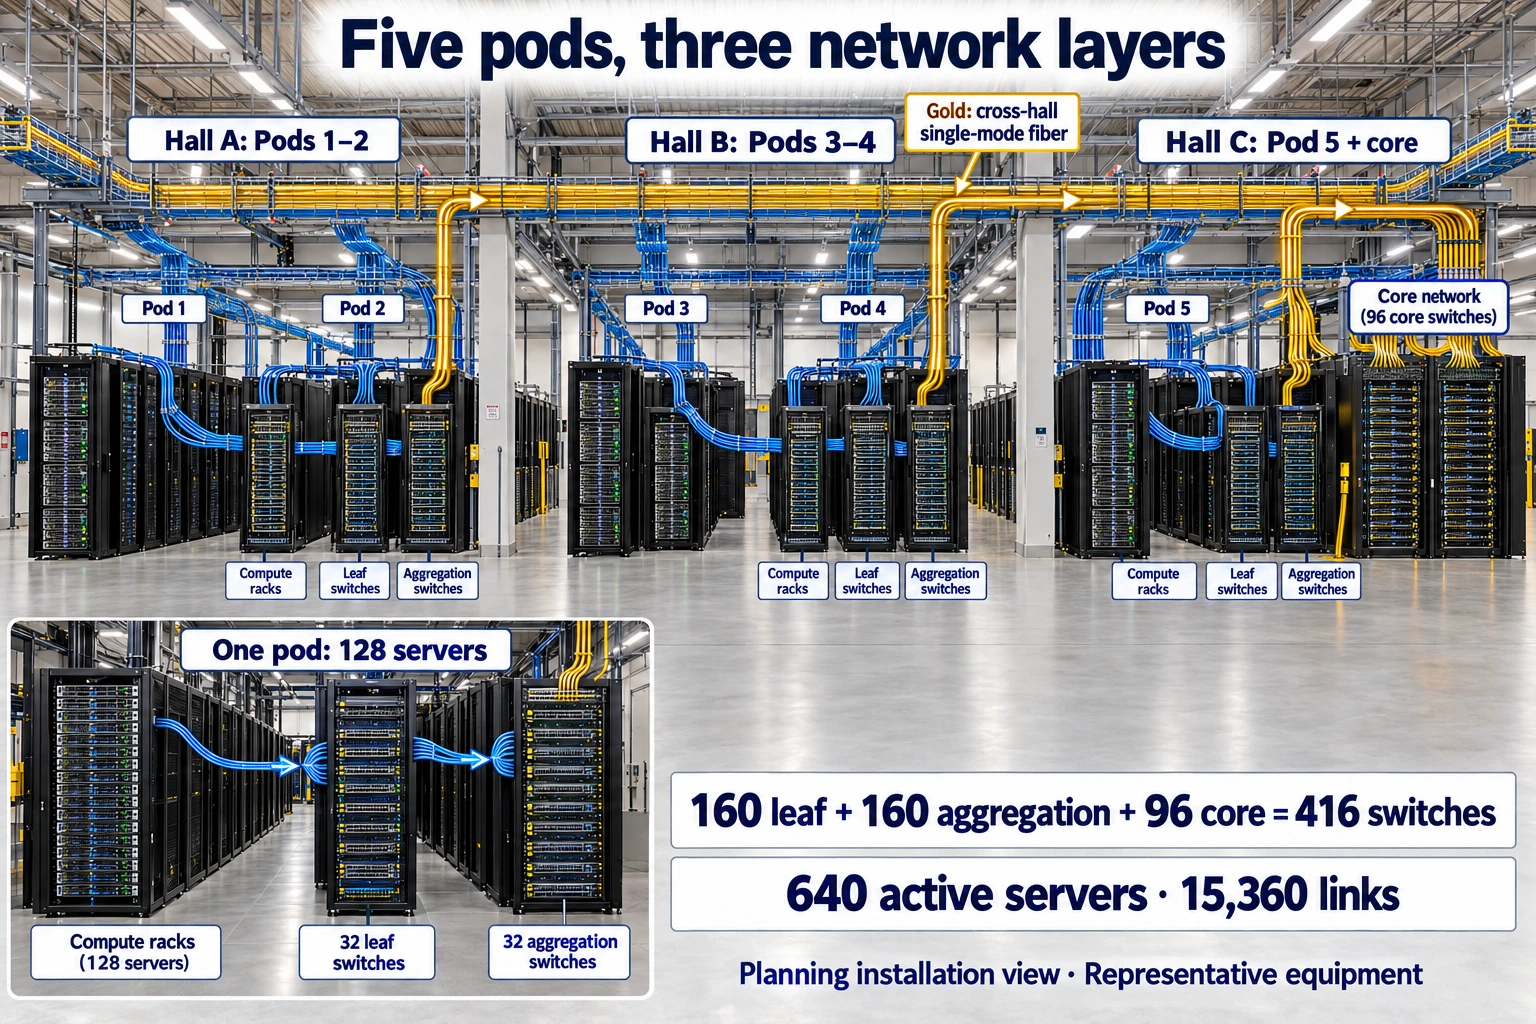
代表性机柜和线槽展示实际安装层级,完整数量按标注和接线表读取。点击图片查看原图。
哪些连接随整机交付,哪些要现场装?
打开交货清单,先分清收到的是什么。B200是GPU型号,订单里买的是装有8张B200的Exxact整机,处理器、内存、电源、风扇和扩展槽一起装在可上架的机箱里。
八张GPU之间也要交换结果,但这段连接在机器里面。HGX B200平台用NVLink与NVSwitch完成它,整机商交付时应已装配、验证。现场先验收这部分,再接机箱外的网络,工作边界由此分开。
NVLink:GPU之间的高速互联技术。本文用于同一台服务器内部。
NVSwitch:在机内连接多张GPU的交换部件。
外面的出口有没有配齐,则要回头核订单。第三篇给每台安排8张单口ConnectX-7,料号MCX75310AAS-NEAT。网卡、安装槽位、模块和测试要求一同写进整机订单,由供应商集成,到货再按清单检查八个训练出口。
网卡(NIC):安装在服务器里、让它连接外部网络的部件。
现场安装网卡也有明确流程:合格人员按整机手册断开全部冗余供电,落实防静电,再拆装。把安装工作交到正确的人手里以后,接线表继续负责回答装好后的卡在哪里、接口通向哪里。
走到机箱背面,找到训练网卡的出口
绕到机箱背面,一排接口挤在电源和风扇之间。只看孔的形状,很容易认错。先把后板分区标出来,训练线才有明确入口。
Exxact公开资料的完整后板图还不够清晰。我先用同为8U、配B200的ASRock 8U8X-TURIN2 SYN B200官方手册把部件关系对起来:采购仍为Exxact,最终槽位逐项映射到交付图。
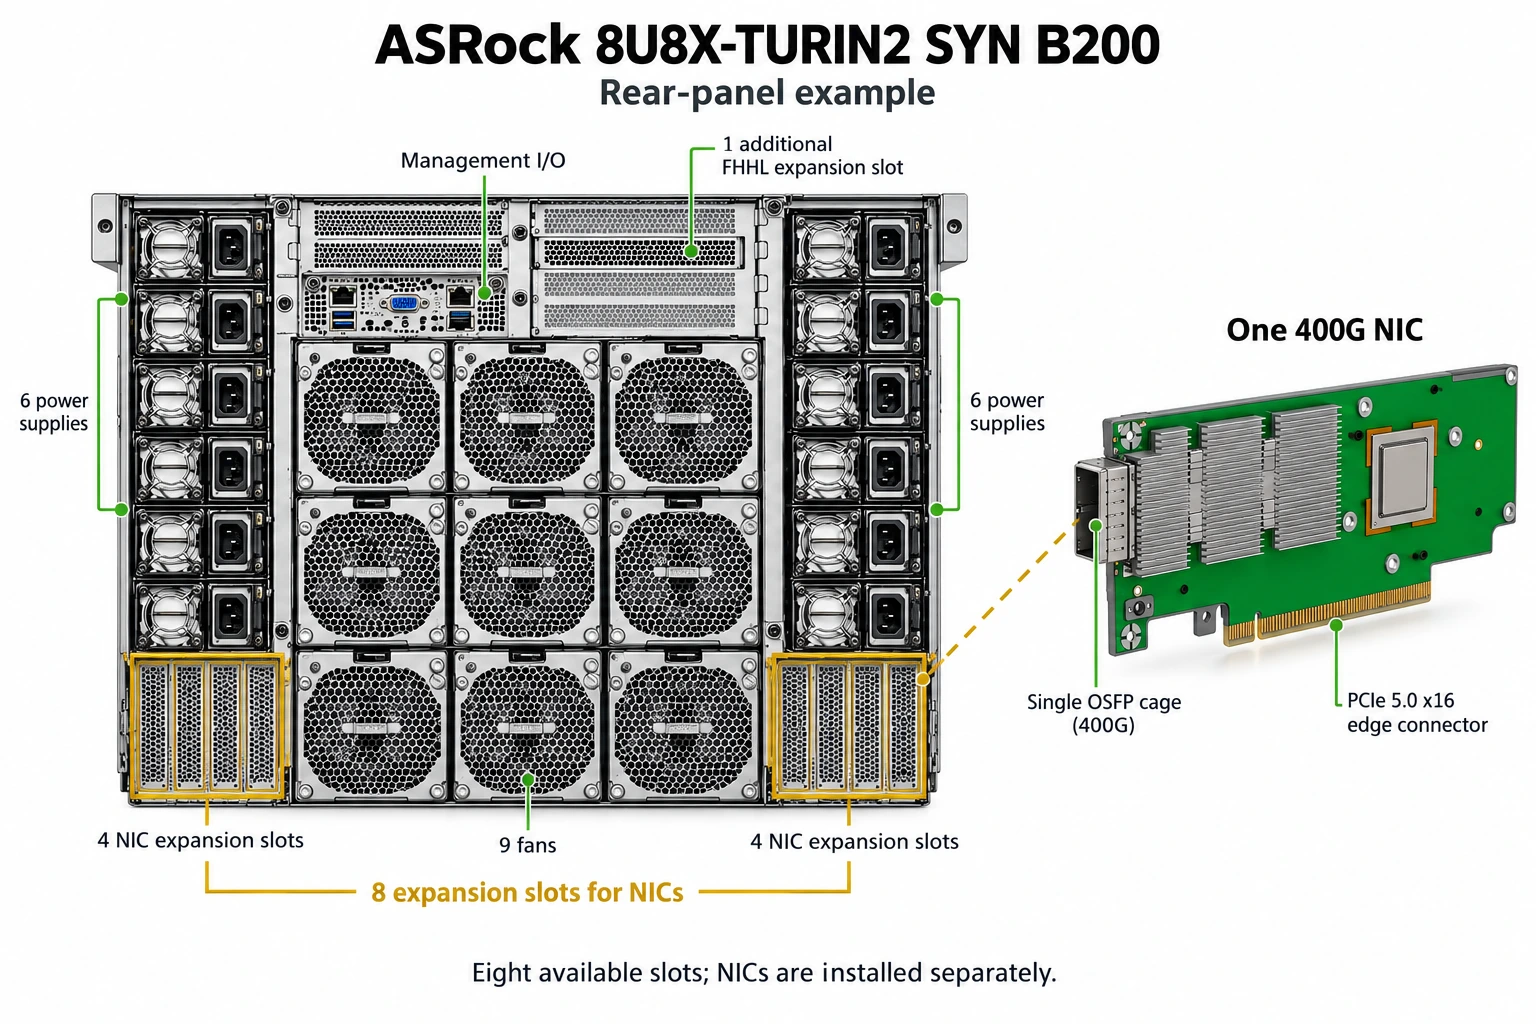
按ASRock官方手册绘制的结构对照,项目采购型号仍为Exxact。点击图片查看原图。
在这张ASRock后板上,两侧是电源,中间是风扇,上方有管理接口,底部两侧各有4个扩展卡位置。网卡金手指插入机内PCIe连接,带接口的挡板固定在机箱开口,装好后网络口就露在后方。空槽只是位置,卡是否真的装进去了,还得对照交货清单。
PCIe扩展槽:服务器内部用于安装网卡等扩展部件的位置。卡装好后,它的外部接口通常通过机箱挡板露出来。
找到接口以后,接线单先分两栏:管理口供运维查看状态、远程控制,训练口承担GPU的大量数据交换。两栏分别记录各自网络,熟悉的管理接口就不会被误接成训练出口。
八张训练网卡逐一贴上NIC1至NIC8。编号先对应真实槽位,再记录卡的标识。这里的1至8是项目标签,不能凭直觉从机箱左边一路数;厂家槽位与项目编号必须在表里对得上。
一张网卡、一只模块、一根光纤,先把第一条线接出来
我沿接线单找到第一组第1台P1-S01,停在NIC1后面。这个单口400G网卡露出一个OSFP插槽,先装入MMA4Z00-NS400模块,再把配套多模光纤插进模块前面的MPO-12/APC口。于是三层关系清楚了:卡装在机器里,模块装在卡上,光纤接模块。
光模块:把设备电信号转换成光信号、并接收光信号的部件。模块插进设备接口,光纤插进模块。
MPO:把多根光纤集中在一个插头里的连接器。本文按配套要求使用MPO-12/APC规格。
400G:这里表示每个网络连接标称每秒4000亿比特的传输能力。
另一头轮到交换机。选用的NVIDIA Quantum-2 MQM9700-NS2F面板有32个OSFP插槽,每槽插入一只双口MMA4Z00-NS模块,引出两条独立400G连接。原来清单里的64个逻辑端口,就是32只双口模块这样展开的。
OSFP:本文光模块及其插槽使用的外形规格。选模块时还要匹配具体网络、速率和距离。
逻辑端口:网络中独立使用的一个连接端点。本文一个交换机插槽中的双口模块提供两个这样的端点。
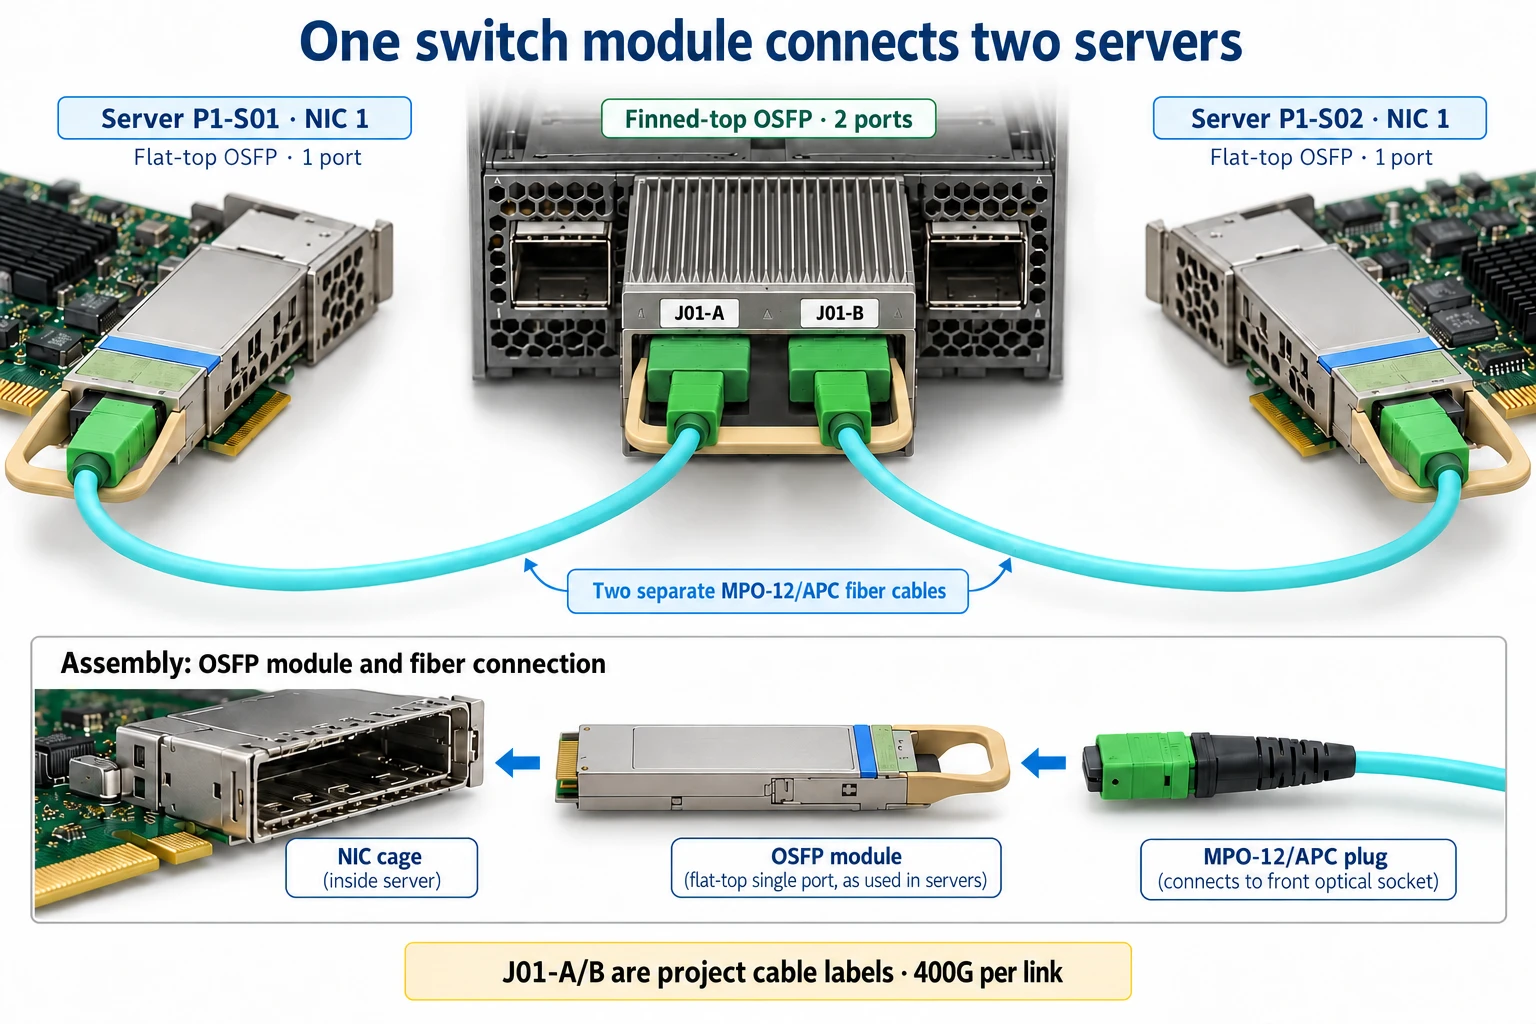
配套部件装配示意;每条光纤独立连接一个400G端口。点击图片查看原图。
第一条线现在能沿实物指出来了:P1-S01的NIC1装单口模块,接一根光纤;另一头接交换机P1-L01某只双口模块的一个口,剩下半边给另一台服务器。服务器侧是平顶单口模块,交换机侧是带散热鳍片的双口模块,各按设备配套安装。
“某只模块”还不足以交付。我把32个面板插槽标成J01至J32,双口的两半再记A、B,同时让集成商映射到厂家编号和管理软件端口名。纸上写J01-A,现场标签与软件查询就必须指向同一个端点。
插接前还要核两端模块与光纤型号,按厂商方法检查、清洁端面,再按方向插入并确认锁定。连接器与极性一起匹配,才算这条线配对。线缆余长收进指定理线位置,弯曲半径按规格留足,维护时也有空间取放。
把第一条线复制成一柜、一个pod
第一条有了,接下来才敢复制。上一篇每柜两台,一柜就有16个训练出口。先给每台机器独立编号,再展开同样的接线规则,数量增加以后仍能回到具体机器。
640台主机分成5个pod,每pod128台。再把128台拆成四个32台接入组,每组配8台leaf。P1第一组的32台,NIC1都去P1-L01,NIC2都去P1-L02,直到NIC8;下一组换成L09至L16。四组排完,每pod32台leaf,八个出口各有明确去向。
Pod:本方案里128台训练主机与两层本地交换机组成的分组。
Leaf:直接连接服务器的下层交换机。
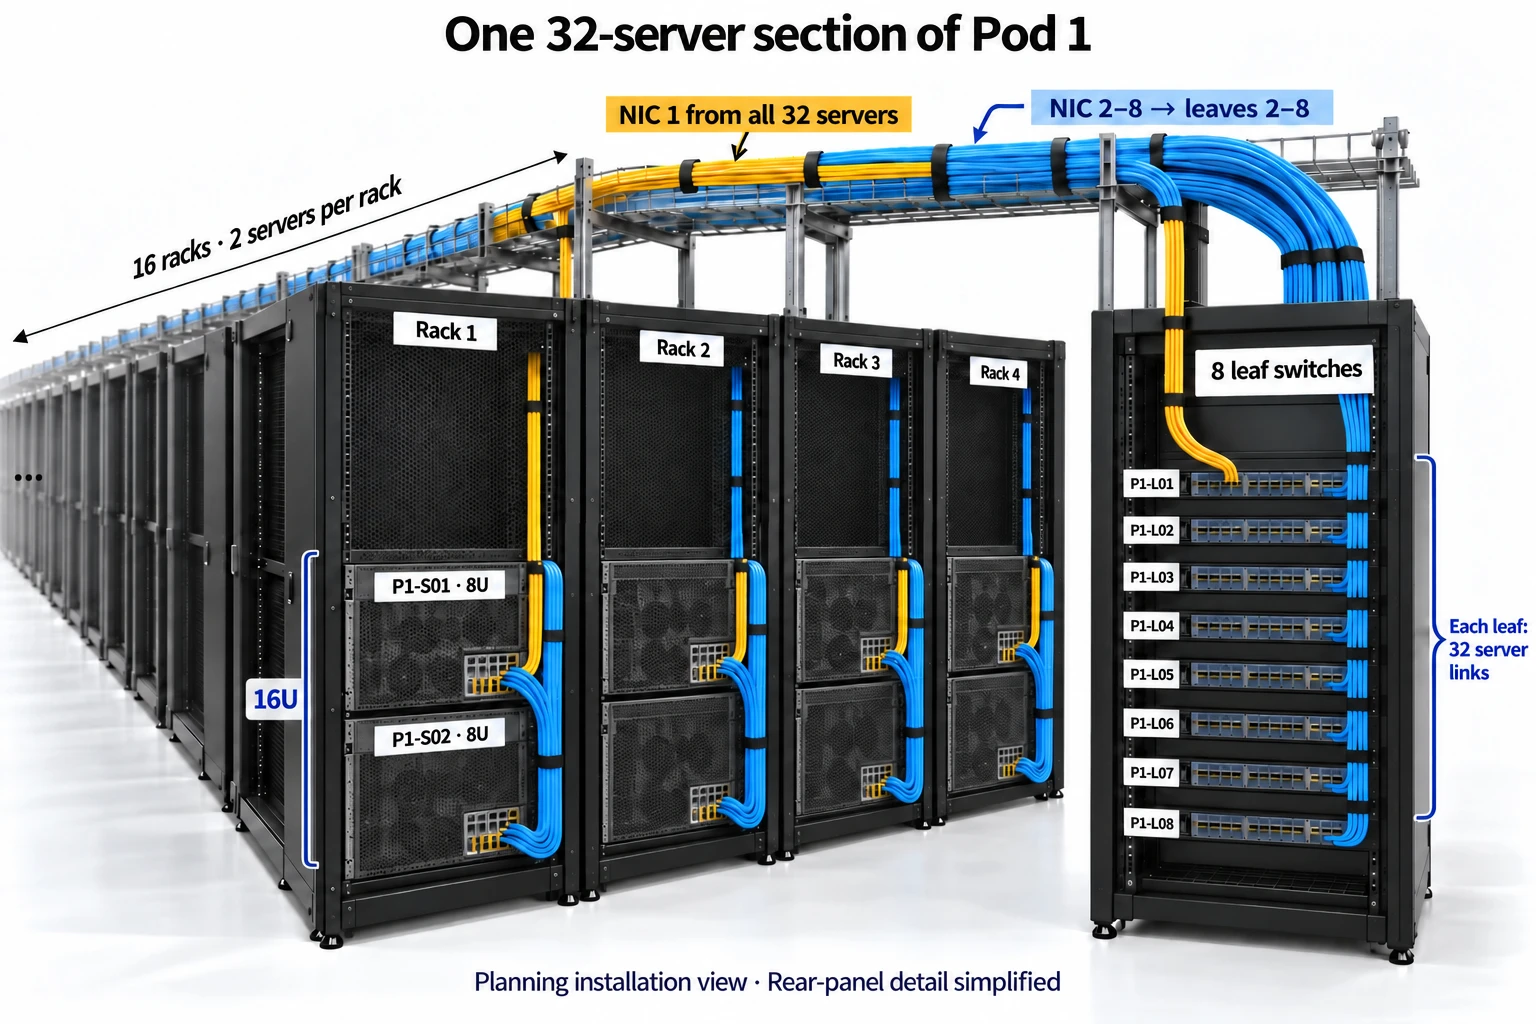
图保留一个32台接入组的局部布线关系。它是一个pod的四分之一;设备后板简化绘制。点击图片查看原图。
沿NIC1这一路数,一台leaf收32根服务器光纤,每只双口模块接两根,J01至J16恰好够。于是几条最容易核对的记录可以直接写出来:
| 线号 | 服务器一端 | Leaf一端 |
|---|---|---|
| P1-S01-N1 | P1-S01 NIC1 | P1-L01 J01-A |
| P1-S02-N1 | P1-S02 NIC1 | P1-L01 J01-B |
| P1-S03-N1 | P1-S03 NIC1 | P1-L01 J02-A |
| P1-S32-N1 | P1-S32 NIC1 | P1-L01 J16-B |
| P1-S01-N2 | P1-S01 NIC2 | P1-L02 J01-A |
这张小表扩到五个pod,就是160台leaf、5,120条服务器接入线。20台备用机各有8张网卡,替换主机时复用原位置线路。采购因此有660 × 8 = 5,280张网卡,正常训练在线的是640 × 8 = 5,120个出口,备件与在线数量在这里分开。
接上汇聚层,再把五个pod接到核心
服务器端都接了,同组不同leaf的机器还缺一段连接。每台leaf后16只双口模块剩32个400G口,分别接本pod的32台汇聚A01至A32,一台对一台各一根。到这里,128台主机才有了本组相互到达的路径。
汇聚交换机(aggregation):本方案中连接本pod各台leaf、再向核心上行的中间层交换机。
跨组继续往上接核心。核心分32组,每组3台,共96台。第7台汇聚只接第7组C07-1、C07-2、C07-3,32个上行口按11、11、10分配,其他组照这个规则展开。
核心交换机(core):在这份三层方案中连接不同pod的上层交换机。
三台这个数来自端口账。五个pod各送来32条,一组核心需接160条。分给三台64口设备,实际各用55、55、50口,既放得下,也让五个pod得到相同的连接份额。
展开接线位置:J插槽、A/B接口与核心端口分配
要找一根具体线,就从插槽继续往下展开。P1-L01的J17-A去A01,J17-B去A02,一直排到J32-B去A32。汇聚前32口则按leaf编号接回L01至L32,所以L01到A07,两端正是L01 J20-A与A07 J01-A。
核心还要照顾跨厅距离。厅A的pod1、2,厅B的pod3、4是远端,厅C的pod5在本厅。面板先排四个远端,再排本厅,让同只双口模块两半采用同一距离类型。55口核心先接44个远端、再接11个本厅;50口的则先40、再10。
| 线号 | A端计划位置 | B端计划位置 |
|---|---|---|
| P1-L01-A07 | P1-L01 J20-A | P1-A07 J01-A |
| P1-A07-C07-1-01 | P1-A07 J17-A | C07-1 J01-A |
| P1-A07-C07-2-01 | P1-A07 J22-B | C07-2 J01-A |
| P1-A07-C07-3-01 | P1-A07 J28-A | C07-3 J01-A |
| P5-A07-C07-1-01 | P5-A07 J17-A | C07-1 J23-A |
表里最后一行从厅C的pod5来,所以排在核心44个远端口之后。项目标签随后一一映射到厂家端口,再由管理软件核对。相邻层有并行连接时,路由也要配合这张图;NVIDIA网络管理说明介绍了这类拓扑,供应商据此落实路由与全规模验收。
数完端口再数线:服务器到leaf、leaf到汇聚、汇聚到核心,各5,120条,共15,360条。对应160台leaf、160台汇聚、96台核心,合计416台。总数现在可以反过来校验采购表,漏一层就会立刻对不上。
为什么双口模块要买12,832只?
双口模块还得按实际设备向上取整。Leaf与汇聚64口全用,每组核心55、55、50口分别需要28、28、25只,共81只;32组有2,592只。前两层10,240只加上去,全网12,832只。64个半口仍空着,却不能把模块削掉半只,采购数必须保留它们。
厅内和跨厅的线,要选两套配件
数量对上了,线长又成了新问题。服务器到leaf所用多模组合,OM4最远50米、OM3为30米,按官方兼容资料选配。量路程不能只量两柜之间直线,线槽升降、转弯、配线与维护余长都要加进去。
从厅A、B去厅C,换成NVIDIA MMS4X00-NM双400G单模模块这一跨厅候选。官方距离500米,包含规定的两处配线面板。两端模块、单模光纤、连接器与极性成套确认,再请运营商沿真实路由核长度与损耗,超出允许条件的路重新设计。
四个远端pod共4,096条跨厅线,两头各用双口模块承接,合计4,096只长程双口模块。剩下8,736只短程双口和5,120只服务器单口,对应11,264条厅内线。厅内也要按实际距离量,超过多模条件的一样换长程,部件表随路由更新。
| 部件 | 本方案数量 | 选型与交付要点 |
|---|---|---|
| ConnectX-7训练网卡 | 5,280张,已含在660台整机采购配置 | 指定料号并核实际槽位、PCIe连接和整机测试 |
| MQM9700-NS2F交换机 | 416台 | 160 leaf、160汇聚、96核心 |
| 服务器单口模块MMA4Z00-NS400 | 5,120只 | 网卡端使用平顶单口型 |
| 短程双口模块MMA4Z00-NS | 8,736只 | 交换机端,距离与实际光路匹配 |
| 长程双口模块MMS4X00-NM | 4,096只 | 跨厅交换机间候选,两端成对核验 |
| 厅内光纤链路 | 11,264条 | 按实际长度和模块组合备料 |
| 跨厅单模光纤链路 | 4,096条 | 计入配线面板、损耗、极性与维护余长 |
配件齐了,装机方向也要回到上一篇的冷、热通道。MQM9700-NS2F从电源端进风、光口端出风,所以电源侧朝冷风,光口侧朝热风。理线与维护空间顺着这个方向安排,不能为了接线方便把风路反过来。
两批服务器沿第三篇位置表到场,共享核心与存储先配合首批联调。先验已到主机和对应路径,第二批继续按同一张表补齐。管理、存储另走各自网络,训练端口已经逐个分配完,不再从这里挪用。
最后把实物与软件对一次。现场核机器、网卡槽位、模块、端口和线号,软件核八卡识别、连接、速率与错误指标。NVIDIA链路验证和拓扑对照可以把实际线路对回清单。测试再从两机扩到pod、跨pod、全集群,检查有效带宽与故障恢复,图上的每条路径都有相应记录。
下一位维护的人,靠什么把线接回去?
做到这里,交给下一位工程师的不能只有一张总图。拿最初那条P1-S01 NIC1至P1-L01 J01-A来说,需要四张互相指向的表:先认卡,再备料,再找线,最后查验证。资产标签先展示位置,到货后填入真实槽位、序列号与测试结果。
| 表 | 解决的问题 | 这条连接怎样呈现 |
|---|---|---|
| 网卡与槽位表 | NIC1究竟是哪张卡 | P1-S01、NIC1、指定料号,以及待记录的真实槽位/序列号 |
| 模块与光纤表 | 现场要备哪些部件 | 一只服务器单口模块、一只leaf双口模块的A口,以及对应光纤 |
| 两端接线表 | 线的另一头在哪里 | P1-S01 NIC1 → P1-L01 J01-A;两端补厂家及软件端口名 |
| 验收记录 | 谁检查、结果如何 | 记录端点照片、模块标识、实际速率、错误计数及通信测试日志 |
这四张表放进下面的英文PDF,也把汇聚到核心的跨厅连接展开。计划400Gb/s链路速率与现场训练吞吐分栏记录,两种指标各自对应实际含义。整份交付清单沿同一格式覆盖15,360条链路。
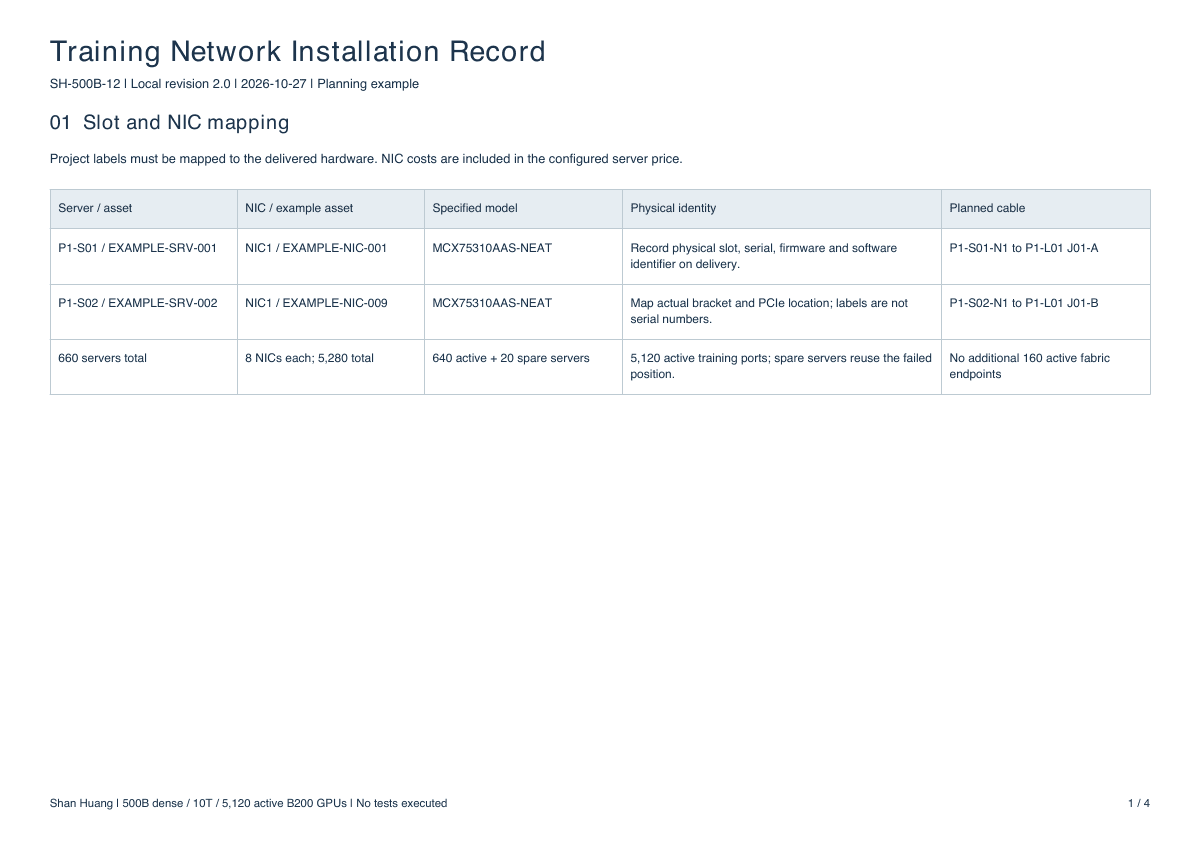
再回到机柜背面,NIC标签已经能一路找到模块、光纤与交换机端口;更换设备,也能按表接回原位置。这些线让GPU终于有路交换结果。下一处瓶颈在另一个方向:训练材料从哪里持续送来,训练进度又往哪里保存?它们需要一套独立的存储与供数安排。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。