
[从零训练一个
并行分工画好了:5,120张GPU分成80组,每组64张卡,合作计算一份500B模型。我回到训练配置,启动之前还有几格空着:每次读多长,读多少再更新,更新时把参数改多少。
机器怎样分工已经清楚,模型怎样一步步学,还得靠这些数字接起来。
我先拿一条材料走一遍。它装进多大的窗口,分给哪一组,读完之后留下什么反馈,最后怎样变成一次参数更新。沿着这条路,10T的总计划才能落到每一次学习上。
先决定模型一次能联系多远
这是一篇6,000个token的教程。前面定义数据结构,后面才给完整用法。窗口设成4,096,教程得切开,后半段看不到前面的定义;调到8,192,整篇有机会一起进入计算,前后的关系也保住了。
我先把主训练序列长度填为8,192个token。它给普通长文和代码片段留出更连续的上下文,也把第一轮的显存与计算测试限制在8K这个尺度。这里的8K是8,192个token,中文字符数和英文单词数要经过第九篇选定的分词器才能换算。
上下文接起来了,计算量也跟着长。以普通因果Attention为例,长度为L的一条序列有L×(L+1)÷2个允许读取的位置关系。4,096时约839万个,8,192时约3,356万个,一条序列里的关系约为四倍。如果总token量相同,8K序列的条数只有4K的一半,Attention关系总数仍约为两倍。这是注意力部分的计算变化;整个模型还有大量其他计算,整次训练时间要实测。
短材料按第九篇的规则装进窗口:独立文档各看自己的前文,位置编号在文档边界重新开始,文末结束标记参与学习,跨文档预测和填充位置不计入损失。同一项目中相互关联的文件,则先组成一个训练单元。把两篇无关短文装在同一条8K序列里,并不会自动让它们变成一篇长文。
看到这笔代价,我把首轮验收也收在同一范围:先确认8K能在TP8、PP8、CP1和序列并行的组合下运行,再评估更长窗口能改善哪些任务。以后加入长上下文阶段,就从累计10T里划出相应份额,重新核对计算预算。
序列长度:一次模型计算接收的token位置数量。本文主训练每条有8,192个输入位置。
损失:衡量模型预测与训练目标差距的数值。训练用它计算参数应怎样调整。
一组先读一条,再把多条的结果积起来
教程装进8K窗口,进入64张卡共同承载的模型。前向算出预测,反向沿着误差追溯,最后留下各个参数的梯度。梯度描述的是:在当前参数附近,把某个参数稍微调大或调小,损失会怎样变化。我先让每组每个微批只收一条序列,把微批量设为1。
只收一条,是为了给计算产生的中间结果留出显存。第十五篇算过主状态的显存,但每条材料经过模型时还会产生中间结果。微批量从1改成2,同一微批里就有两条序列,通常会增加这部分显存压力。500B模型最终的层数、宽度与阶段边界确定以后,还要测各阶段峰值;首轮从1条开始,便于把这笔新增开销看清。
一条读完,梯度已经有了,参数暂时留在原位。接着读下一条,把反馈积起来,连续处理24个微批。80组各自这样做,再把贡献汇总,完成一次更新:
每组每微批1条 × 每组24个微批 × 80组 = 每次更新1,920条序列
1,920条 × 每条8,192个输入token = 每次更新15,728,640个输入token
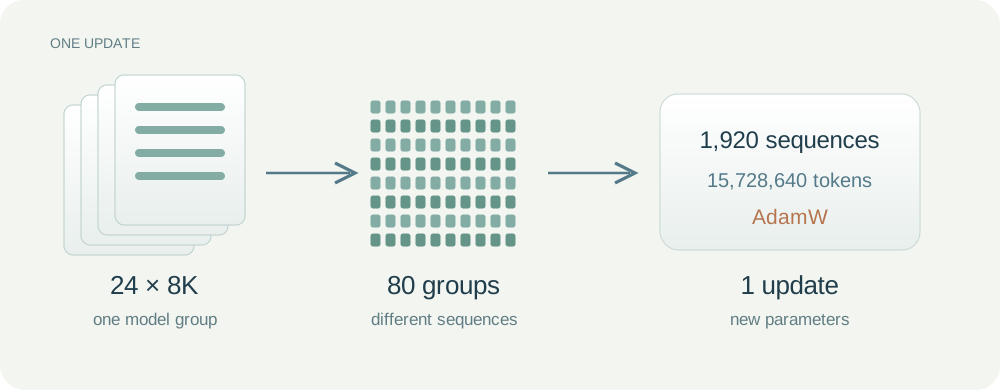
图中一张薄片代表一条8K序列。先沿左侧看一组连续读24条,再看中间的80组把各自贡献汇总,最后走向右侧的一次更新。组内64张GPU合作计算同一批材料,所以这里乘80。更新完成后,下一批材料才使用新参数。
计算器上得到15,728,640个token,这记的是装满窗口时的输入量。第九篇规定的边界预测有些不计入损失,因此参与预测学习的位置会略少。日志同时记录输入token、参与损失的token和填充数量;累计10T沿用前文的材料读取口径,填充不充当训练材料。同一份材料再次读取,仍然再记一次。
微批量:一组模型副本在一次流水线小批计算里接收的序列条数。这里为1。
梯度累积:连续处理多个微批,积累它们的梯度,然后统一更新参数。
全局批量:一次参数更新所用的全部序列条数。这里为1,920;乘以序列长度,才得到token数量。
为什么先选接近16M,而不是8M或32M?
24填进去以后,我又把它改成12和48作比较。这个数同时牵动两件事:一次更新收集多少反馈,以及8段流水线能否连续工作。
一个具体参照是Meta公开的Llama 3 405B训练方案。它使用过4M、8M和16M token的批量,随训练进度扩大,8K是其中一个主训练长度。这个规模与我们讨论的500B较接近,能帮助我们选第一组对照值。我们仍要用自己的数据和模型比较学习效果。
按80组、每微批1条、每条8K换算,三档都能分得整齐:
| 一次更新的输入量 | 全局序列数 | 每组微批数 | 理想流水线空闲占比 |
|---|---|---|---|
| 7,864,320,约8M | 960 | 12 | 约36.8% |
| 15,728,640,约16M | 1,920 | 24 | 约22.6% |
| 31,457,280,约32M | 3,840 | 48 | 约12.7% |
最右边的空闲比例,还得沿着流水线算一次。8个阶段之间有7次接力,公式里的7就来自这里。先想象只有两段:第一段开始工作时,第二段要等第一小批送过来;最后一小批送入以后,也还要留时间让后面的工作完成。这里把一个阶段处理一个微批的前向与反向耗时合计,记作一份时间。增加到8段,启动与收尾的额外时间,在阶段耗时均匀的理想模型里合起来相当于7份这样的时间。处理24个微批,就把总时间近似看成24份有效工作加7份启动收尾,空闲比例因此是7÷31,约22.6%。
最后一列只看普通非交错流水线的启动与收尾:假设8个阶段计算均匀,忽略通信与其他等待,空闲占比近似为(8-1) ÷ (微批数+8-1)。它用来解释微批增加的方向,实际利用率要从时间线读取。
8M这一档更新更频繁,但每次只有12个微批,启动和收尾占得较多。32M这一档更容易让流水线保持工作,可是读完相同的训练量,参数更新次数只有16M的一半;新增材料能否带来相应收益,要看验证结果。
看过两头的代价,我先留下中间的15.73M:它把理想空闲占比从8M档的约37%降到约23%,同时保留32M档两倍的更新机会。接着让8M与32M参加对照,比较读过相同token后的验证损失,以及到达相同验证表现需要的时间。若8M用更少材料就学到相同程度,它较低的机器效率也可能值得;若32M学习曲线接近且吞吐更高,就有扩大批量的依据。
2026年8月的OpenEuroLLM研究把学习率和批量一起研究,并区分不同训练阶段。这提醒我们,改变批量以后,要重新比较学习率。本文先保持一套固定批量的配置,建立可复现的对照,再决定是否引入随进度增加批量的安排。
流水线空泡:部分阶段因启动、收尾或等待而暂时没有计算任务的时间。
验证损失:在预先留出、没有用于更新参数的材料上测量预测误差,用来观察学习效果。
读完以后,谁来把参数改掉?
80组的梯度汇总到一起,一批材料的反馈齐了。它们告诉程序:参数往哪个方向改,预测误差会下降。接下来要把这些反馈真的写进参数,否则下一批材料仍在用原来的模型。
这一步交给优化器。它接收当前参数和梯度,按照一套规则算出新参数。有些规则直接使用当前梯度,有些还记住前几次的变化。我们选择哪一种规则,就决定了模型怎样把每批材料带来的反馈变成一次学习。
我先挑一个参数,把最简单的梯度下降算给自己看。旧值是0.5,这批材料给出的梯度是+0.2。正号表示,在当前位置附近,把这个参数调大,会让损失上升;要沿着损失下降的方向走,就应该把它调小一点。
先用0.01作为这次演算的学习率:
新参数 = 旧参数 − 学习率 × 梯度 = 0.5 − 0.01 × 0.2 = 0.498
如果梯度是-0.2,同一条规则会把参数增加到0.502。梯度给出当前位置的变化信息,学习率控制这次沿着它走多远。步子太大,可能越过合适的位置;步子很小,每次改善也可能很有限。一次更新以后,我们再让模型处理下一批材料,重新计算损失和梯度,继续这个循环。
500B模型里,参数就是网络中数量庞大的这些数字。它们共同决定Attention、前馈网络等部件怎样计算。优化器按张量批量更新这些数字,整个模型便一点点改变了预测方式。
梯度:损失对各参数变化的局部敏感程度。每个分量描述对应参数稍作改变时,损失变化的方向和快慢。
反向传播:从损失出发,沿模型的计算关系反向求出各参数梯度的过程。
优化器:使用梯度等信息,按选定规则更新模型参数的算法。
学习率:控制一次参数更新整体幅度的系数。
为什么还要记住前几次的梯度?
沿着这条规则往后走,问题又出现了。材料每批不同,梯度也会波动:这个参数刚减小,下一批又让它增大。只听眼前这一批,更新容易来回摇摆。
我希望连续出现的方向能够留下来,偶尔一次相反反馈只改变其中一部分。保留近期梯度的加权平均,就能做到这件事。这类利用历史方向的做法叫动量。它相当于把几次反馈放在一起看,再决定这一回往哪里走。
方向稳一些以后,另一种差别还在:不同参数的梯度尺度差别很大。一个参数的梯度常在0.1附近,另一个常在10附近。使用相同学习率直接相乘,后者的改动就容易大很多。我们希望更新幅度能参考每个参数自己的历史尺度。
Adam把这两件事结合起来。它为每个参数保存两份记录:一份是近期梯度的加权平均,帮助形成更新方向;另一份是近期梯度平方的加权平均,开平方后提供尺度。更新时,用前者除以后者,再乘学习率。长期梯度较大的参数有较大的尺度分母,梯度较小的参数也按自己的尺度调整。
这样,每个参数都有了按自己历史调整的更新值,整个训练仍要设一个学习率。历史记录负责调整各参数之间的更新尺度,学习率控制这一步的整体幅度。两者在同一次更新里配合工作。
动量:把近期梯度方向积累起来,让参数更新同时参考过去反馈的方法。
Adam:利用梯度与梯度平方的历史记录,为各参数调整更新方向和尺度的优化器。
从Adam到AdamW,我们这一轮选择什么?
继续看参数本身,数值幅度也需要照看。训练时,我们可以对指定权重施加一点持续向零收缩的作用,让它们在拟合材料的同时,受到幅度约束。这种做法叫权重衰减。
AdamW把这项收缩与Adam根据梯度进行的更新分开处理。梯度历史用来决定怎样降低预测损失,权重衰减则按另外一个系数作用于权重。这样我们能分别设置两项作用,也更容易检查实际更新规则。
到这里,我把AdamW填进首轮配置。它能利用不同参数的梯度历史调整更新,所选Megatron工具链已有对应的分布式实现,前两篇的显存和存档方案也已经为这些历史状态留出空间。沿着这一套继续,参数更新、状态分片和恢复训练就能用同一份配置验证。
算法定了,回头填控制整体步幅的学习率:峰值先用0.00008,即8×10⁻⁵。这个数量级参考前面405B公开方案的峰值,用来确定500B首轮试验的中心点。前面0.01只用于演示最简单的梯度下降;这里的0.00008才是500B方案的峰值候选。
接着用一个参数核对更新。Adam经过历史记录、尺度调整与初期修正后,给出的更新值为0.5,乘上峰值学习率,这次梯度更新项就是0.00008×0.5=0.00004。每个参数都有自己的历史记录,因此会得到自己的更新值。
更新的除法中还放入ε=10⁻⁸,避免分母过小。权重衰减系数先用0.1,它与当前学习率相乘后,决定这次收缩多少。在峰值学习率下,单看衰减这一项,乘数是1-0.00008×0.1=0.999992。继续用参数0.5演算,收缩后是0.499996;再减去刚才Adam算出的0.00004,得到0.499956。这就把两部分放在同一次更新里看清了。PyTorch的AdamW算法说明列出了这一更新顺序。偏置、归一化等参数按明确的参数分组规则处理,启动日志要记录哪些组参与衰减。
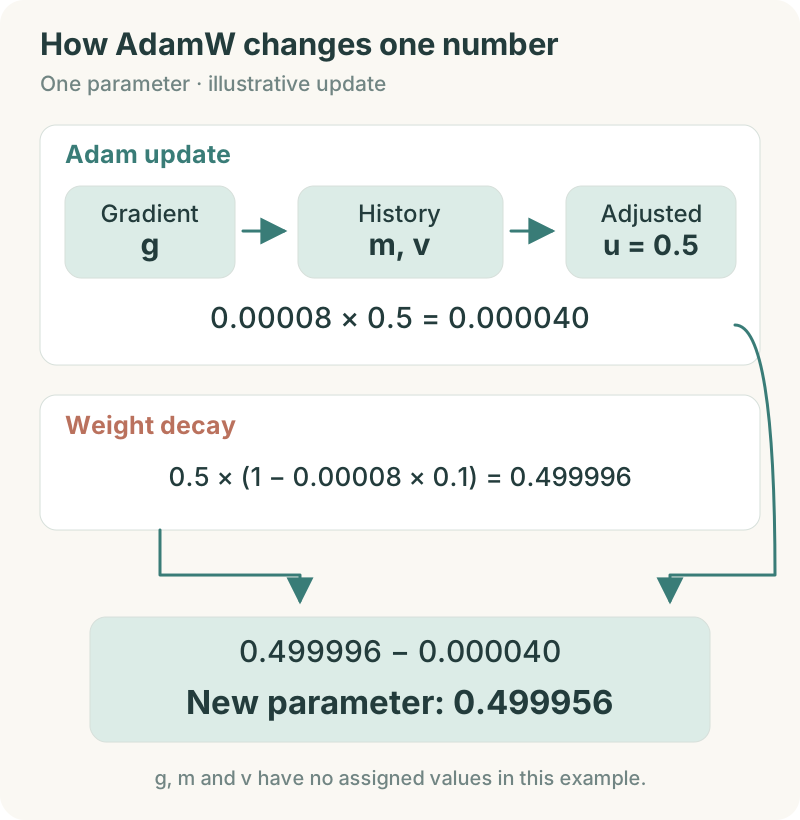
图里只跟踪一个参数,所有数值都是单个数字。g是当前梯度,m、v是两份历史记录,u是经过历史与尺度调整后的更新值。例子给定u=0.5,g、m、v没有指定数值。沿两条线往下看:一条算出要减去的0.00004,另一条把旧参数0.5收缩为0.499996,两者汇合得到新参数0.499956。
两份历史记多久,怎样设置?
两份历史记录也写成明确的起点。第一份用β₁=0.9,第二份用β₂=0.95:每次分别保留上一份记录的90%和95%,再加入当前梯度及其平方的新贡献。按约1÷(1-β)理解记忆长度,它们大致对应10次和20次更新的尺度;正式Adam还会修正训练初期记录偏小的问题。我们选这组值,让近期变化能在几十次更新内反映出来,再观察梯度和验证曲线。
这些选项对应Core 0.19.2的优化器配置。其中β₂=0.95和衰减0.1是本计划主动设置的试验值,配置文件会完整保存。
遇到某一批反馈突然很大,还需要一道限制。我把梯度裁剪阈值设为1.0。比如整个模型梯度的范数为2,裁剪会把梯度整体缩为一半,方向保持相同;范数为0.5则保持原值。这个范数在模型所有相关分片上按实现正确汇总,不能让每张卡各自把自己的部分裁到1。日志保留裁剪前范数和裁剪频率,帮助判断学习率是否过激或某批材料是否异常。
AdamW:利用梯度历史调整各参数更新尺度,并把权重衰减单独应用的优化器。
权重衰减:训练时让指定权重向零逐步收缩,以约束其幅度的方法。
梯度范数:把许多梯度分量合起来,衡量整体大小的数值。
梯度裁剪:梯度整体过大时按比例缩小,用于限制单次更新的输入幅度。
学习率也要有起步和收尾
峰值填好了,却不能从第一步就一直用到底。模型刚初始化,历史记录也刚建立,我先给起步留一段预热:学习率从0线性升到0.00008,随后逐渐降低。
这段起步先安排约20B输入token,占累计10T的0.2%。按当前批量,把它向上对齐到1,272次完整更新,就是20,006,830,080个输入token。约1,300次更新留给起步,再用峰值前后的损失、梯度和参数变化判断是否足够。若接近峰值时仍持续恶化,就从同一个初始状态比较40B预热或较低峰值。预热比例本身不能替我们判断稳定性。
起步以后,学习率沿余弦曲线下降,在预算末尾降到0.000008,也就是峰值的十分之一。这样后期仍会更新,但步幅逐渐缩小,便于把前面学到的方向细化。我们选择余弦,是因为这次已有明确的累计训练预算,起点、峰值和终点可以直接写成一条完整曲线。
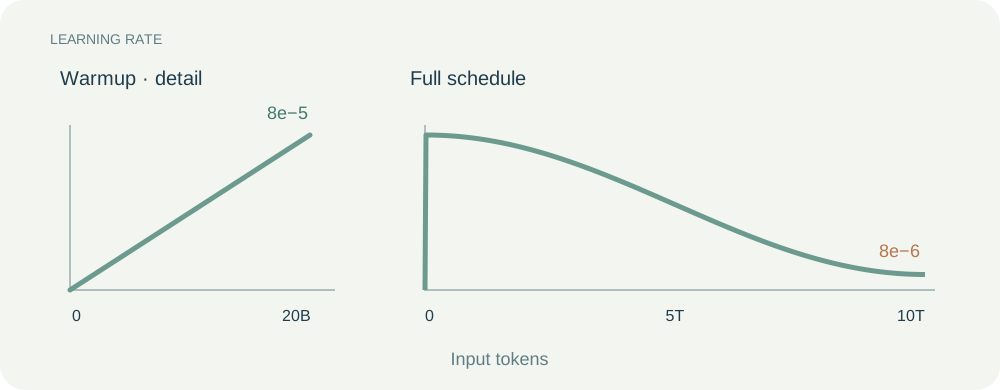
图的横轴是累计输入token,纵轴是学习率;左边单独放大预热段,右边显示完整训练过程。图表示计划中的调度,不是已运行的损失曲线。在预热后的剩余进度走到一半时,学习率恰好处于峰值与终值的中间,约0.000044。
固定版本的调度实现支持线性预热与余弦下降。为了让批量变化后仍能按已读材料定位,我们用样本数配置调度:一条样本固定为8,192个输入token。20.00683B对应2,442,240条样本。日志再把它换算成token,读者看到的进度就与前面的材料账一致。
预热:训练开始时,用一段进度把学习率从较小值提高到目标峰值。
学习率调度:规定学习率怎样随训练进度变化的规则。
这些选择,怎样交给前面装好的软件?
纸上的一次更新已经完整,该把它交给第十四篇装好的软件了。Slurm、容器和Megatron各在自己的位置,第十五篇的并行分工也已配置,更新沿着这条路径接进去:Slurm给任务分配机器,torchrun启动GPU进程,进程运行Megatron-LM的训练入口;这个入口读取我们的参数,创建模型与优化器。以后每批材料的梯度汇总完成,训练循环就调用优化器更新参数,再推进学习率调度。
顺着这条路径,AdamW与学习率都填进Megatron训练参数。Slurm继续负责机器和任务的安排。我们把这两层各自要做的事写清楚,就知道修改学习算法时应该改哪份配置。
配置里两个相似的名字让我多检查了一遍。AdamW决定“给定梯度和历史,参数怎么变”;--use-distributed-optimizer决定“这些历史状态怎样分到多张卡保存和更新”。前者是更新算法,后者是第十五篇的分布式实现。两项同时启用,既沿用AdamW的规则,也让80个数据并行副本分担状态存储。
在Core 0.19.2中,启动参数写的是--optimizer adam。该版本的构建代码会读取默认开启的decoupled_weight_decay,把它传给Transformer Engine的FusedAdam。这个开关为真时执行AdamW;Transformer Engine 2.18的实现也明确写出这一对应关系。名字里的Fused表示把更新计算合并执行,减少GPU启动开销。
核对实现以后,把决定写成这组设置:选择adam入口,保留该版本开启的解耦权重衰减,设置衰减系数0.1,再开启分布式优化器。参数的拼写由框架接口决定,实际更新规则由这几项共同决定。
分布式优化器:在多张设备之间分配优化器状态及相关更新工作的一种实现方式,可以承载AdamW等具体更新算法。
把这些选择放进同一份配置
再从头走一次,这份配置里的每个数字都有了位置:每个模型组读24条8K序列,80组共同形成1,920条的全局批量;梯度汇总、裁剪后,AdamW按当前学习率更新参数;下一批再使用新参数。主状态沿用上一章的BF16计算权重、FP32累计梯度和分布式优化器。
| 配置项 | 首轮计划值 | 这项决定什么 |
|---|---|---|
| 模型与训练材料 | 500B稠密模型,累计约10T输入token | 本轮规模与总工作量 |
| 并行分工 | TP8、PP8、DP80、CP1,启用序列并行 | 5,120张GPU如何合作 |
| 序列长度 | 8,192 | 一条材料的读取窗口 |
| 微批量 / 全局批量 | 1 / 1,920条 | 每组累积24个微批后更新 |
| 优化器 | AdamW,β₁ 0.9、β₂ 0.95、ε 10⁻⁸ | 怎样使用梯度历史 |
| 权重衰减 / 梯度裁剪 | 0.1 / 全局范数1.0 | 控制权重与梯度幅度 |
| 学习率 | 从0预热至8×10⁻⁵,余弦下降至8×10⁻⁶ | 每次更新的整体步幅 |
| 预热量 | 2,442,240条,即1,272次更新 | 约20B输入token的起步段 |
| 精度与状态 | BF16计算权重,FP32梯度与Adam状态 | 承接第十五篇显存口径 |
这里的正式运行还要接上前面几篇选定的模型结构、分词器、数据路径与文档边界处理。层数和隐藏维度会决定实际500B模型与各阶段的显存,我们在模型配置冻结后,把这些文件的版本与本表一起保存。
展开看:怎样写成Core 0.19.2的参数?
第十四篇采用Core 0.19.2同标签的Megatron-LM训练入口和容器配方。下面列出交给Megatron-LM训练入口的参数片段,与已有的模型、数据和运行参数一起传入。它描述本篇的训练选择;Slurm资源申请和torchrun会合地址继续放在启动脚本中。选项名称已对照该版本的参数定义。
--tensor-model-parallel-size 8
--pipeline-model-parallel-size 8
--context-parallel-size 1
--sequence-parallel
--micro-batch-size 1
--global-batch-size 1920
--seq-length 8192
--bf16
--use-distributed-optimizer
--overlap-grad-reduce
--overlap-param-gather
--optimizer adam
--adam-beta1 0.9
--adam-beta2 0.95
--adam-eps 1e-8
--weight-decay 0.1
--weight-decay-incr-style constant
--clip-grad 1.0
--lr 8e-5
--min-lr 8e-6
--lr-warmup-init 0
--lr-decay-style cosine
--lr-warmup-samples 2442240
--train-samples 1220701440
--lr-decay-samples 1220701440
可以把这些参数分成四组来读:
| 我们要告诉程序什么 | 对应设置 |
|---|---|
| 用哪套更新规则,怎样保留历史 | --optimizer adam、--adam-beta1 0.9、--adam-beta2 0.95、--adam-eps 1e-8 |
| 怎样约束权重与过大的梯度 | --weight-decay 0.1、--weight-decay-incr-style constant、--clip-grad 1.0 |
| 学习率怎样开始、变化和结束 | --lr 8e-5、--min-lr 8e-6、--lr-warmup-init 0、--lr-decay-style cosine,再用两项samples参数指定预热与下降长度 |
| 状态怎样分担,通信怎样重叠 | --use-distributed-optimizer、--overlap-grad-reduce、--overlap-param-gather |
这里把权重衰减的变化方式显式写成constant:系数保持0.1,每次实际收缩幅度仍会跟着学习率变化。预热长度是--lr-warmup-samples 2442240;下降终点是--lr-decay-samples 1220701440。这些samples指序列条数,用每条8,192个输入token换算到正文的材料量。
解耦权重衰减沿用该固定版本OptimizerConfig中为真的默认值,并在创建优化器时核对。若以后改用直接调用Core的Python入口,也要把同名配置字段设为真。BF16模式下保持FP32梯度累积,不启用把主梯度改成BF16的附加选项。文档边界、位置与损失规则仍按第九篇在数据路径中分别设置并检查。
10T无法恰好被15,728,640整除。这里先取635,782次完整更新,对应1,220,701,440条样本,以及9,999,986,196,480个输入token;离10T还差13,803,520,约0.000138%。这份可执行基线按完整更新向下对齐,把差额记在预算表里。若项目要求精确到10T,工程配置须另行处理末批大小与掩码;整批多跑一次会略超出预算。
同版本的训练循环只在参数更新成功时推进学习率调度;一次更新若被跳过,已读取样本计数仍可能增加。因此上面的步数和终点换算以更新全部成功为前提。运行记录要分开保存读取进度、成功更新进度和跳过的更新;恢复训练时连同优化器与调度器状态一起恢复。
启动以后,怎样确认设置真的用上了?
文件存好以后,还要看程序是否照着执行。第一次小模型验收,我要求输出解析后的优化器配置、实际类型与参数分组。需要看见AdamW模式、β₁=0.9、β₂=0.95、ε=10⁻⁸,以及哪些参数组的衰减系数是0.1、哪些是0。
Core的默认分组会让偏置与一维参数跳过衰减。我们按实际模型核对这个名单,再保存下来。训练中则记录当前学习率、裁剪前梯度范数、裁剪是否发生和更新是否成功,让配置与真实动作能够对应。
例如进入预热阶段后,学习率应沿着计划上升;到达峰值附近,它应接近0.00008。抽查一个参与衰减的参数时,可以从它的旧值、梯度和两份历史记录复算下一步,确认既有Adam更新,也有独立的权重衰减。这个小检查通过以后,再进入整套训练配置的验收。
正式开跑前,怎样证明这份配置值得使用?
先拿一次更新核对正确性。用能在少量机器上运行的小模型,固定同一批材料,比较直接处理全局批量与拆成微批累积的结果,核对损失归一化、梯度和参数变化。再抽查文档边界:结束标记要学习,跨文档预测要屏蔽,填充不进入训练量。这样,后面看到的曲线才有一致含义。
更新对得上,再把冻结后的500B结构放进计划分组,看它能否装下并持续运行:先测若干完整更新,再延长到能观察稳定吞吐的短跑。每个阶段记录峰值显存、前向反向耗时、通信等待和每秒非填充输入token。微批量已经是1;若激活值仍过大,先比较选择性重计算,再核对阶段边界。每一种调整都要重新测8K吞吐,并更新工期估算。
机器能持续跑了,才轮到这套配置究竟学得怎样。先在较小模型上筛查明显不合适的范围,再把有希望的设置带到目标规模。批量先比较约8M、16M、32M;每档围绕峰值4×10⁻⁵、8×10⁻⁵、1.2×10⁻⁴做有限对照,保持数据顺序、token预算和验证集一致。短跑先判断数值稳定与系统表现,随后覆盖预热和一段峰值附近的训练,再比较验证损失。小模型筛选帮助节省试验成本,最终选择由目标规模的证据决定。
这些对照是研发试验,单列消耗;只有选中的正式运行继续累计进主训练10T。出现一次损失尖峰时,先把对应材料、梯度和更新记录放在一起看。若相同内容反复触发异常,检查数据;若多种正常材料在提高学习率后持续恶化,就降低峰值或延长预热,再从同一检查点重做对照。
这轮验证收尾时,再主动保存一次检查点,停下来恢复,检查下一批材料、学习率、优化器记录和累计计数是否接得上。第十三篇讨论的存档方案,到这里就与具体的训练进度连起来了。
最初空着的几格终于填完:8K窗口,每组一次一条、累积24次,80组汇总后更新;AdamW沿着先升后降的学习率推进,累计材料接近10T。日志里的变化也有了参照,能一路追到具体配置。
我保存了这份文件。接下来,怎样让机房里640台服务器读到同一份配置,在同一次任务里一起开工?
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。