
[从零训练一个
训练配方保存好了:每条材料8,192个token,80组机器各读24条,再一起更新参数。文件在眼前,640台服务器在机房里。我离“开始”还差一次真正的提交。
一台机器上运行程序很熟悉,640台同时跑,却不能靠逐台打开终端。它们要拿到相同环境,知道彼此在哪里,也要知道这批资源现在归谁使用。
我先把“启动训练”写成一个完整任务:申请机器,把程序送进去,让进程找到合作伙伴,最后检查所有卡是否完成同一次更新。退出以后,机器还得完整交还,下一项任务才能接着用。
先把机器交给一个统一的管理员
第一站是第十四篇选好的Slurm。把需要的节点数、每台卡数与预计时长写进申请,它按资源和优先级排队,条件满足后再把机器分给这次训练。
本次主训练申请640台B200服务器,每台8张GPU,共5,120张。任务拿到的是一份完整分配。其余同事也通过同一个入口申请资源,这样大家能知道哪些机器正在忙、哪些在维修、什么时候可能轮到自己。
申请640台,看起来要等很久。可这次计算已经分成TP8、PP8、DP80,机器得整批就位。一次更新会经过全部并行分组,缺少其中一部分,其他进程就会等待。先启动200台、剩余440台以后再慢慢加入,需要另一套能调整分组和训练状态的实现。当前方案选择固定规模,让一次运行的批量、学习率与数据进度都保持清楚。
清单里还有20台备用服务器,我给它们保留的是故障替换的职责。正式运行仍以640台为资源目标。我们会对备用机做健康检查,也可以安排可立即停止的验收任务;不把这160张备用GPU长期许诺给第二项关键工作。
Slurm的资源文档解释了GPU怎样被登记、分配和隔离。项目验收时,还要核对调度器登记的GPU与机器实际设备一致。维修中的机器先退出可分配名单,修好并通过检查后再回来。
调度器:根据资源、优先级和任务要求,决定哪项任务在什么机器上运行的软件。
作业:向调度器提交的一项完整任务。它有自己的编号、资源申请和运行记录。
分区:Slurm中一组节点及其使用规则的集合。这里用训练分区管理正式训练机器。
申请机器以后,还要把程序启动起来
任务登记为4821。以后查看状态、日志和使用时长,就沿着这个作业编号找。机器分配到位以后,程序还要真正启动。
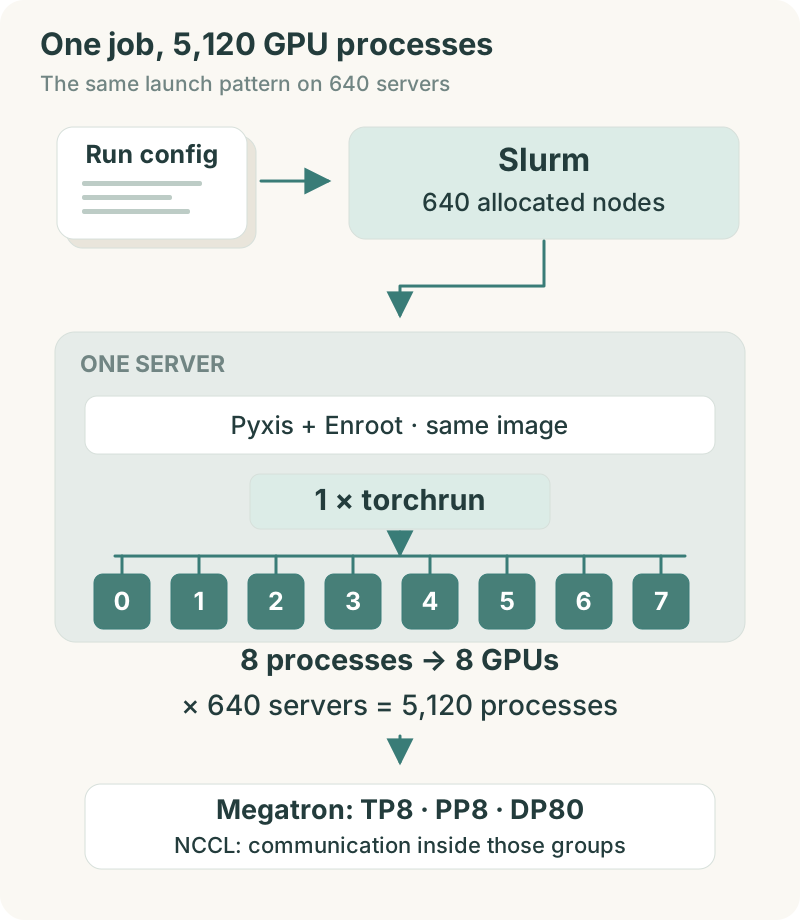
每台服务器有8张GPU,我采用一张卡对应一个训练进程。因此640台机器需要启动5,120个进程。进程可以理解成正在运行的一份程序:每份都执行相同的训练代码,再根据自己的编号承担不同部分。
写启动脚本时,有两个位置都能创建进程:Slurm可以在每台启动8个任务,也可以先启动一个启动器,再由它生成8个进程。两处都乘8,就会重复启动。我选后一条:Slurm每台启动一个torchrun,由它创建本机8个GPU进程。640个启动器,合计5,120个训练进程。
这个分工让torchrun负责本机进程编号,Megatron训练入口沿用分布式进程的初始化方式。Slurm负责给机器和启动节点级任务,节点内的8个进程由启动器管理。部署时会用小作业检查GPU可见性:每个启动器看见本机分配的8张卡,8个子进程各使用不同的一张。
PyTorch的torchrun文档说明了进程编号和节点间会合的基本机制。对本计划,我们把节点数量固定为640,节点内进程数固定为8,使用同一份会合地址与端口,禁止把两个作业接到同一组通信里。
进程:操作系统正在执行的一份程序实例。本文每个GPU进程负责一张GPU上的训练工作。
启动器:负责创建并管理一组训练进程的程序。这里使用torchrun。
Rank:分布式任务中一个进程的编号。全局编号用于找到它在整个任务中的位置,本机编号用于找到本机GPU。
每份程序怎样知道自己该干什么?
我沿着日志找到一条记录:作业4821,服务器train-032,本机GPU 3,旁边还有全局进程编号。程序、机器和卡,现在能够一一对应。
接着检查它的合作伙伴。Megatron读取第十五篇的并行配置,把全部进程分成几类合作关系:同一层的8张卡一起计算,8个阶段前后接力,80份模型副本汇总对应参数的梯度。研究员给出分组规模,训练框架负责建立相应的通信组。
分组还得落在正确的位置。同一组TP的8张卡应在一台服务器内,用机内高速连接;PP的阶段跨8台服务器接力;DP把80条流水线中相同位置的参数连起来。这需要检查框架采用的rank顺序与实际节点顺序。只看“TP等于8”还不够,启动记录要能列出每组成员在哪台机器上。
我让启动阶段输出一张简短映射表:进程编号、服务器、GPU编号、TP组、PP阶段和DP编号。取其中一条流水线,看它是否恰好覆盖8台服务器;再取其中一个TP组,看它是否恰好落在同一台。这样可以在计算开始前发现摆放错误。
组员找齐,NCCL才把这些合作要求变成GPU之间的传输。它并不知道我们为什么要训练500B,只负责按程序要求交换、汇总数据。它使用哪些网卡和链路,由驱动、拓扑和通信配置共同决定。第十二篇接好的网络,第十四篇装好的库,到这里才服务于第十五篇的具体分工。
Megatron的并行状态实现可以核对各组的形成方式。正式脚本固定这一版本,把映射表与配置一起保存。
通信组:需要一起完成某项数据交换的一组进程。一个进程可以同时属于TP、PP和DP等不同通信组。
给每台机器同一套工具,也给每次运行自己的记录
分工没有问题,还要确认每台拿着相同工具。640台机器使用第十四篇构建的同一份训练镜像。Pyxis把容器启动接入Slurm,Enroot运行容器环境。我们用镜像摘要确定具体内容,让“同一个版本”能被机器核对。
我把容器里需要访问的内容分成三个位置:只读教材目录、只读代码与配置、可写的本次运行目录。教材和分词器版本固定,本次运行的日志与检查点则写入独立路径,例如runs/500b-main-001/。新的对照实验使用新的目录,避免两项任务覆盖同一份进度。
启动之前,镜像就先分发到节点。640台同时从外部仓库下载,会让训练一开始就排队等网络。先校验镜像、缓存数据,再启动正式任务。镜像摘要、代码提交、模型配置、数据清单和启动参数共同构成运行记录。
Pyxis官方项目提供了通过Slurm运行容器任务的方式。它必须与实际安装的Slurm版本兼容,所以升级调度器时,容器插件也要进入同一轮验证。项目继续使用第十四篇已经固定的工具链,先在小分区试过,再推广到主训练分区。
镜像摘要:根据镜像内容得到的标识,用来确认不同节点拿到相同产物。
挂载:把宿主机或共享存储的路径接入容器,让程序能够访问这些文件。
提交文件最后长什么样?
资源、进程和环境对齐以后,我把它们收进一张运行单。前几篇确定的数字逐项填入,再由管理员补齐站点分区名、路径与网络设置。
| 运行单中的项目 | 本次主训练填写什么 |
|---|---|
| 计算资源 | 640台服务器,每台8张B200 |
| 节点级任务 | 每台1个启动器,共640个 |
| GPU进程 | 每个启动器生成8个,共5,120个 |
| 模型分工 | TP8、PP8、DP80、CP1,启用序列并行 |
| 训练配方 | 8K序列,全局1,920条,每组累积24个微批 |
| 软件与材料 | 固定镜像摘要、代码版本、模型和数据配置 |
| 输出位置 | 独立运行目录,检查点与日志分开保存 |
| 退出处理 | 保存退出原因,释放分配,按恢复流程再提交 |
填到运行时限,又遇到一个与训练日历不同的数字。主训练约76天,站点允许的单次作业可能更短。我把运行拆成符合站点时限的段,用完整检查点接起来。申请多久、何时发出提前结束信号、保存需要预留多久,都写进站点运行配置,再做一次真实停机演练。
Slurm的sbatch说明可以核对节点、任务、时间和信号选项。提交文件与训练参数一起审查,让“申请了多少资源”与“代码会启动多少进程”在纸面上先对齐。
主训练开始后,其他工作放在哪里?
640台全分给主训练,评估任务马上面临一个空位问题:它到哪里跑?同一批GPU已经用满,评估时间也得进入计划。
我把数据准备与轻量检查留在CPU服务上;主训练期间的大模型评估按固定里程碑安排,在保存完整检查点后分配专门的评估窗口。评估占用的时间进入日历效率账。需要同时评估、生成教师数据或做新实验时,另外申请小型计算池,把成本与资源写成新增项目。
短暂空档交给Slurm排队与回填来利用。正式训练保留优先级,可中断的小实验设明确时限。任何任务占用备用机,都要接受故障替换优先的规则。
再打开任务列表,资源去向就能看清:哪些资源在训练、哪些在维修、哪些用于评估,等待中的任务为何还没开始。排队原因也成为计划的一部分。
先用一次小作业证明整条路走得通
运行单齐了,我先只申请两台服务器,走一次相同的提交路径。它使用相同镜像、目录和启动路径,确认16个进程各占一张卡,日志记录完整,主动取消后能退出并释放资源。接着扩大到一个适合目标模型的验收规模,检查真实并行组和保存恢复。
进程都启动,还要继续等到同一次更新完成:损失有记录,输入token增加,参数更新计数一致,没有某一台永远停在初始化。这个时刻才意味着机器已经开始共同训练。
从一份配置到5,120个GPU进程,这条启动路径终于接上了:Slurm安排机器,Pyxis与Enroot准备环境,torchrun启动进程,Megatron分配计算,NCCL交换结果。
日志开始滚动,也带来下一问:能启动,是否就值得让整个集群连续跑76天?正式把时间投进去之前,还得沿着这条路逐级验收。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。