
[从零训练一个
屏幕上的日志开始滚动,5,120张GPU都能被程序叫起来。盯了这么久的启动过程终于走通,我却还没有把它改成正式训练。
接下来要投入10T token的学习。一处不起眼的错误,可能跟着它走完数万亿token。材料读对了吗,梯度汇总对了吗,多加的机器换回了多少速度?日志在滚,还需要更具体的答案。
我先把规模缩下来,从能看清的一次更新开始。小模型核对计算,真正的500B测容量,再逐级扩大,最后让完整集群经历保存、故障与恢复。每一级通过,才把下一笔机器时间投进去。
第一关,用一小份材料看清一次更新
第一份验收材料只有几十条。里面既有长文,也有两篇打包在同一窗口里的短文;再安排几个填充位置,专门检查第九篇的数据规则。
我选一个单卡能运行的小模型,固定初始权重与材料顺序,完整走一次前向、反向和更新。记录预测损失、参与损失的位置数量、几个参数的梯度,以及更新后的参数值。这里测试的是训练过程,所以先让模型小到能把每一步看清楚。
接着用相同材料,把一次大批量拆成几个微批累积。两条路径应当在约定的数值误差范围内给出相同结果。训练工程师会先在较高精度、小尺寸的对照中检查,再在正式精度下建立允许误差。容差由计算精度和算子实现确定,不能事后放宽到刚好让错误通过。
这一步最容易藏住的错误,是材料长短不同,程序却把每个微批的损失简单平均。没有按有效token数量加权,长文和短文的贡献就会走样。机器仍然忙,损失甚至可能下降,训练目标却已经偏了。
我又在两篇打包的短文之间检查了一次边界。固定第二篇短文的token和重置后的位置编号,替换前面第一篇的内容,第二篇有效位置的输出应保持在相同数值容差内;这才检查了跨文档屏蔽是否生效;填充位置不贡献损失;结束标记按既定规则参与学习。我们从几条能看懂的材料开始,给后面数万亿token建立一份正确性参照。
数值容差:考虑浮点计算误差以后,比较两个结果时允许的差异范围。
对照运行:保持其他条件一致,只改变要检查的一个因素,用来判断变化来自哪里。
第二关,让几张卡算出同一件事
单卡结果对得上,再把同一个小模型分到多张卡。材料、初始参数和全局批量保持相同,依次开启数据、张量和流水线并行,核对一次完整更新的结果。
为了让差异出现时能找到来处,我把并行方式分开检查。数据并行检查不同副本是否把同一参数的梯度正确汇总;张量并行检查分片计算和结果拼接;流水线并行检查各阶段的前后传递与微批累积。先各自核对,再把组合放在一起,发生差异时就容易缩小范围。
多卡更新通过以后,就地保存一次检查点,再用相同配置恢复。比较下一批样本编号、学习率和参数更新记录。训练里含有随机操作时,还要恢复对应随机状态。对照运行与恢复运行的差异必须能被实现和数值精度解释。
小模型的完整结果能够拿出来逐项比较,软件正确性因此有了参照。可目标500B的显存和通信量,还得把真正的模型放进去才能看到。
在它上场之前,网络先单独跑一轮。NVIDIA的nccl-tests同时检查通信结果和性能,我们会覆盖实际训练使用的消息大小、机内通信与跨机通信。一个极小消息跑通以后,还要检查大消息和并发情况;训练时真正交换的数据决定测试范围。
第三关,给真正的500B找一个合适的起跑规模
轮到真正的500B,单卡已经装不下约1TB计算权重。我沿着第十五篇的分组,找一个能够容纳它的起跑规模。
TP8、PP8意味着每个副本64张卡,先用64张似乎很自然。再翻显存账,问题出现了:正式方案把优化器状态分给80个数据并行副本保存。只留一个副本,它要独自背起更多状态,显存负担反而变重。
沿用第十五篇的Core 0.19.2口径,均匀分片时,每张卡负责约78.125亿参数。BF16计算权重与FP32梯度共6字节,主权重和Adam状态共12字节,由DP组分摊。于是主状态近似为:
78.125亿 ×(6+12÷DP)字节
DP为1时约140.63GB;DP为8时约58.59GB;DP为80时约48.05GB。这里还没有放入激活值、通信缓冲和不均匀分片,因此峰值仍要从实际模型测出。
看过这三档容量,我把第一档验收资源设为512张卡,也就是64台服务器、DP8。它保留TP8与PP8,也给激活值留出比DP1更大的余地。先冻结模型层数、宽度和阶段分配,再运行少量完整更新,记录每个阶段的峰值显存。
遇到某阶段显存特别紧,就沿着它承担的输入、输出与层数检查,再比较阶段重分配和选择性重计算。每次改变都留下配置与吞吐结果。我们的目标是找到能持续运行的目标模型布局,再扩大副本数量。
峰值显存:一次完整训练过程中,某张GPU实际使用显存的最高值。
重计算:反向传播需要某些中间结果时重新算一次,以额外计算换取较少的保存空间。
第四关,按四个台阶看扩容有没有价值
目标模型能够持续运行,接下来要看更多机器究竟能买回多少时间。我按512、1,024、2,560和5,120张卡逐档扩大,对应DP8、DP16、DP40和DP80。每一级都保留TP8、PP8和8K窗口,让不同规模之间有可比较的基础。
全局批量仍固定为1,920条,因此每组需要累积的微批数会随副本数变化:
| 活跃GPU | 服务器 | DP副本数 | 每组微批数 |
|---|---|---|---|
| 512 | 64 | 8 | 240 |
| 1,024 | 128 | 16 | 120 |
| 2,560 | 320 | 40 | 48 |
| 5,120 | 640 | 80 | 24 |
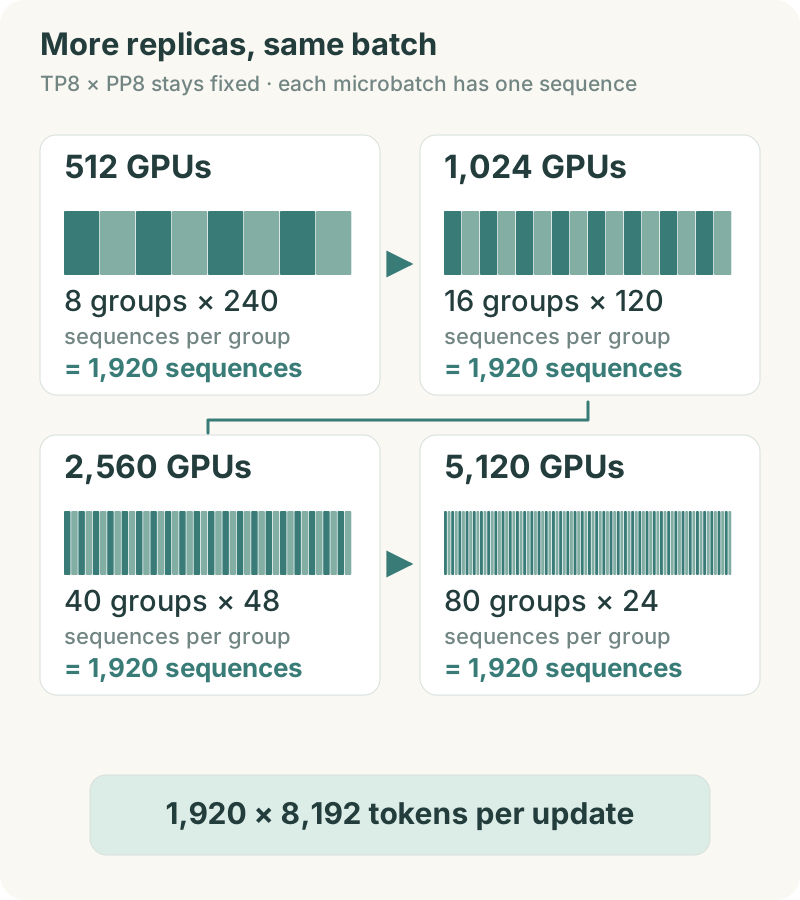
这四档始终完成同一批工作,速度变化才有可比性。副本增多以后,每组处理的微批减少,流水线启动和收尾占比也会变化;通信参与者更多,汇总路径也更长。这些都是实际扩容成本,应该留在结果中。
计时也要站在同一条起跑线上。每档先完成启动与缓存准备,再记录稳定运行。报告中写明测量窗口、完成的更新数、实际非填充token量,以及有没有包括保存检查点。不能拿一档的冷启动与另一档的稳定阶段直接相比。
把512卡每秒18万token、1,024卡每秒32万token填进比较表,速度比就是32÷18,约1.78倍。卡数翻倍,速度增加1.78倍,这一级扩展效率便是约89%。沿着这套算法,四档结果可以放在一起读。
最后一档尤其值得仔细看。从2,560张加到5,120张,只要速度没有明显跟上,就先停在这里找瓶颈。多等一天,场地、电力与团队也多投入一天,把低效率找出来本身就有价值。
扩展效率:卡数增加以后,实际速度提升相对于理想同比提升的比例。
稳定运行窗口:启动、编译和缓存准备结束后,用来持续测量正常训练表现的一段时间。
第五关,让保存与故障真的发生一次
完整集群的速度有了,还得给它试一次退路。第十三篇安排的约7TB检查点,这时用真正的模型保存:检查分片、总大小和最新完成记录,再加载回来。
接着主动结束一个训练进程,沿着日志看其他进程怎样退出、调度器怎样记录失败,是否还有进程留着占卡。把故障节点隔离,用备用节点替换,再恢复同一份进度。这个过程同时检验训练代码、调度、存储和运维流程。
恢复时,把数据团队也叫进验收:恢复后的下一批材料从哪里开始,重复计算部分怎样记账,是否会跳过一段材料,都要从样本记录核对。只看参数文件能加载,还不能回答训练有没有接对。
在硬件层面,使用DCGM诊断检查GPU、机内连接、功率和温度相关状态,再结合服务器厂商的诊断处理具体故障。检查工具各有覆盖范围,工程记录保留原始错误、节点和时间,让后续维修能追溯。
一次保存与恢复过关以后,试跑继续跨过多个保存周期。本计划以24小时为首轮观察窗口,检查热稳定、定时保存、读取波动和恢复流程;发现重复故障就延长排查。24小时是项目选择的验收窗口,后续76天的可靠性仍需要运行中的监控和恢复能力来保障。
最后把测到的速度放回日历
验收记录齐了,我重新打开第二篇的日历。76天来自规划吞吐,现在该把完整目标模型的速度放回去。
把完整集群每秒160万非填充输入token代入,累计10T的纯计算时间是约72.34天;再按90%的日历有效比例安排,时间变成约80.38天。速度与损耗一变,结束日期就跟着变。保存、评估、恢复和维护的记录,也要一起带回这张日历。
如果吞吐本身已经用整段墙上时间计算,且包含这些损耗,就直接用它换算工期,避免再除一次90%。同一个“每秒token”需要注明时间范围,预算才不会重复打折。
这几轮试跑花掉的材料与机器时间,我另记在研发账上。用于比较配置的材料读取和GPU时间属于试验成本;正式主训练从确定的起点累计10T。若决定保留某个已验收检查点作为正式运行起点,就明确计入它已经读过的材料、配置和费用。
| 正式开始前要拿出的东西 | 负责人核对什么 |
|---|---|
| 小模型正确性记录 | 数据边界、损失归一化、梯度和更新一致 |
| 目标模型容量记录 | 每阶段峰值显存、稳定运行配置 |
| 四档扩容记录 | 吞吐、测量窗口、卡数和扩展效率 |
| 保存与恢复记录 | 完整状态、材料位置、故障替换与恢复时间 |
| 更新后的日历 | 目标吞吐、运行损耗、剩余token与预计结束日期 |
拿着这些结果,配置才从试验转为正式训练:软件版本、材料版本、资源规模与恢复路径都能对应到记录。启动日志的滚动,此时才真正变成可持续的学习。
训练还要运行很久。演练中的中断能够安排时间,正式运行里的故障却不会等人。下一篇,沿着一次突然掉线,看看怎样把进度接回来。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。