
[从零训练一个
上一篇,参考机上的小模型已经有了安装与验收路线。把训练配置换成500B,最先拦住启动的却是容量:仅一份计算权重,就要1TB。
我把它与B200的180GB显存并排写在纸上。500B是5,000亿参数,每个2字节,合起来远超单卡容量。一台八卡共有1,440GB,可这些空间仍在八张卡上,并不会自动拼成一个大抽屉。软件得明确告诉每张卡存什么、算什么,何时把结果交给谁。
而且这还只是权重。梯度、更新记录和中间结果也要找地方。先拆开模型,让它放得下;再把剩余机器组织起来,让训练材料处理得更快。我沿着一批材料的路线安排这两种分工,最后再把方案交给上一篇装好的软件。
一张卡放不下,先沿着层切开
先摊开第四篇的模型图。文字变成数字,从第一层依次走到最后一层,每层接前一层的结果继续加工。沿着这个前后顺序,最容易先把层分段。
我先把模型分成8段,交给8台服务器。第一台接近输入,第二台接着处理,第八台负责最后的输出。每段叫一个阶段,各自保管本段的权重。
材料来了,第一台算完自己的层,把中间表示送给第二台,后面继续接力。沿线移动的是这批文字加工后的数字;权重驻留在负责的机器,下一批还要继续用。
只走到出口还不够,训练的误差要走回来。最后一段算出预测误差,反向计算逐段返回,各阶段得出本段参数的调整依据。前向传中间结果,反向传相应梯度,拆开的层仍共同组成一个模型。这就是流水线并行PP。
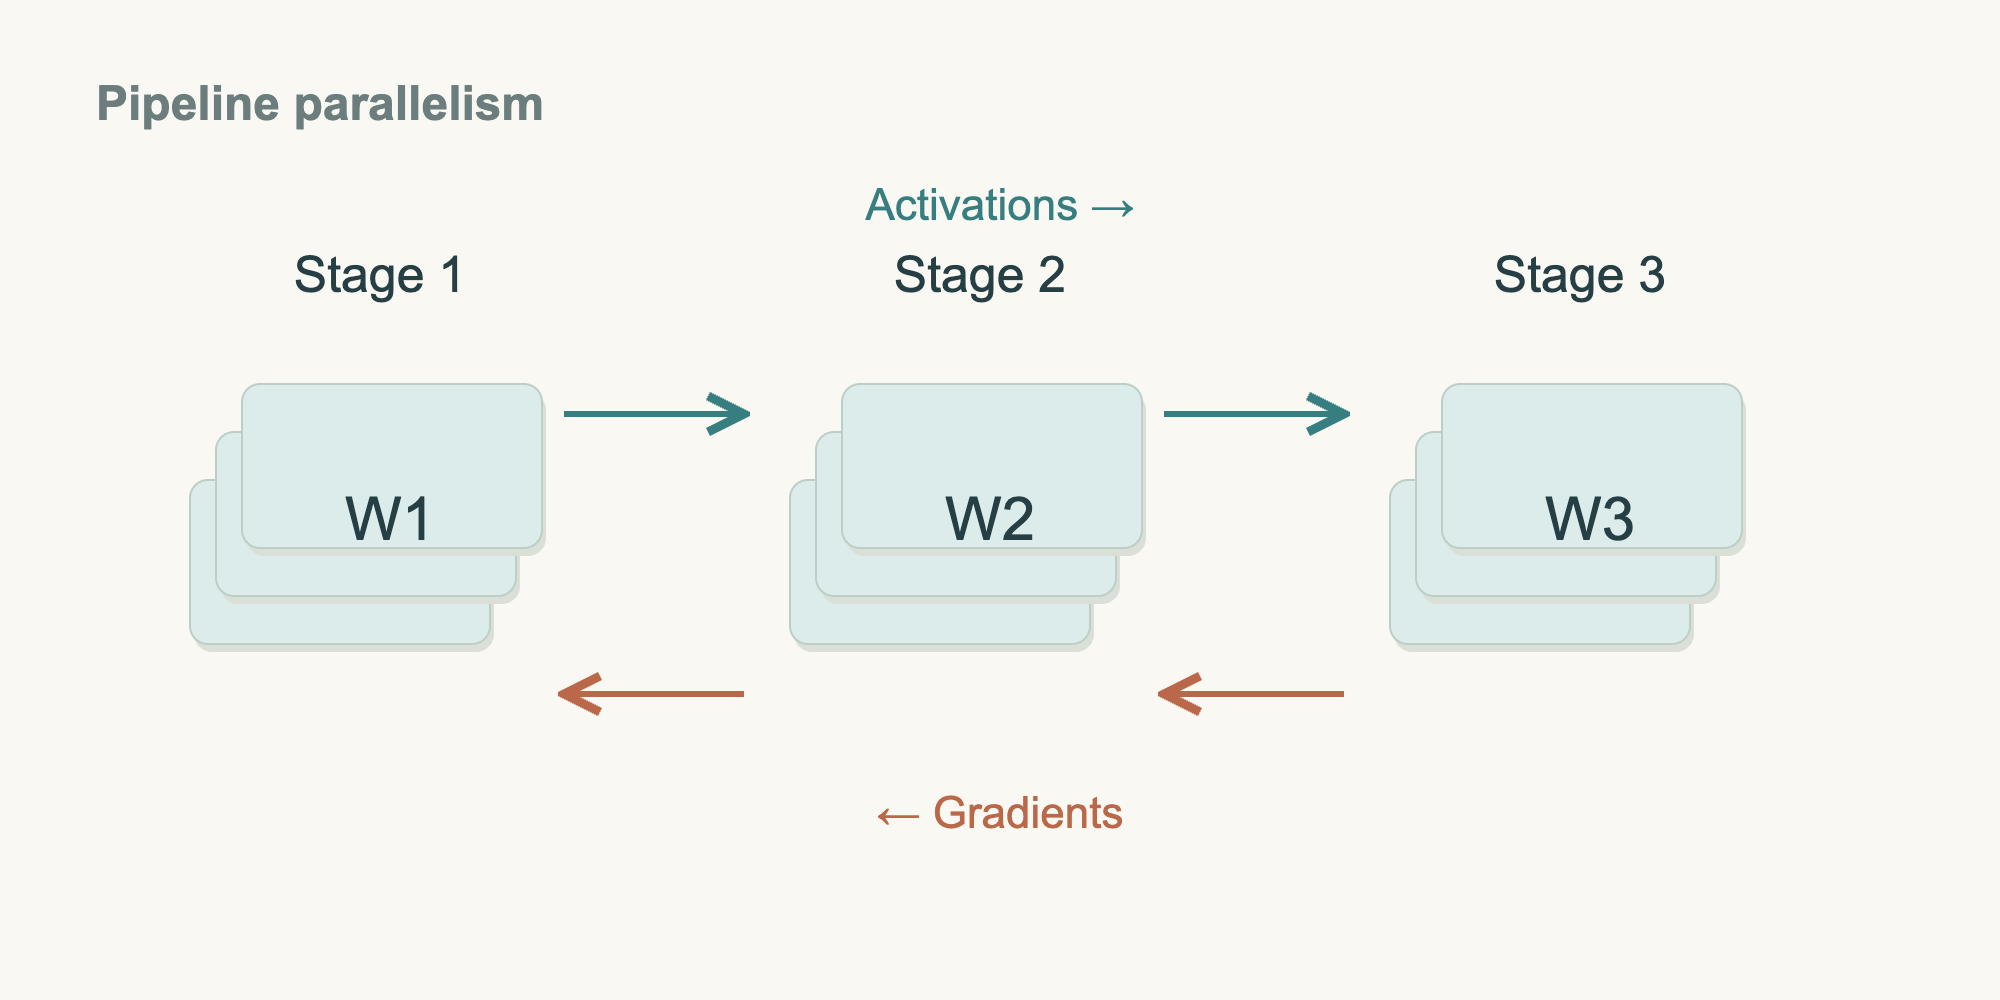
图里W留在各阶段,跟上方右行箭头看材料经过,再沿下方左行箭头看反向梯度返回。每个阶段负责的权重一直在原处,箭头搬运的是当前材料的中间结果与相应梯度。图缩成三段便于看连接,项目实际先分8段。
8段也需要理由。分得更多,每台模型更小,交接与等待也更多。先让8台接力,再配合每台8卡分工,主状态便能散到64张卡,后面的显存账能检验这一步是否值得。实际验收看单卡峰值、各阶段耗时、连续小批能否减少等待;输入输出部分也算进阶段负载。Megatron流水线实现负责安排这些前向、反向与传递。
8段指8组层,具体哪些层归哪段写进配置。切口要尽量让耗时接近,否则前一段很忙,后一段仍会等。
流水线并行(PP):把模型按前后顺序分成几个阶段,由不同设备接力计算。
激活值:模型处理输入时产生的中间结果。它们会传给后面的层,一部分还要留给反向计算使用。
梯度:说明参数或中间结果发生小变化时,误差会怎样变化的数值。训练沿着它计算参数的更新方向。
每台拿到一段,八张卡怎样一起算?
八段分好了,每台仍有八张GPU,怎么让它们一起处理本段?继续把每层的大计算拆开,交给同台八张卡合作。这一层内的切分叫张量并行TP。
把其中一层缩成两个输入、四个输出,切法就很直观:产生前两个输出的权重归GPU A,后两个归GPU B。各卡拿到所需输入,算自己那一份,再按后续计算需要交换结果。
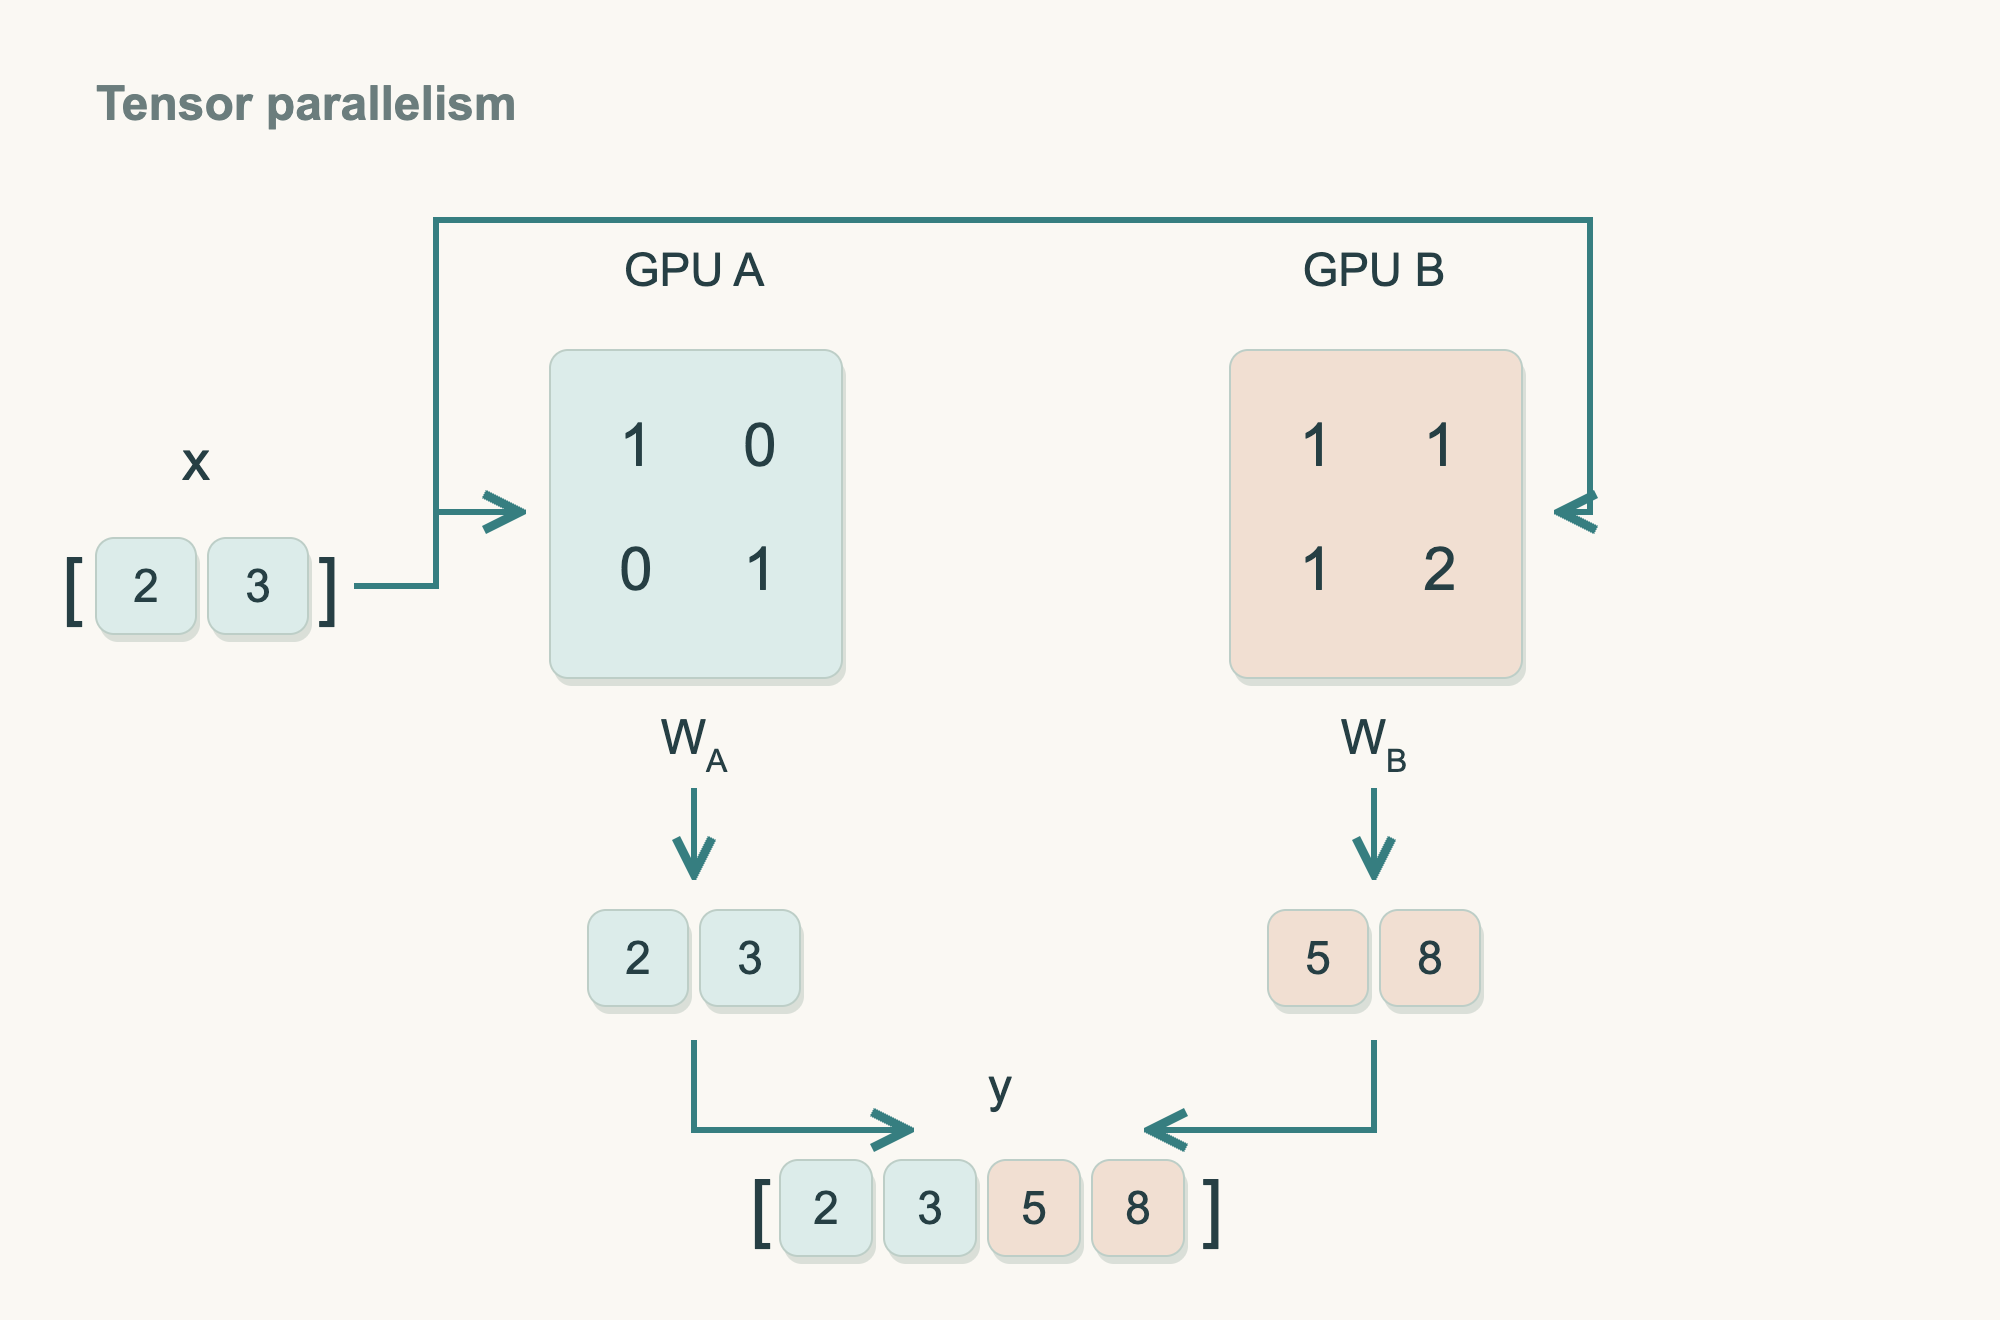
图里单个数字是标量,一排数字组成向量。输入[2, 3],A拿左两列权重得到[2, 3],B拿右两列得到[5, 8],最后一格就是2×1+3×2=8。按原序拼起来仍是[2, 3, 5, 8]。两卡图说明按列切分,实际用8卡;后续有的计算直接接分片,有的切法需要求和,通信随计算关系安排。
放回大网络,数字表更大,原理沿同样的切分走。Megatron线性层支持按行或列分权重,两步怎样组合决定哪里交换、哪里合并,官方实现说明可以对照这两种方式。每卡保留本层的一份权重,也承担相应计算。
这类交换每过几步就要发生,放在哪里就很关键。我把TP8留在同一台,用NVLink与NVSwitch承担频繁的层内协作;阶段之间的交接才走跨机网络。这个安排也能对照NVIDIA并行部署指南。
两次切分合起来,第一份完整模型终于有了安放方式:8台前后接力,每台8卡分担本段各层,共64张GPU。材料仍完整经过所有层,只是层的位置与层内工作分别有人接手。
张量:按维度排列的一组数字。矩阵就是二维张量;模型权重和中间结果都可以用张量表示。
张量并行(TP):把一层中的权重与计算分给多张GPU,由它们交换结果、共同完成这一层。
一组能装下模型,剩下79组做什么?
纸上划掉64张,旁边还有5,120张总数。剩余机器可以再按相同方式组织,得到:
5,120张GPU ÷ 每组64张 = 80组
80组各有同一模型的一份完整权重,组内仍拆成8台、每台8卡。它们从同一版参数出发,分别读不同材料:一组读一批中文,另一组拿另一批,各按前面定好的配方采样。
读的东西不同,梯度也就不同。更新前,先把对应参数的贡献汇总:第一组第三阶段第二张卡的一个参数,对齐另外79组同位置的那个参数,再按同一结果更新。下一轮开始时,80组依旧是同一版模型,各自继续读新材料。
这一步叫数据并行DP,增加的是同一模型同时处理材料的能力,最后仍得到一个训练好的模型。Megatron通信分组把层内协作、前后接力和这些对应参数同步分别组织起来。
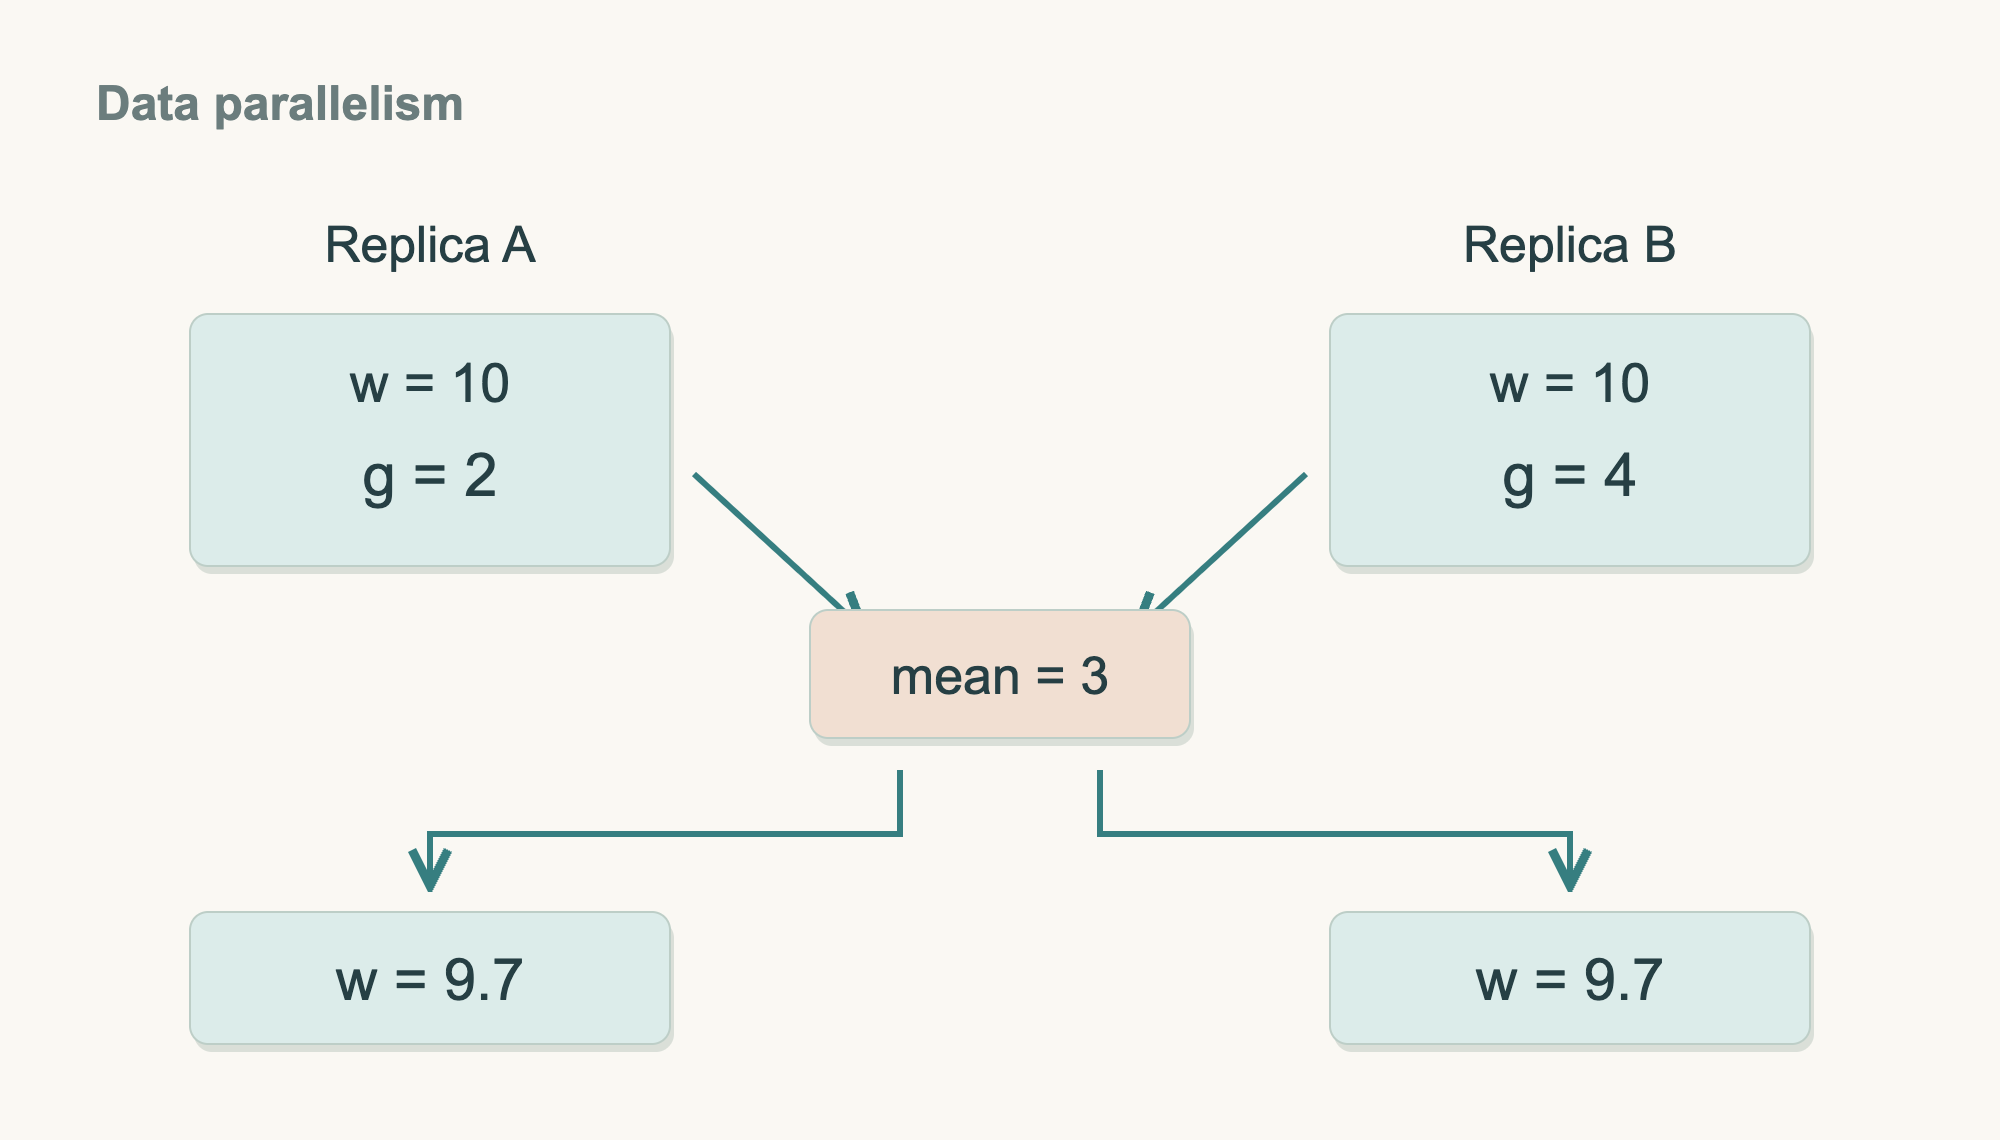
沿图中同一个参数跟一次更新。两组初值都是10,各读等权小批,梯度分别2和4,平均后共同用3。取学习率0.1,按最简单SGD规则,双方都变成10-0.1×3=9.7。这个小算式把同步讲清楚;项目的Adam还要用历史状态决定实际步幅。图里每个组框代表64卡共同承载的整模型。
现在也能看清为何不能一开始只做数据并行。完整500B若直接复制给每张卡,180GB仍放不下。先用64卡承载一份,再复制整个组,容量问题与材料吞吐才分别得到处理。
把三层分工合到一张图上:一台8卡,再把8台接成一组,最后复制80组。服务器框是一台机器,小色块是GPU所持权重分片,顺着这些层级看,设备数量就不会数重。
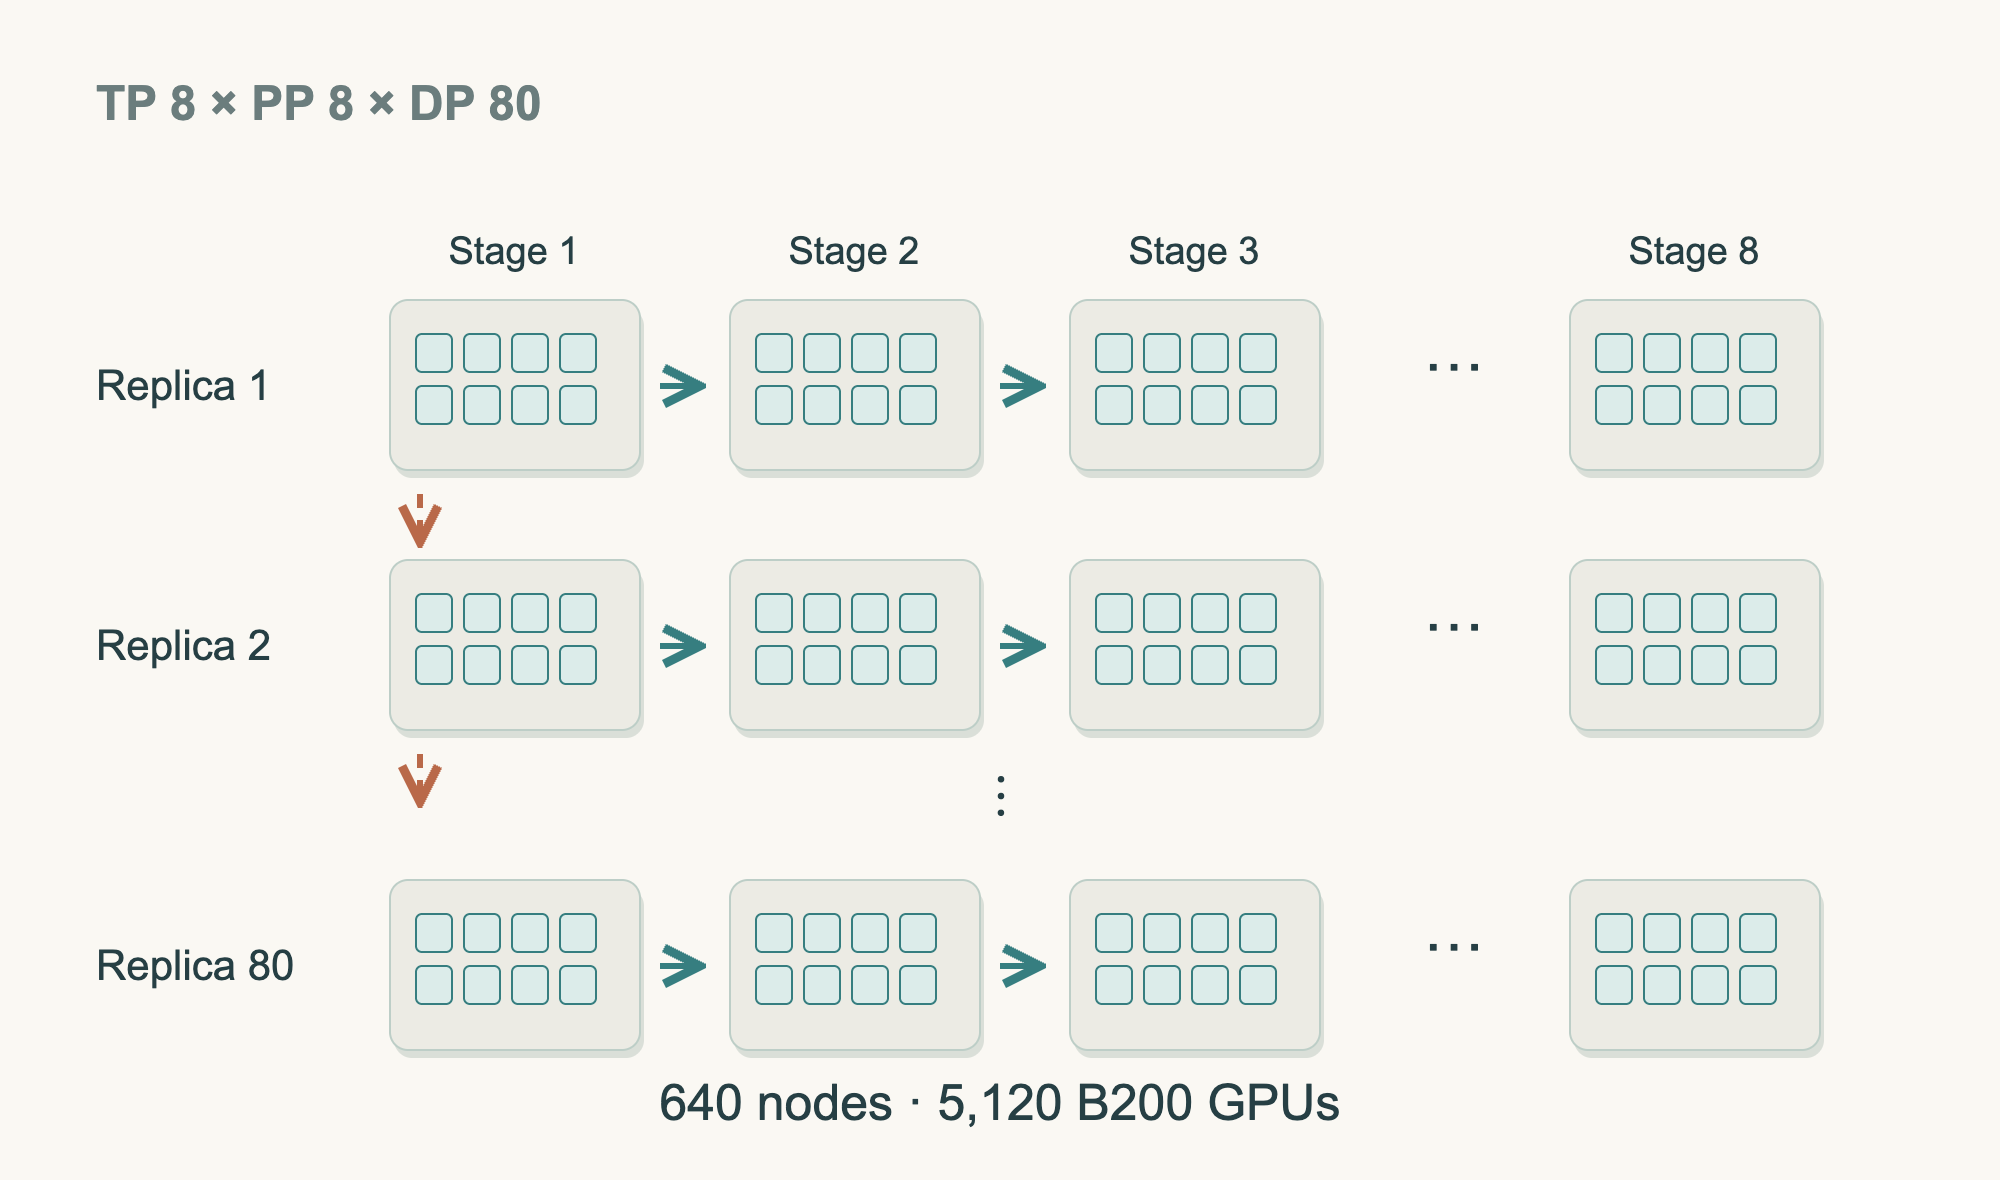
图里展开部分副本和一条对应分片的同步线,完整安排仍是每流水线8台64卡,80组共640台、5,120张GPU。
数据并行(DP):让相同模型的多个计算副本读取不同材料,再汇总对应参数的梯度,保持更新一致。
模型副本:同一套模型权重的一份计算副本。本文的一份副本分布在64张GPU上。
接力会不会让后面的机器一直等?
容量安排好了,时间线上却还会出现空白。第一批尚在第一阶段,后面的阶段没有输入,只能等。把一次更新的材料拆成许多小批,连续送入,接力才能逐渐忙起来。
第一小批走到第二阶段,第一阶段就接第二小批;第一小批再往后,其他阶段也陆续忙于不同小批。训练还要反向,流水线填起来后,让阶段交替做前向与反向,已回传的小批也能及时释放中间结果。
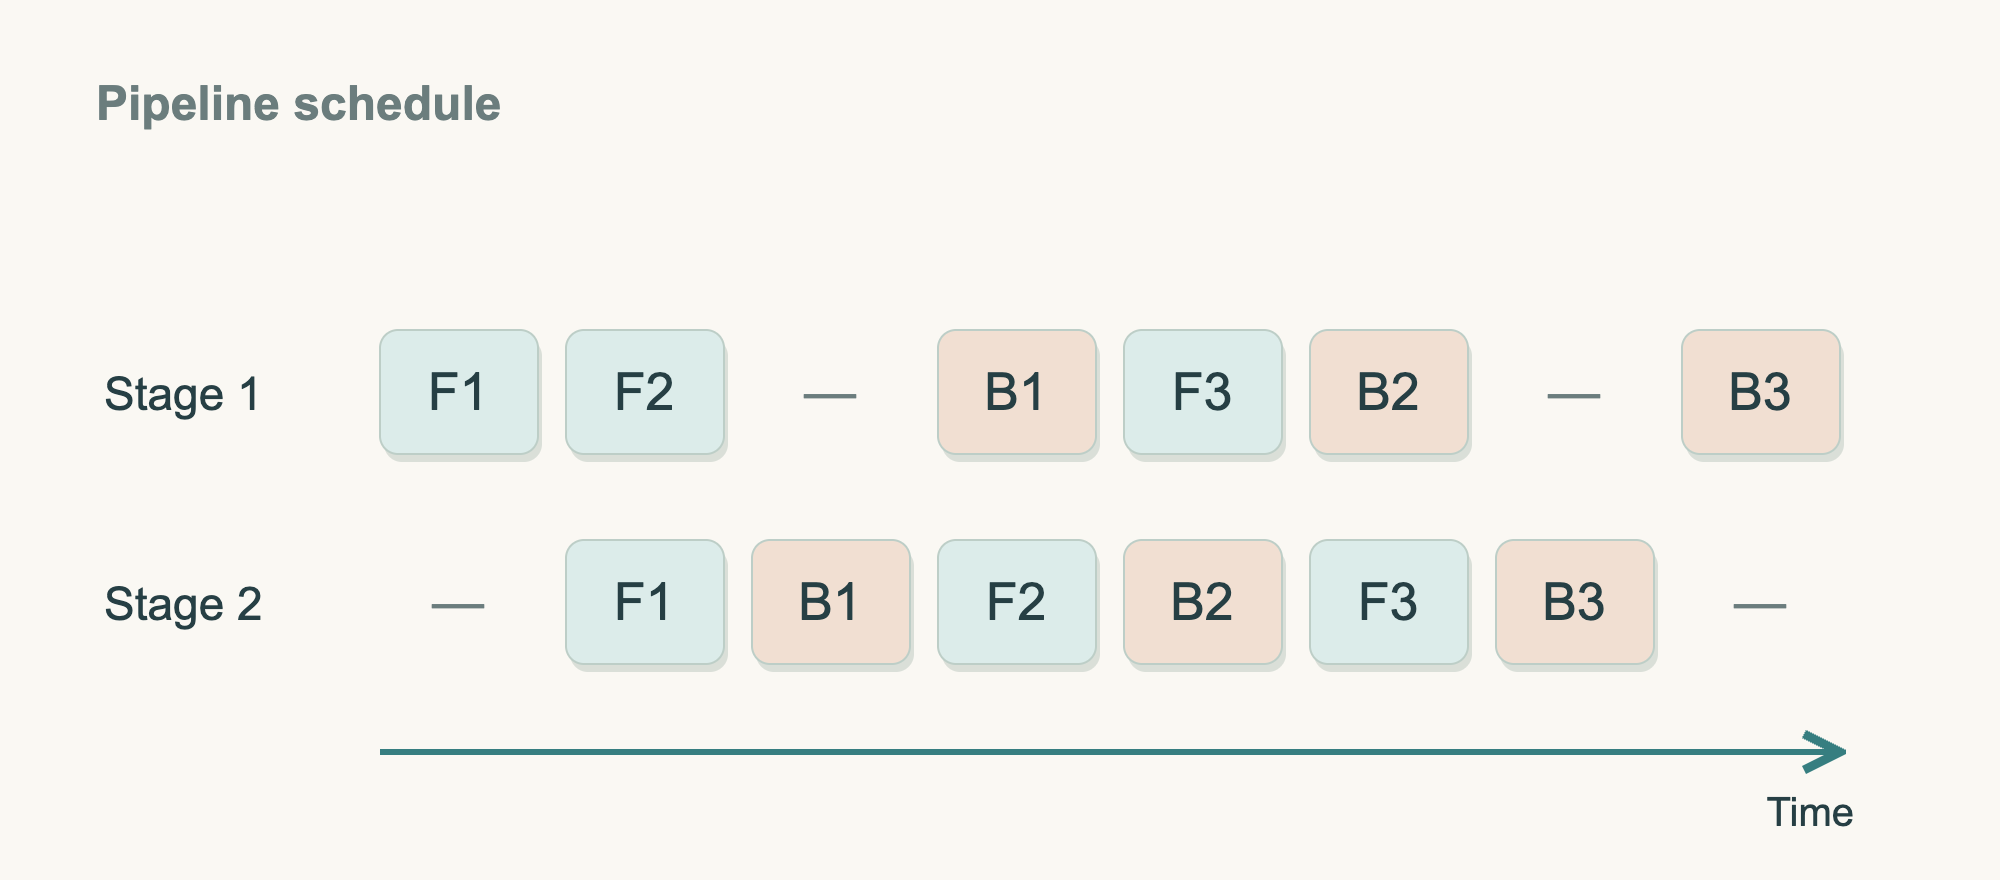
图只画两个阶段、三个小批。沿1号走:第一阶段F1完成,第二阶段才能F1;第二阶段B1完成,第一阶段才能B1。2号、3号利用前一批向前走的时间陆续进来。F、B是计算,短横线是等待,等宽格只用来表示顺序。末尾不再送新批,各段做完剩余反向,流水线才收尾。
启动和收尾仍有空泡。小批少,空等比例大;一口气塞很多小批,一次参数更新前读的材料又变多。提高设备利用率与选择学习节奏,在这里碰到了一起。
先把批量账算清。每组一次送1条序列,连续32个小批,80组同时读不同材料,一次更新累计:
1条 × 32个小批 × 80组 = 2,560条训练序列
将序列长度取4,096,全部位置计入训练,就是10,485,760个token。乘80,因为80组读不同材料;组内64卡合作处理同一批,不再乘64。Megatron小批计数器也以全局批量、小批数与DP组数建立这种关系。
32与4,096先把算法摊清楚,正式批量、长度留到下一篇结合显存、空泡与学习效果选择。这样每次扩机器,都能说清究竟是一次更新多读了材料,还是同一批材料更早算完。
微批量:一次送进流水线的小批材料。
梯度累积:先把多个小批产生的梯度累积起来,再进行一次参数更新。
全局批量:一次参数更新累计使用的全部训练样本,包括各数据并行组处理的样本。
流水线空泡:流水线启动、收尾或工作不均衡时,一些阶段等待其他阶段的空闲时间。
1F1B:流水线进入稳定阶段后,交替安排一次前向和一次反向的调度方式。
展开看:本计划先用哪一种流水线调度?
调度先选普通非交错1F1B,一台负责连续一段,沿现有Megatron安排运行。把阶段再拆为多个虚拟阶段的交错调度,也能改变空泡与通信;先测清普通方案,再用相同模型与批量比较这层额外安排的价值。
计算放下了,更新参数的账本还太大
模型切开以后,再看显存清单,还有一大块没处理:参数更新需要的账本。计算权重分好了,更新记录也可以继续分。
每个参数通常保留高精度主副本,以及优化器决定步幅所用的历史。80组更新同一套参数,重复存80份记录,占用就很可观。
展开一个参数,它有计算副本、精细更新用主副本,再加Adam两份历史,分别跟踪梯度方向与大小。第十六篇再细看更新算法。现在先决定谁保管这页账:80个对应成员共同需要一个参数,可以让其中一位负责更新,再把新计算数值交回其他成员。
我启用Megatron分布式优化器,把记录分给对应DP成员。每卡领到自己负责部分的汇总梯度,用账本更新,再把新计算权重分享回去。计算副本齐全,更新账本分开,0.19.2官方说明给出了这条数据流。
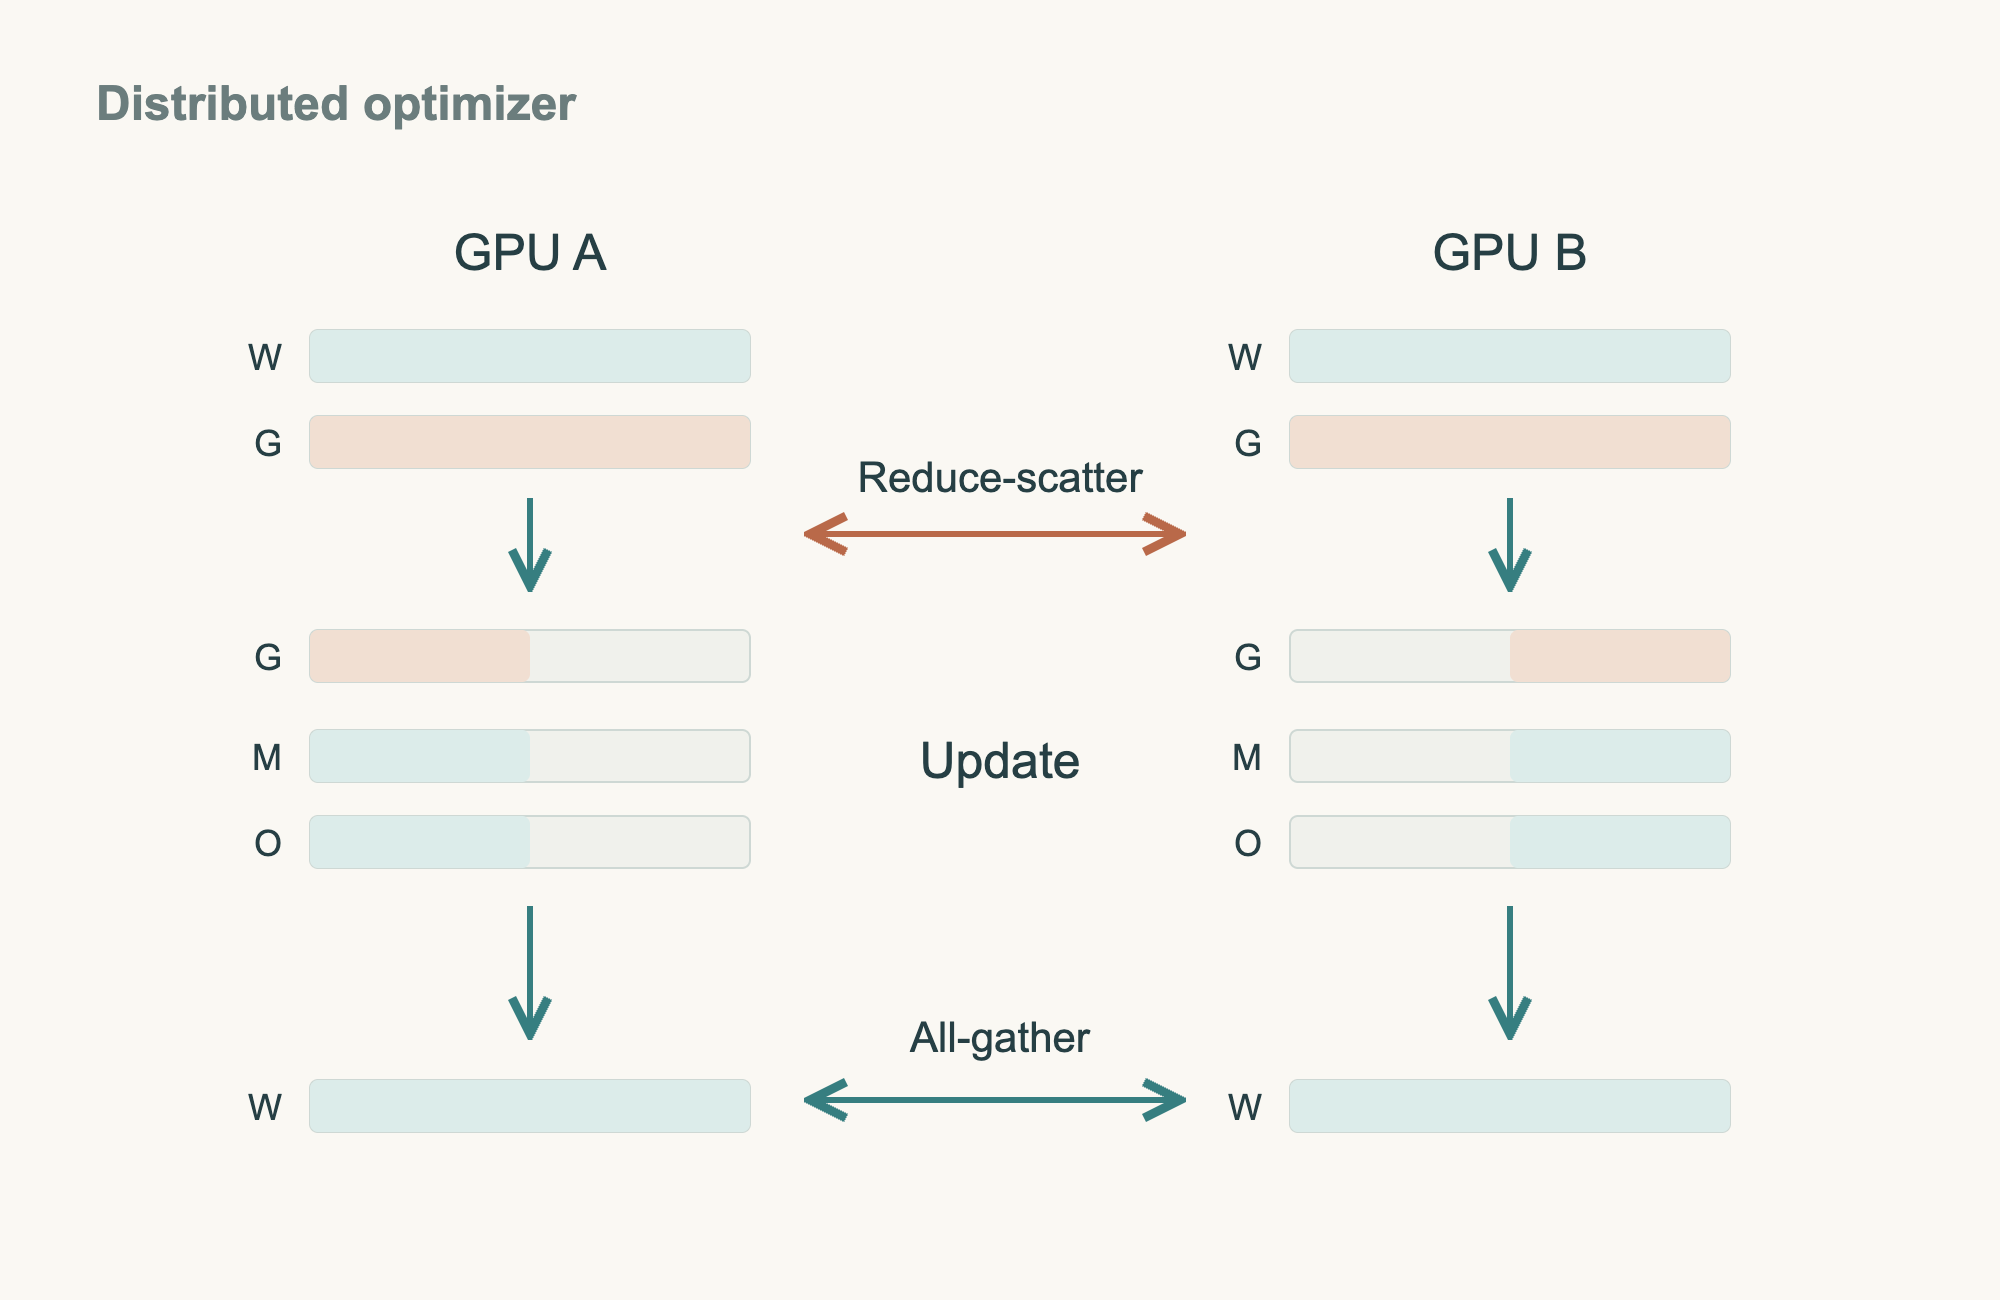
图里W是计算权重、G是梯度、M是主权重、O是Adam历史。横条是一块状态,半条是进一步切出的份额。两个DP成员计算时都有对应BF16权重和FP32梯度缓冲;更新时先汇总梯度,各领自己的部分,用本地M与O更新,最后交换新W。下一轮所需权重重新一致,较大的账本继续分存。两成员图缩小了数量,项目实际分摊给80个对应成员。
Reduce-scatter:把对应位置的数据汇总,再把汇总结果的不同部分交给不同成员。这里用于把汇总梯度送给负责更新它的成员。
All-gather:把各成员持有的不同部分收集起来,让每个成员都得到所需的完整数据。这里收集的是更新后的计算权重。
在2026年的实现里,怎样进一步减少等待?
数据该去哪里已经明确,接着在时间线上找等待。有一块梯度算完,就先传这块,同时继续做不依赖这次传输的计算;所需贡献全部到齐,再更新参数。原来空着的时间便有机会用起来。
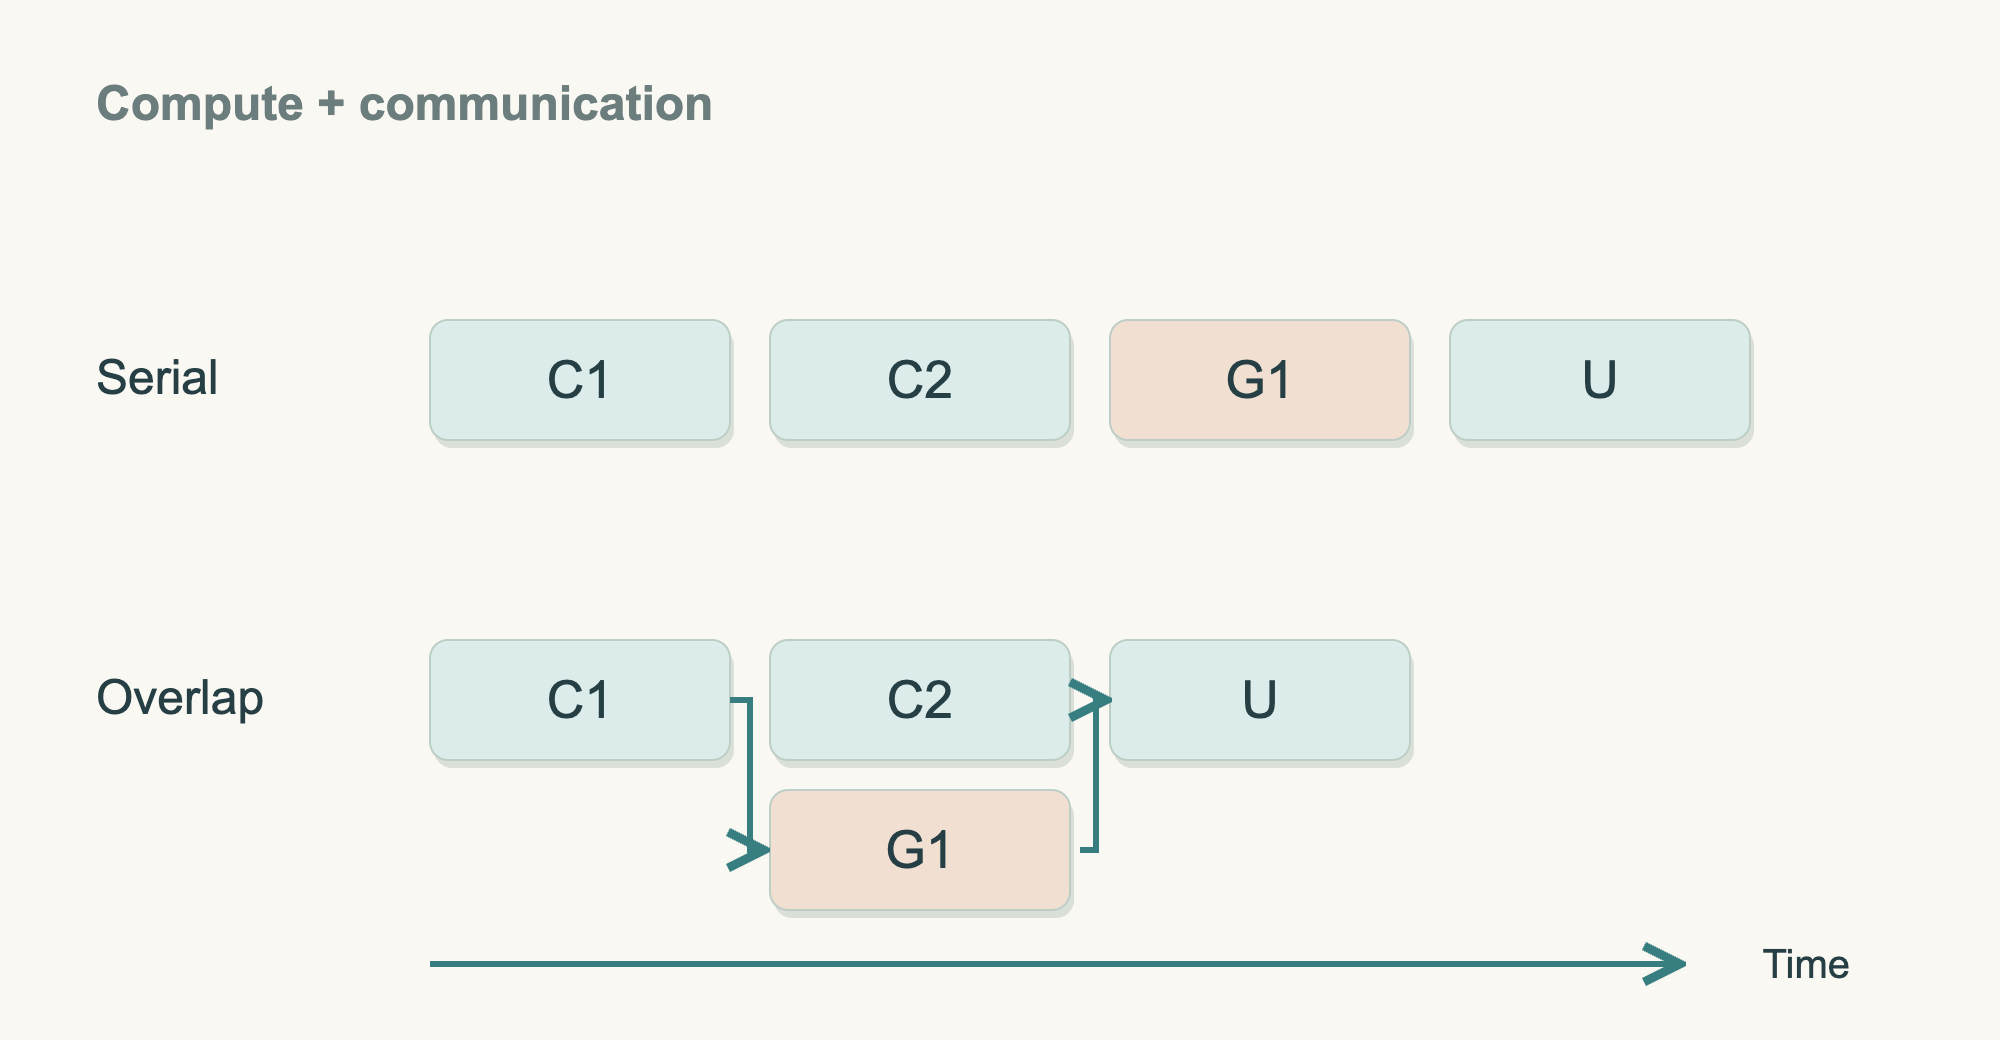
图中C1、C2是两段计算,G1传C1产生的梯度,U做更新。上半张逐件完成,下半张让C2与G1同时进行;依赖没有变,G1仍等C1,U仍等所需结果齐全。节约来自重叠那一段,等宽格只说明关系,实际重叠比例还得看训练时间线。
这类重叠已经发展多年,当前落地到2026年9月发布的Megatron Core 0.19.2。固定版本配置有梯度规约与参数收集重叠,默认都关。本项目目标开启两项,配分布式优化器;同版本参数校验支持它们与普通非交错流水线搭配。执行时先关着核结果,再逐项开启,对比峰值显存、每步时间与等待,开关是否值得就有了依据。
通信与计算重叠:当一块数据已经准备好时,在传输它的同时安排不依赖这次传输的计算。
软件口径定下来,显存账也能细化。前面按每参数16字节规划主状态,这里选BF16计算权重、FP32累计梯度和Adam状态,未分摊是18字节。多出的2字节来自更精细的累计梯度,500B主状态由8TB细化为9TB。再分摊账本,单卡压力就能继续降。
展开看:一张卡的主状态,怎样从约141GB降到约48GB?
这里用十进制GB,先按参数在TP8与PP8之间理想均分计算。每张卡负责500B÷64,约7.8125B个参数。真实模型的输入输出层、少量复制参数及阶段负载还要单独核对。
| 状态 | 每参数字节 | 本计划怎样放 |
|---|---|---|
| BF16计算权重 | 2 | 每个数据并行副本保留自己的对应分片 |
| FP32累计梯度 | 4 | 本实现保留主梯度缓冲区 |
| FP32主权重 | 4 | 在80个对应的数据并行成员间分摊 |
| Adam两份FP32状态 | 8 | 在80个对应的数据并行成员间分摊 |
未分摊时,每参数共18字节:7.8125B×18,约140.625GB。
启用分布式优化器后,官方给出的理论口径是每参数6 + 12 ÷ DP字节。代入DP80:
7.8125B × (6 + 12 ÷ 80) = 48.046875GB
这笔账包含表中的主状态。验收时还要测激活值、通信缓冲、临时工作区、内存对齐和各阶段不均匀带来的峰值。B200的180GB标称容量因此不能直接减去48GB,就当作所有可用空间的保证。
第十三篇的7TB检查点口径保持不变:保存2字节计算权重、4字节主权重和8字节Adam状态,共14字节每参数;参数更新完成后的这份存档不保存梯度。分片改变各台机器负责保存哪一块,不会把模型逻辑状态的7TB乘80。
要进一步少存权重,还有FSDP。它把权重、梯度和优化器状态也拆给DP成员,轮到计算时再收齐。我们先走TP、PP与分布式优化器,频繁层内协作留在同机8卡,沿既定Megatron路线验收。FSDP留作相同任务下的显存与跨机通信对照,PyTorch说明可以沿着它的收集过程读。
展开看:FSDP怎样把权重也分开保管?
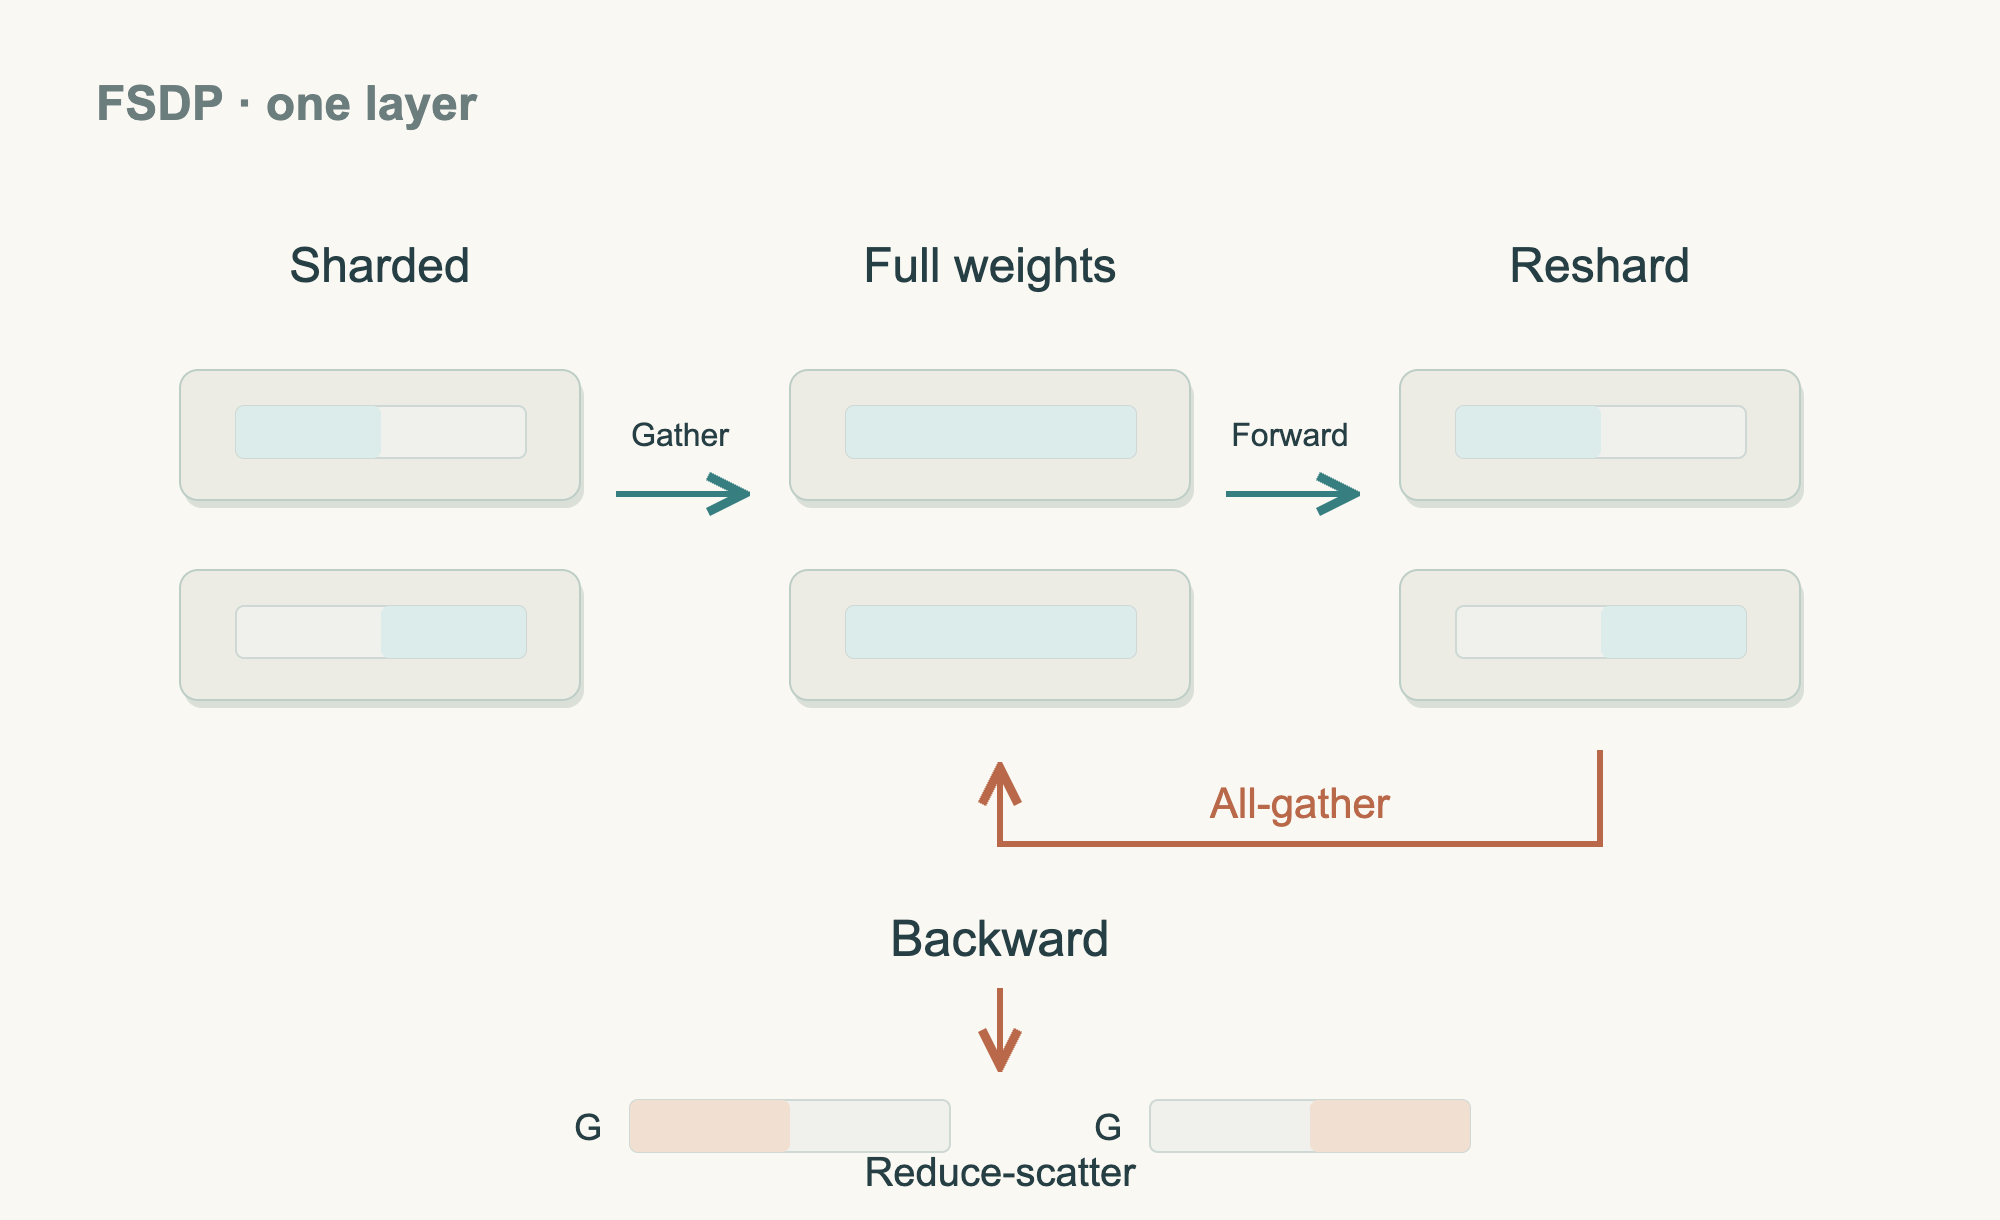
沿图中的一层走一遍:青绿色条表示权重,陶土色条表示梯度,带颜色的半条表示该成员持有的分片。平时每个成员只保管它分到的权重、梯度和更新记录;轮到这一层计算时,先把本层需要的权重取齐。采用计算后重新分片的安排,这一层前向完成后就释放临时收集的完整权重,反向需要时再收集。反向算出的梯度汇总后,仍按分片交给各自的更新者。这样节省了长期驻留的显存,也增加了取齐权重的通信。这是用来比较的另一条路线,本计划仍先采用前面选定的组合。
2026年的实现也在继续细化这条路线。2026年8月的Megatron Core 0.19.0发布记录列出了FSDP前向权重收集重叠和混合分片方面的改进。当前版本的HFSDP说明进一步把成员分成内外两层:权重与梯度在内组分摊,较大的优化器记录跨全部成员分摊。
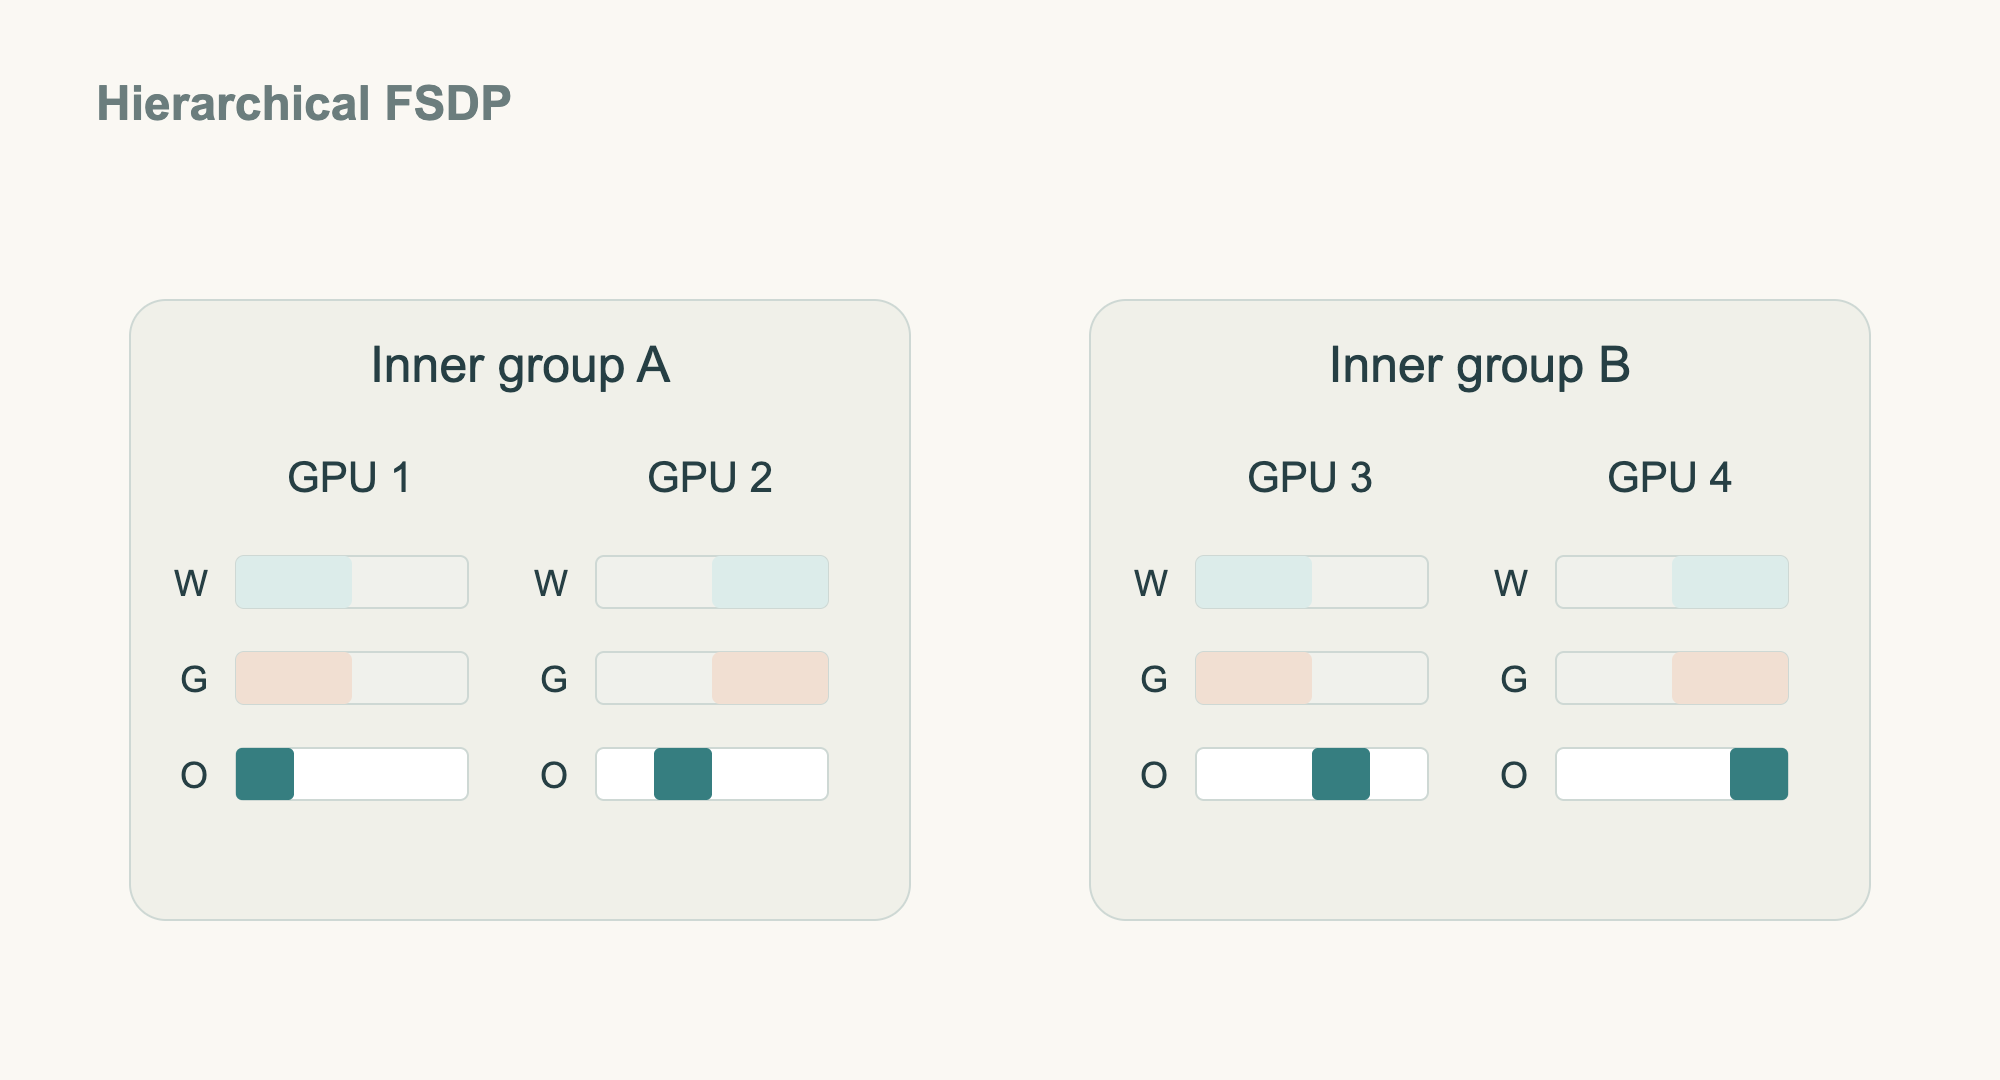
看图里的两个组:两组都凑得齐同一份W和G,但各自的两个成员只拿一半。O表示优化器记录,四个成员各拿四分之一。这样可以把频繁取齐权重的工作限制在较小的内组里。这是显存受限时值得实测的另一种设备分组;我们现在一台8卡已经用于TP,比较HFSDP时要重新安排这些组,核对通信究竟发生在机内还是跨机。
优化器状态:优化器保存的历史记录,用来决定参数这次怎样更新。Adam为每个参数保存两份这样的状态。
分布式优化器:把更新参数所需的主权重和优化器记录分摊保存,并协调梯度汇总、参数更新和权重同步的实现。
把所有切法放回同一张卡数表
回到最初那张1TB与180GB的容量对照,分工现在能写成一行:同机8卡分层内工作,8台前后接力,整组复制80份,更新记录再分摊。
TP 8 × PP 8 × DP 80 = 5,120张GPU
同样的卡组里,再启用Megatron序列并行,减少部分操作重复保存的激活,无须另乘卡数。首轮CP1先不增加上下文切分,把三种主要分工验清;长序列带来更大压力时,再测额外切分,并重算DP组数。
展开看:序列并行、上下文并行和专家并行放在哪里?
序列并行会把部分操作中的激活值沿序列维度分开,常与TP搭配。它和张量并行共用已有的卡组。Megatron并行指南列出了相关设置。
上下文并行CP会把同一条长序列的处理分给更多设备,注意力仍通过通信取得需要的上下文。它可以降低单卡激活压力,也增加了新的通信安排。原理与支持条件见官方CP文档。本计划先用CP1作为验收基线;假如长序列阶段采用CP2,同时保持TP8和PP8,5,120张卡对应的DP就变为40。
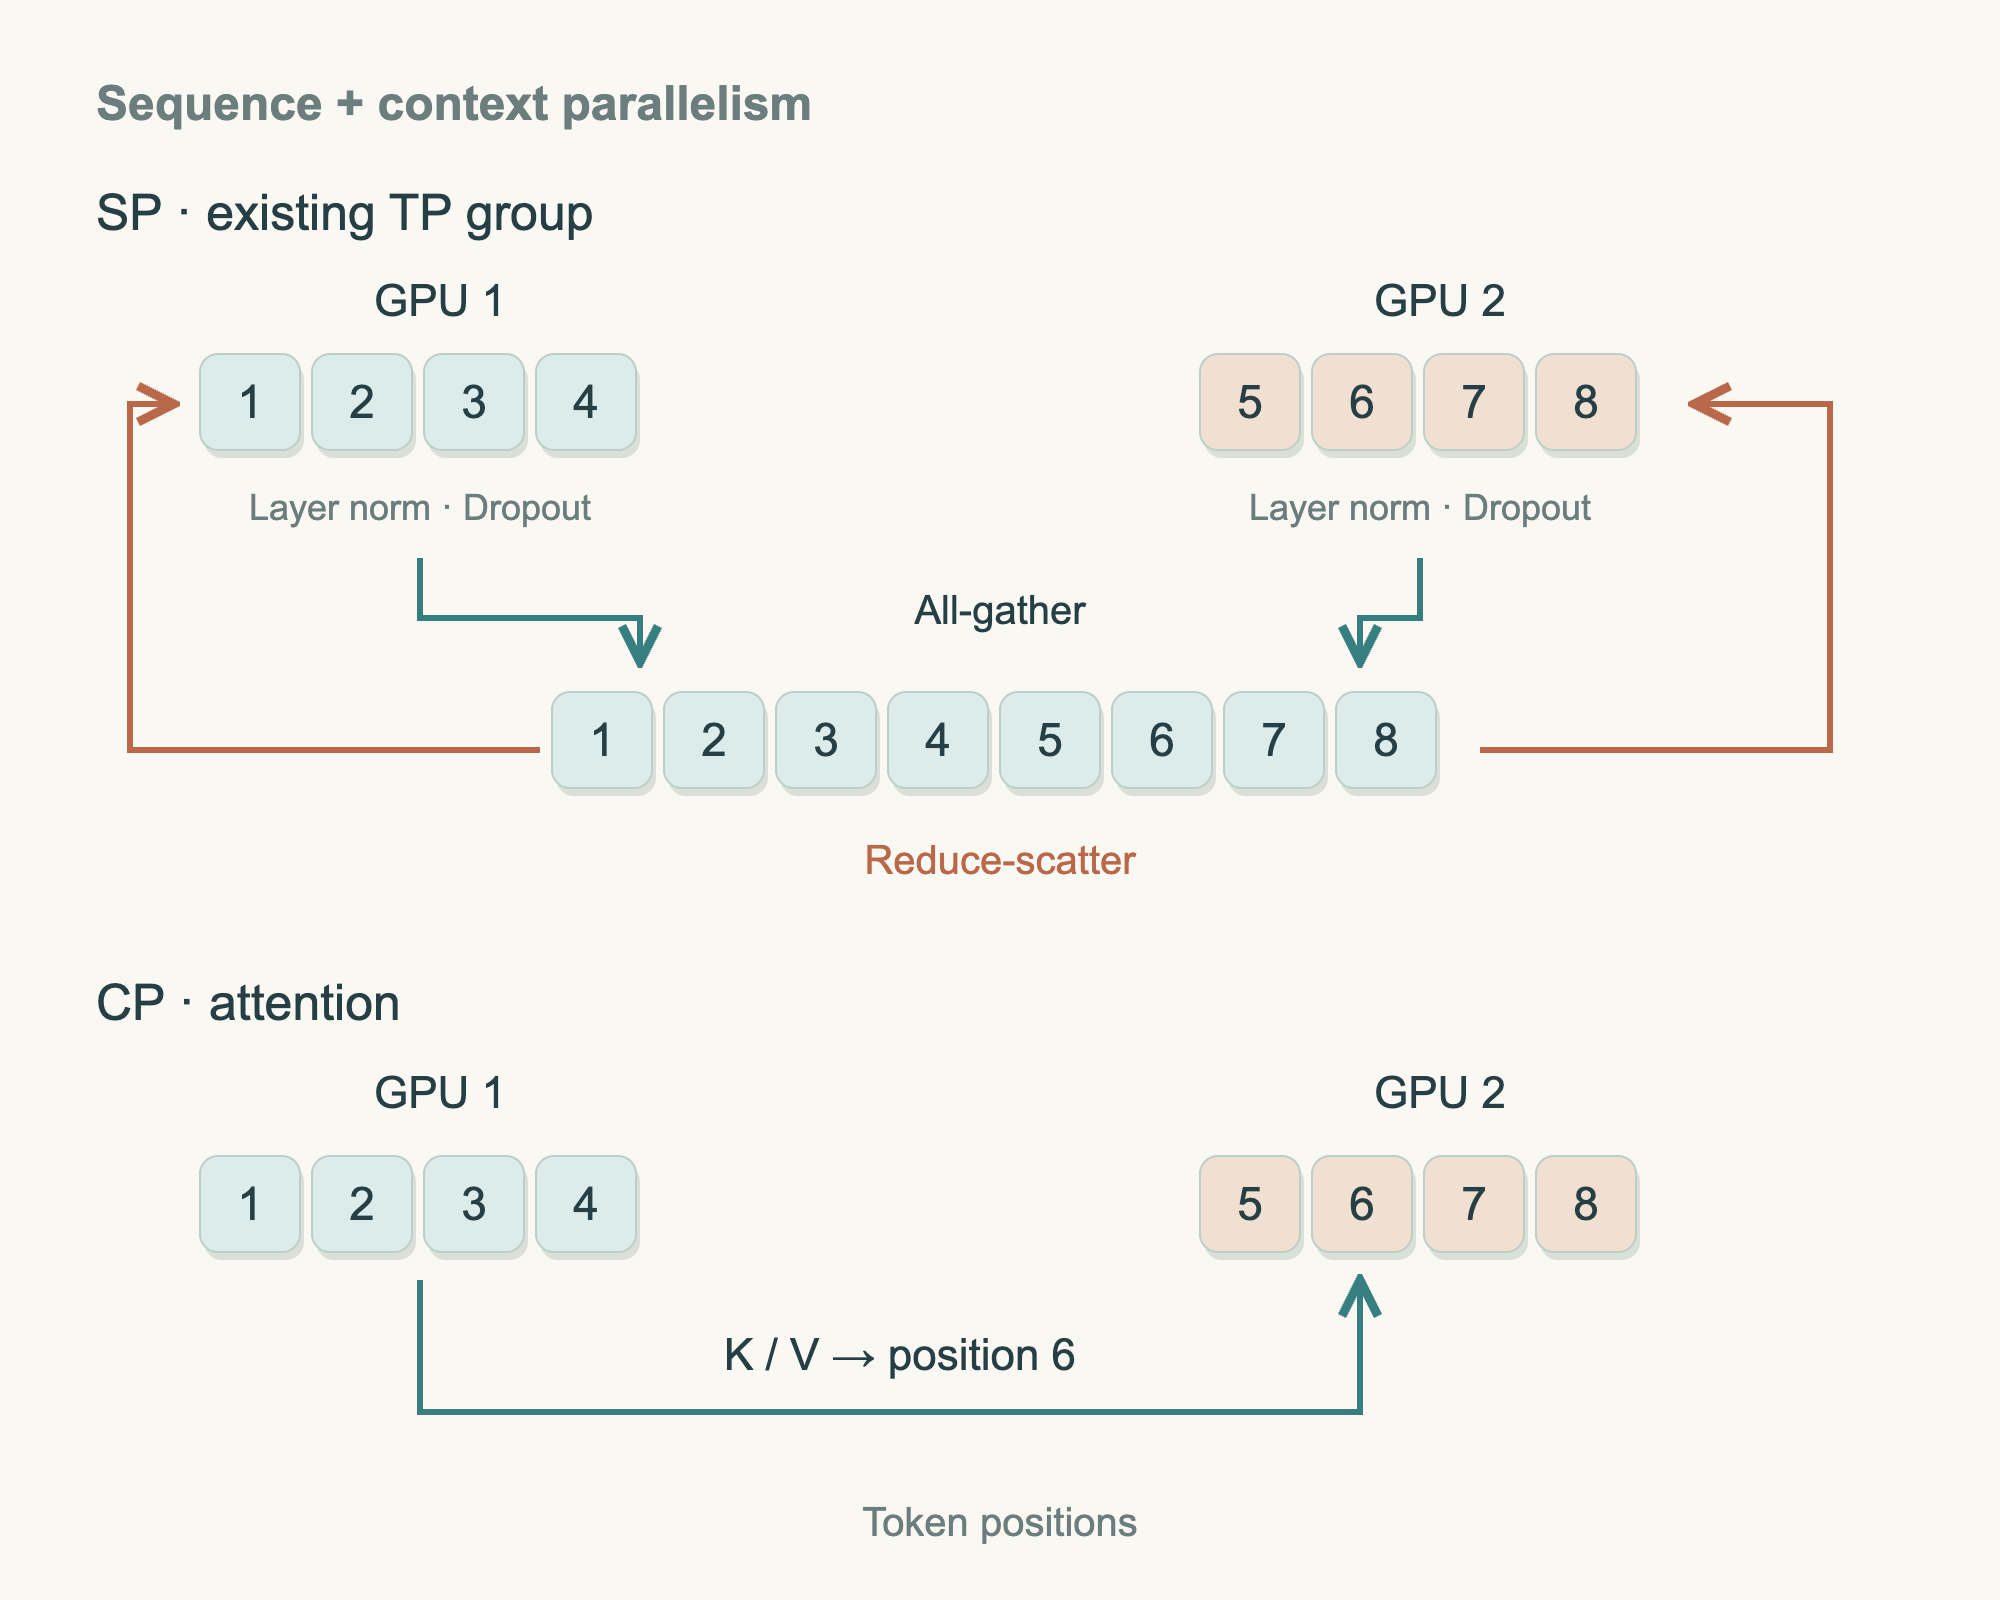
图中1到8标的是token的位置,不是向量中的数值。每格背后都有该位置的一整组激活值,也就是一个向量。图中的每个GPU成员是一张卡,不是一整台服务器。
先看上半张图,同一条序列的位置1到8,在已有TP组内分给两个成员。它们分别保存并处理layer norm、dropout等部分操作对应的激活值。图中All-gather表示在需要完整序列激活的位置收齐分片,Reduce-scatter表示汇总后把相应结果重新分片;这些通信按前后计算及反向传播的要求安排。这是序列并行,没有再增加一组设备。
下半张图则把长序列的处理放进一个新的上下文并行维度。两个成员分别负责不同位置,计算注意力时仍要交换需要的上下文信息,才能把整条序列的关系连起来。图中以位置6读取前面位置的K/V为例;训练反向时,相关梯度也要在成员间传递。图中按连续位置切开只是便于理解,实际实现还会安排位置分配以平衡工作量。
图中的layer norm是层归一化,用于调整一组数字的尺度;dropout是在采用它的训练配置中随机屏蔽部分值的操作。K和V则是第六篇讲过的注意力键和值,当前token通过它们取得允许阅读的上下文。
长材料的长度也可能每批都不一样。NVIDIA在2026年1月介绍的Dynamic-CP,会根据每个微批的实际长度与工作量选择上下文并行规模:短材料少分设备,长材料多分设备。它面向变长材料的装配方式。
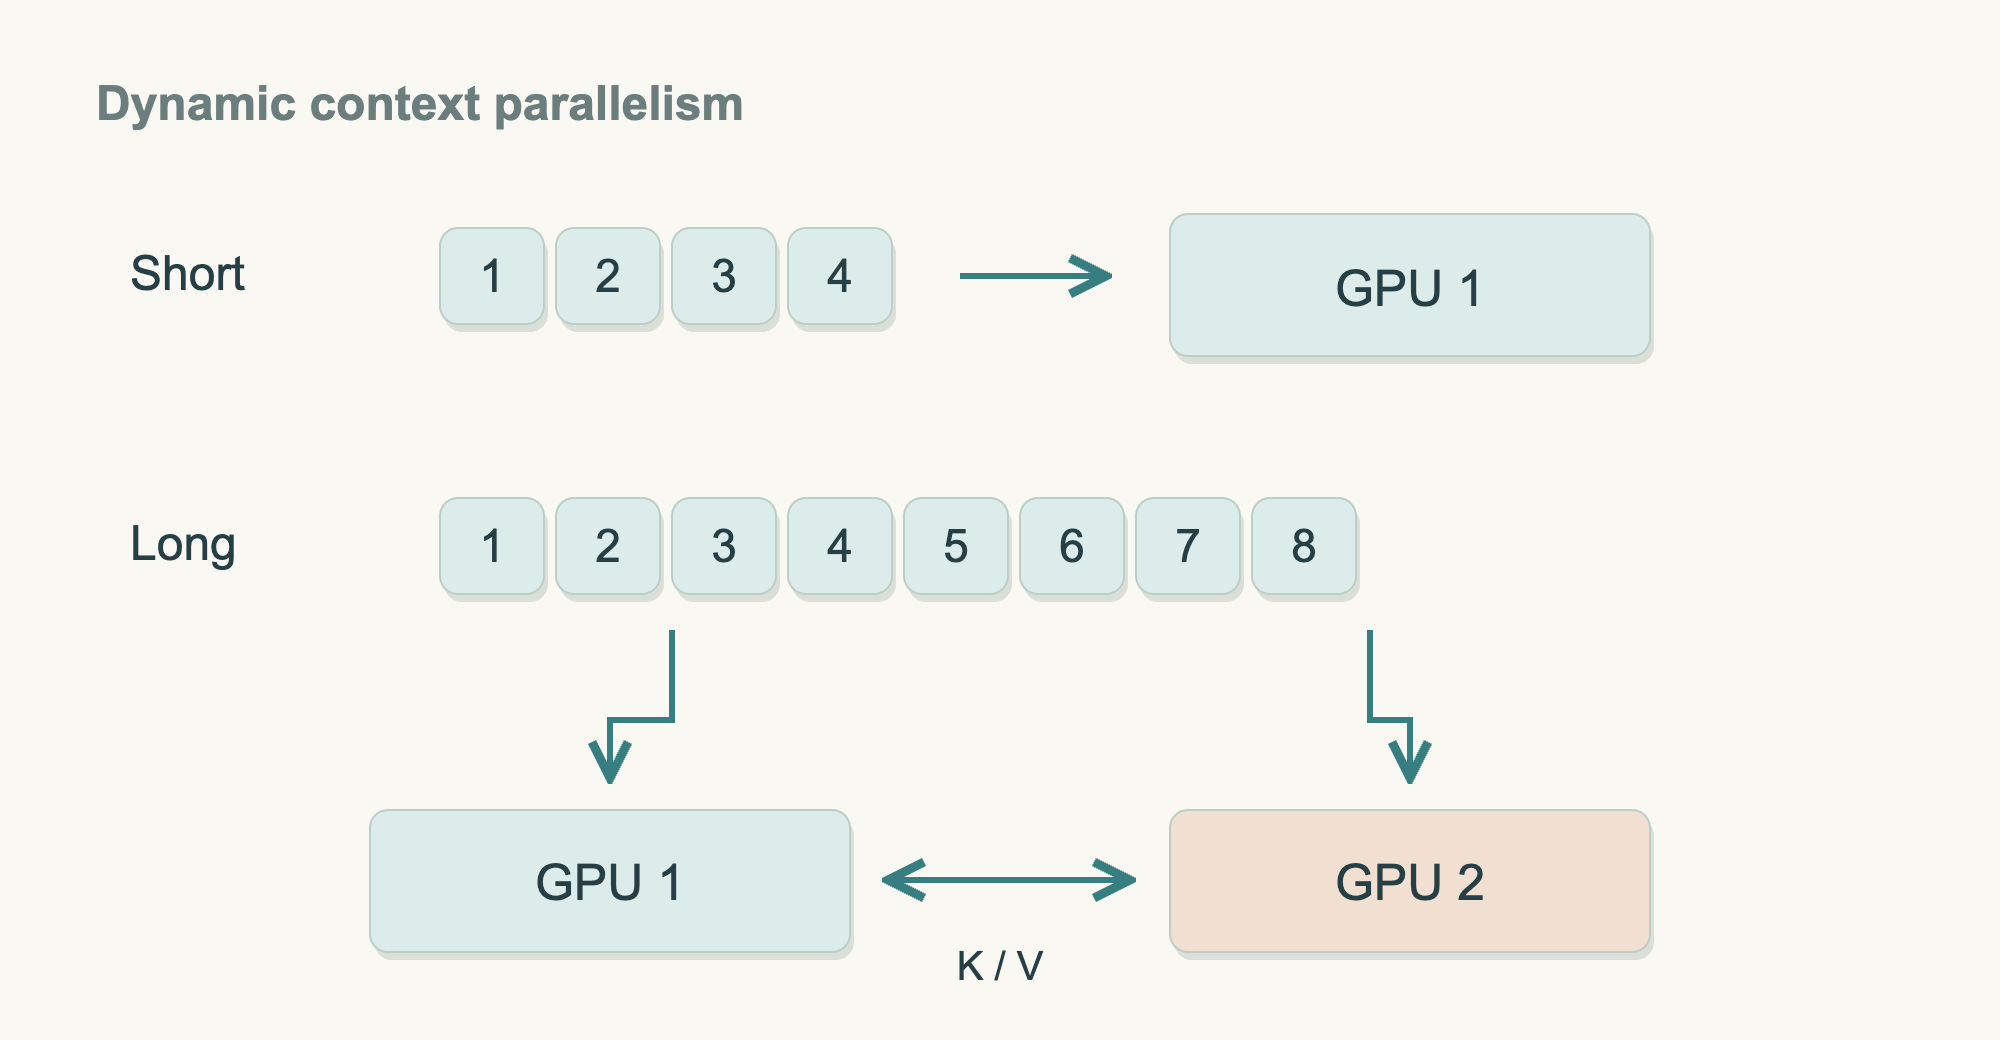
图中短材料交给一个成员,长材料分给两个成员,长材料仍通过通信取得注意力需要的上下文。这里用4格和8格画长短对比,实际切换由工作量和配置决定。我们首轮按固定序列长度建立CP1基线;进入长上下文或变长材料阶段,再把静态CP和Dynamic-CP放在相同有效token量下比较。汇总训练误差时也按实际参与学习的token统计,短批和长批的贡献与各自的有效数据量对应。
专家并行面向第五篇讲过的MoE,把不同专家放在不同设备上。本系列当前的采购和训练目标是500B稠密模型,这份方案使用稠密模型的分工。
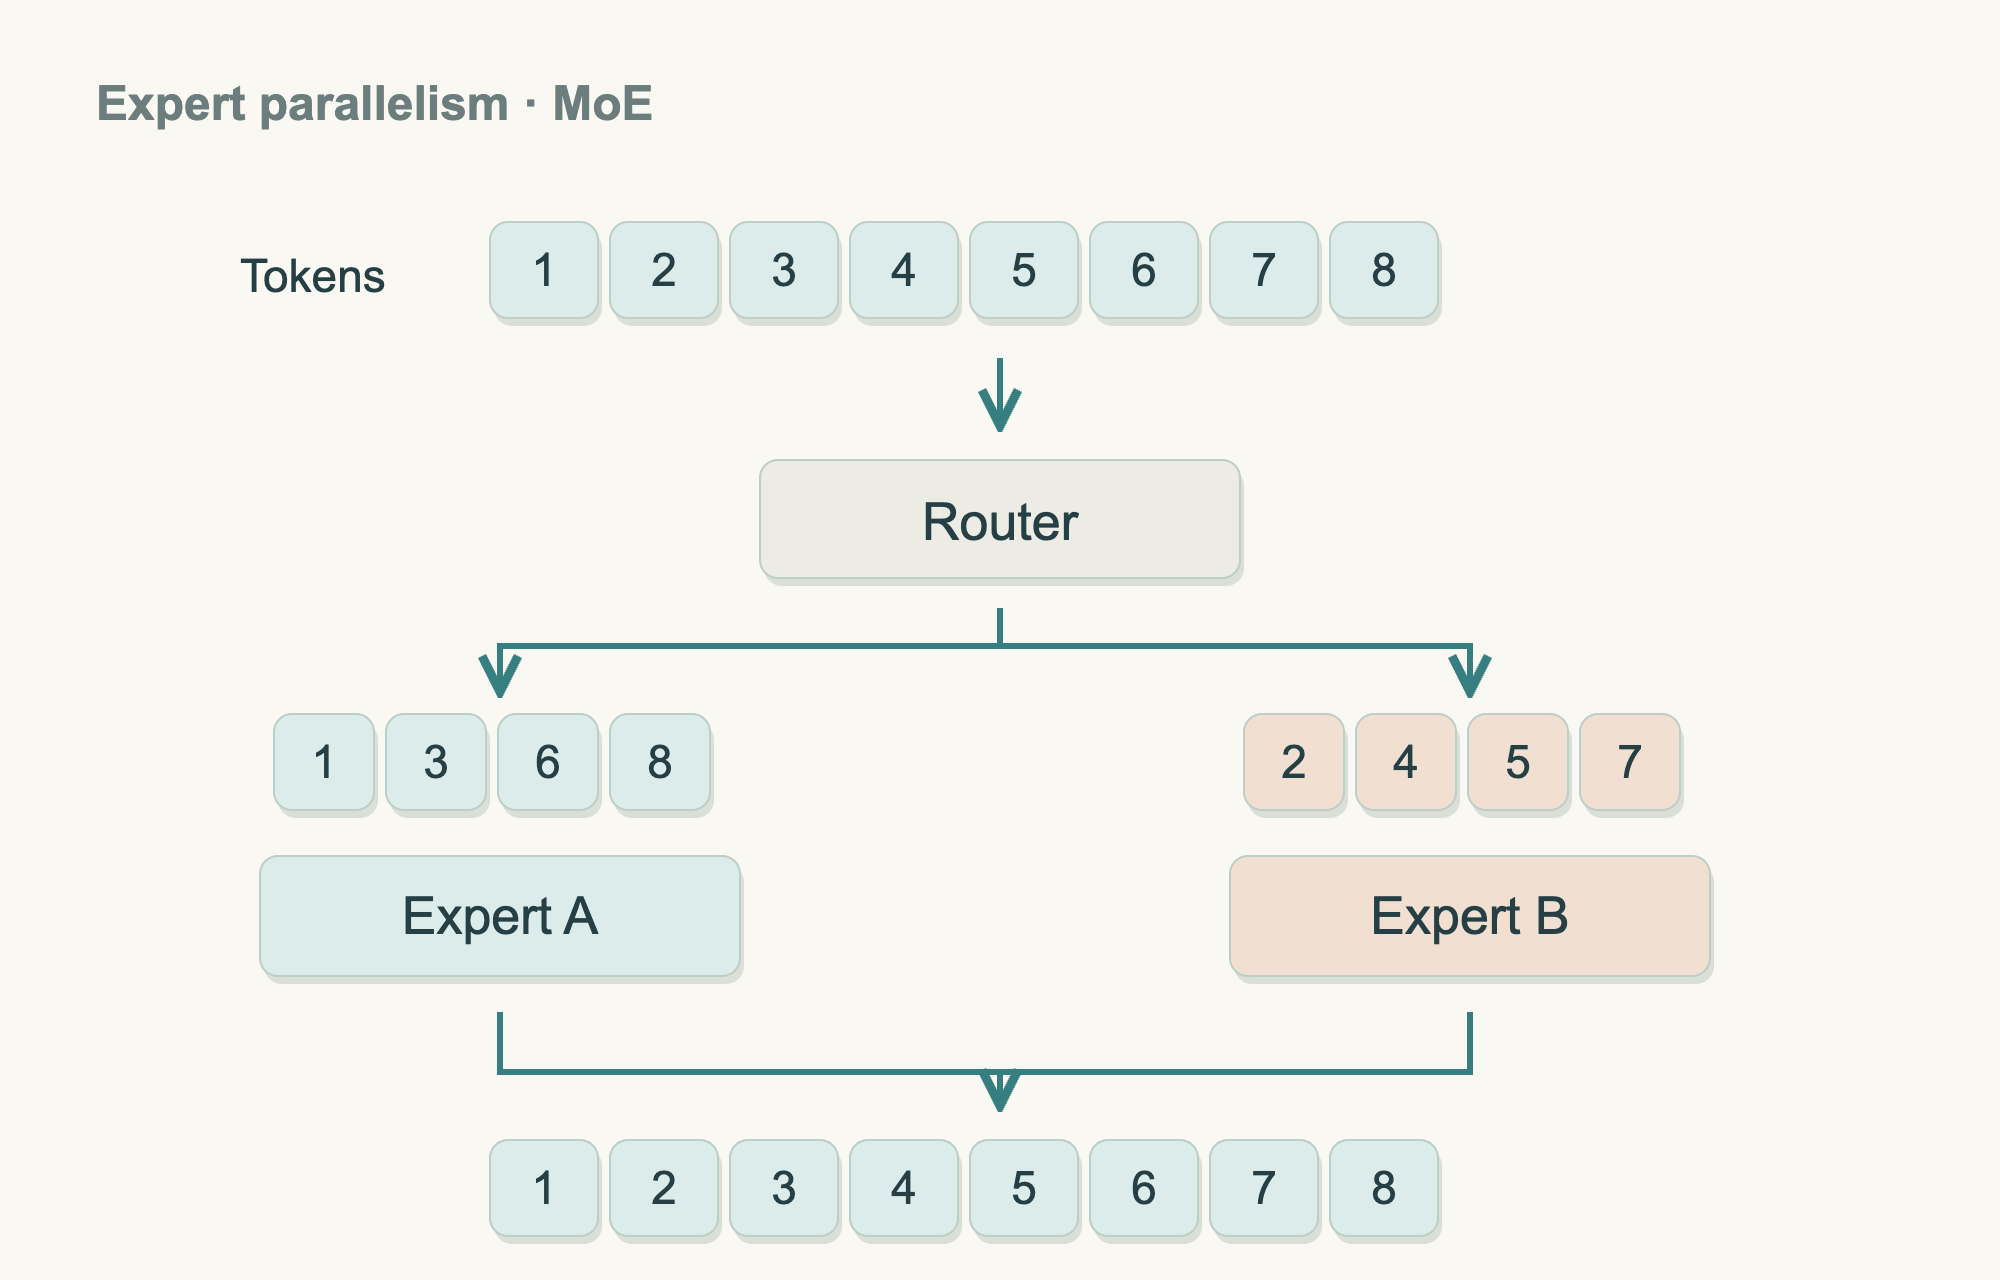
图中1到8代表token的位置,每个位置背后都有一个向量。每张GPU上的专家各持有一组神经网络参数。路由器为各token选择专家,把相应向量发送到专家所在设备;专家算完后,结果送回并按路由权重组合,再恢复原来的token顺序。这里拆开的是专家的位置,各token可以选择不同专家。图中为了容易看清,每个token只画了一条专家路径;实际配置也可以为一个token选择多个专家。这对应MoE模型,本计划的500B稠密模型采用的是前面说明的TP、PP和DP组合。
长序列带来的中间结果还可以通过重计算减少保存:保留必要输入,反向时重新算出部分激活值。这会增加计算量。我们先测所选序列长度的显存峰值,再比较选择性重计算的代价,相关实现见官方激活重计算说明。
序列并行:在现有张量并行组内,把部分操作需要的激活值沿文字位置分开保存与处理。
这套分工,怎样交给上一篇的软件执行?
纸上的分工还要变成能运行的任务。我回到第十四篇环境,提交640台、每台8卡的资源要求,指定镜像与TP8、PP8、CP1。程序根据5,120个GPU进程推导出DP80。
Slurm先分机器,由节点启动器按每卡一个进程启动,共5,120个。Pyxis通过Enroot把进程带进选定容器,各机器拿到同一套软件与配置,已装驱动和运行环境提供GPU访问。
机器分配以后,Megatron才按照配置拆模型、建通信组、排计算。拿第三阶段第二张卡看,它有同台共同算层的伙伴,有前后阶段,还有其余79份模型里的对应卡。固定版本分组实现分别建立这些关系,调度再安排各小批的前向、反向与更新。
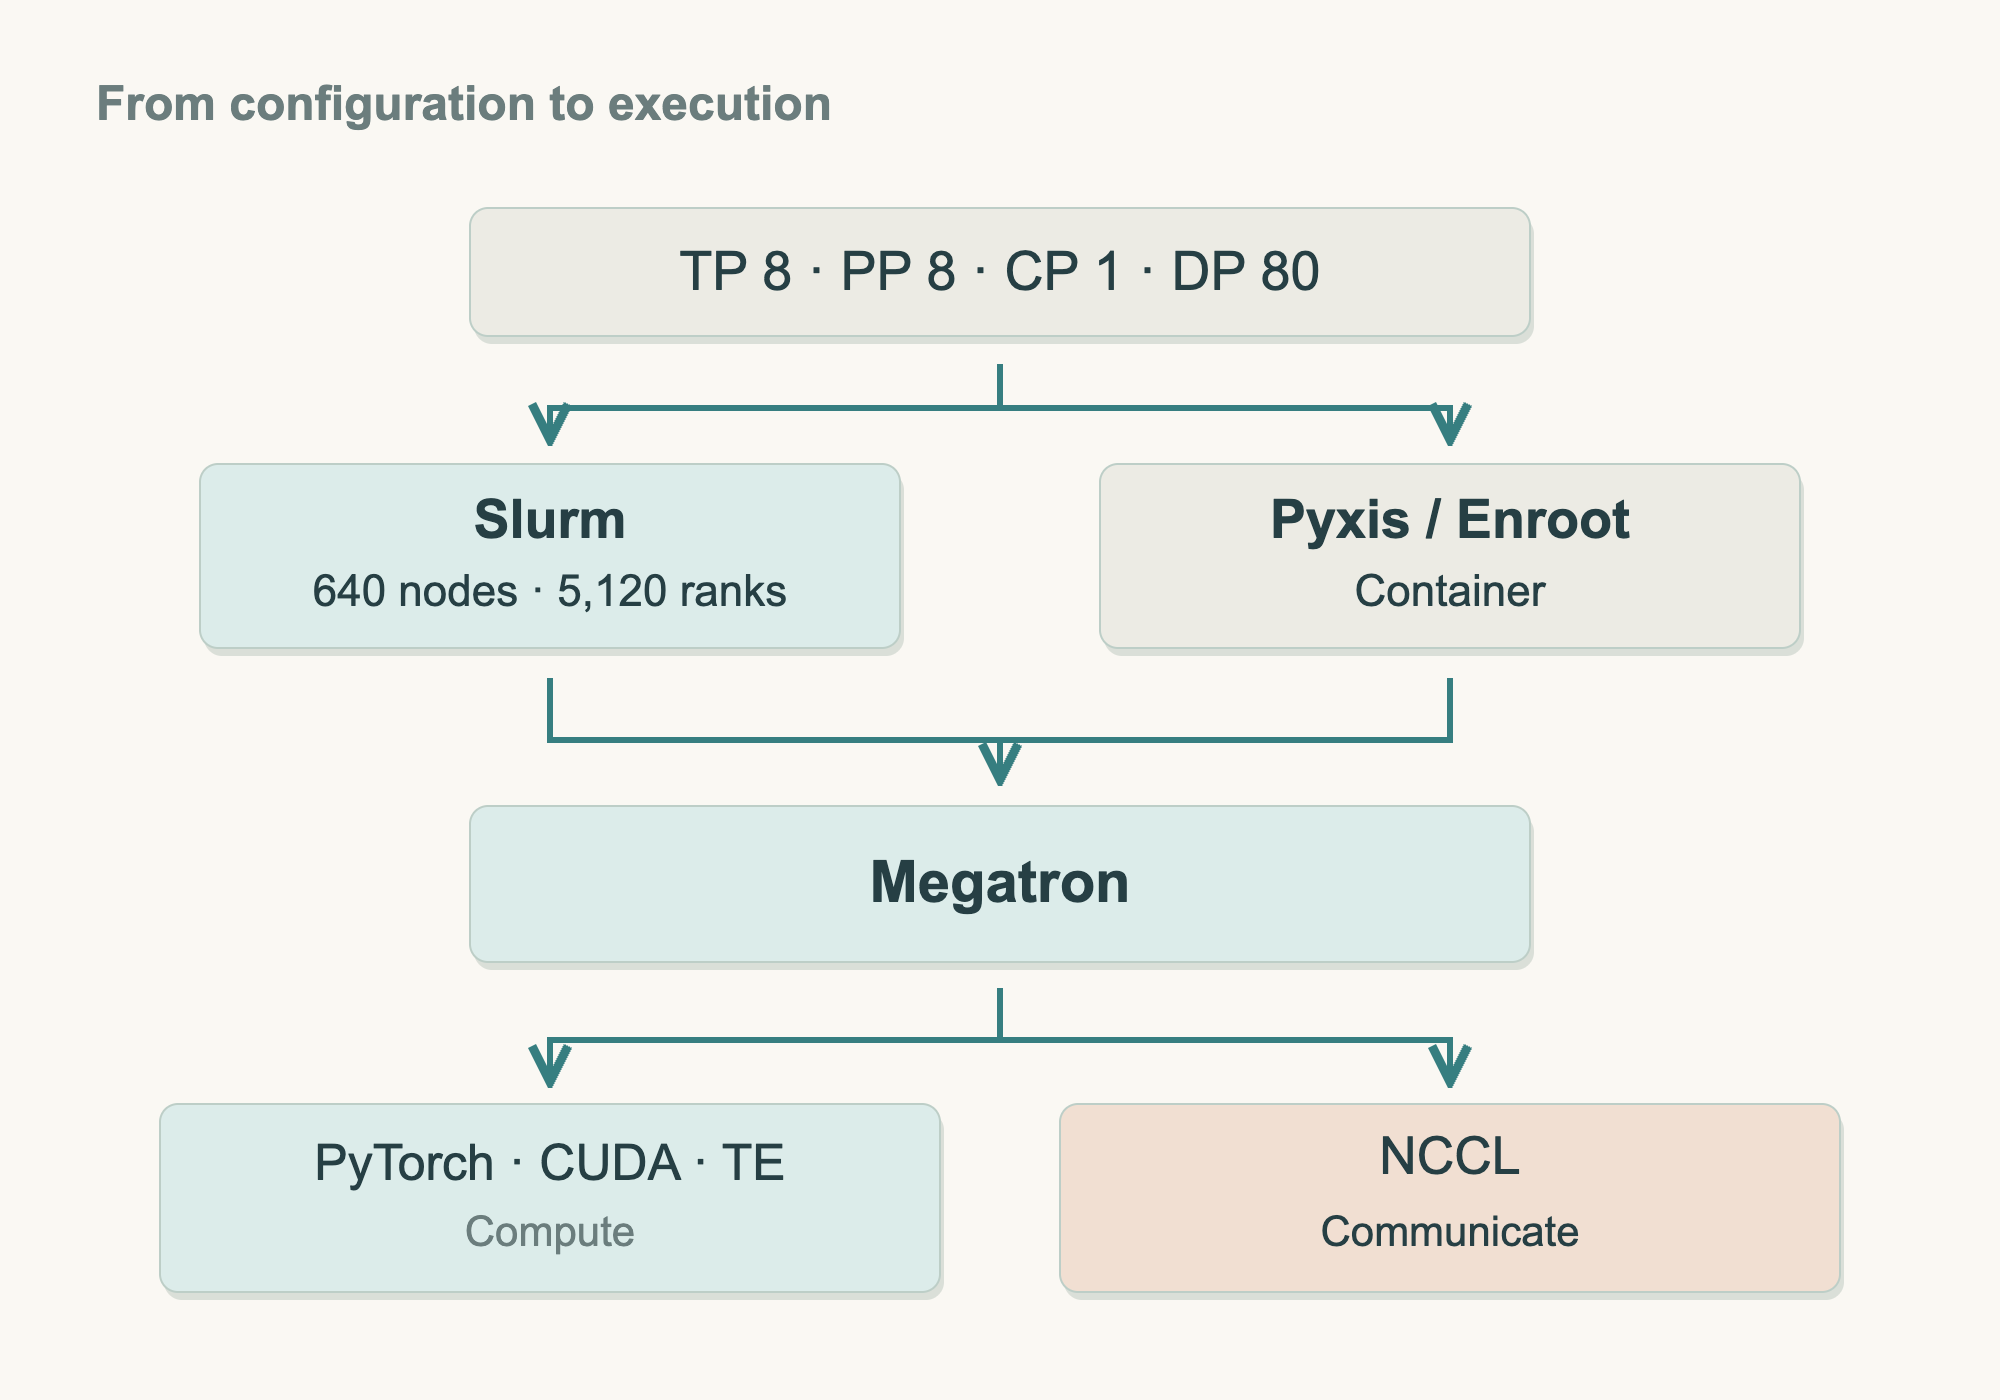
沿图向下,资源要求先成为训练进程,Megatron给它们模型与材料。PyTorch做张量计算、自动求导,CUDA与Transformer Engine等实现交给GPU执行;需要交换结果,框架通过PyTorch分布式接口及NCCL等路径通信。机内走NVLink、NVSwitch,跨机走InfiniBand,两条路都在正式训练前验收。
这也把上一篇那些软件名字重新对到了具体工作:Megatron决定何时和谁通信,NCCL执行交换;Slurm管资源与任务,Pyxis和Enroot负责环境。更新完参数,再按第十三篇写检查点,这条软件链才闭合。
验证仍从小模型起,比较切分前后的计算与更新能否在约定误差内对上,再放入目标模型,看每阶段峰值显存、耗时、等待和通信。输入输出太重就调阶段边界;等待太多,在相同模型、批量、长度下比较切法。每一次调整,都要对应一个已经找到的问题。
80组逐步加入,扩容始终记录实际token吞吐、一次更新材料量,以及恢复后能否接续。第二篇估算的工期,最终用这组测量校准。
最初放不进单卡的模型,如今每一部分都找到了负责的机器,同一张卡也有三类协作伙伴。但一次更新该喂多少材料、步子迈多大,尚未确定。下一篇把批量、序列长度与更新节奏放进同一配置,继续决定这5,120张卡每次究竟怎样学。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。