你需要一台属于自己的智能电脑
1,326 次阅读
你的私密资料应该留在自己手里
你越想让 AI 帮你把一件事想明白,就越得把实情告诉它。比如要回一封棘手的邮件。对方上回答应了什么,后来又改了什么,你已经说过哪些话?这些得让 AI 知道,它才能帮你回。你要是把来往邮件原封不动地发给云端 AI,服务商也会看到这些话。
哪封邮件传出去会伤到你,哪份文件里有别人的隐私,你自己最清楚。你想锁起来的东西,到了每天处理大量文件的公司手里,也就是又一个附件。发出去以后,服务器上可能留一份,帮它处理数据的第三方也可能经手。权限有可能配错,系统有可能被黑,经手的人也有可能故意挪用。中间只要有一处出岔子,那份文件会跑到哪里、被谁看到,你就很难管了。
你本来只是在跟 AI 商量,想到一种可能就顺口说了出来。别人要是截走那一句,就能说你早有这个打算。厂商可以修系统、发通知,你说过的话已经传出去了。到头来,得开口解释的还是你。这种事已经发生过。ChatGPT 那篇 · Claude 那篇
哪怕只有一条消息是你不愿公开的,也别把它交给云端大模型 API。这时候,有一台自己的智能电脑就很重要。你可以把邮件原样给 AI 看,让它照着实情帮你拟回复。邮件和草稿都留在自己电脑上。
模型负责读邮件、写回复。还有一层叫 Harness 的软件,负责打开你选的文件,把内容交给模型,再把草稿存到你指定的地方。两样接起来,就是一个能替你干活的 Agent。让它们都在本机跑,只给 Agent 这次干活需要的文件权限。
你的 AI 不应该拒绝你
帖子已经写好了,你只想让 Agent 把草稿填到网页里,等你看完、点头再发。它要是连粘贴这一步都不肯做,你就得自己找回那个页面,把文字贴上去,接着往下做。你把活交给它,本来就是为了省掉这几步。
你让模型用你的浏览器帮你发帖,它可能拒绝。你让 Agent 在 Robinhood 下单,或者请它分析个网络问题,也可能被拦。同一件事,在这台电脑上做得成,换一台又不行。有时候是商业模型拦你,有时候是 Codex 这样的商业 Harness 拦你。
偶尔接手一次也就算了。麻烦的是,你不知道它下一回会在哪儿停下来。比如一封邮件已经写好,收件人和正文你都看过,也跟它说了「可以发」。到了最后一步,它才说发不了。你只好打开邮箱,找到草稿,再自己点发送。账号是你的,邮件是你批准的,发出去这一步还要你伺候 AI 的情绪?
在自己的电脑上,你可以选社区做的 Abliterated 模型。社区改过它的权重,有些原来聊到一半会被截断的话题,换这个版本就能接着聊。让它读什么文件、动用什么工具,权限由你给。真要发帖,最后由你确认。
你的 AI 不应该被降智、降速
昨天你给 AI 两张表,一张是订单,一张是发货记录。它能把两张表对上,找出哪些单子还没发。今天你要排下午的货,又把同样两张表给它,连问法都没变。这回它连哪两列该对在一起都看不懂。昨天交给它就完了,今天你又得从头做。
有的厂商会先拿一部分请求试新版,看看跑得怎么样,也会改请求分给谁、模型怎么跑。你的请求要是刚好进了测试,你就成了小白鼠。屏幕上还是那个名字,谁知道背后给你跑的是哪一版?你照着昨天的结果排好了今天的活,现在仓库等着下午发货,你还得腾出手去救昨天好好的流程。
活做对了,回得太慢也来不及。云端算力紧的时候,API 请求有可能排队。GPT 的 API 就出现过可用算力下降、回复跟着变慢的情况。仓库要的那张清单,得先对表,再找出没发的单子,最后才能做出来。前一步没回,后一步就动不了。仓库在等你,你在等进度条。
模型和运行设置都留在自己的电脑上,明天打开还是你挑的那一版。能跑多快,看你手上这台机器。云厂商换不了你存下来的模型,也压不了你电脑上的速度。
你付的 API 费里,有多少是算力?
你掏钱用 API,等了半天,模型回你一句「这题不答」。你换个说法再问。还不行,再换一种。你都付钱了,怎么还得低声下气地求人?
2026 年 10 月,DeepSeek 公布了 V4.1 Flash 的部署数据。一套集群每天处理 155 万亿个 token,按 API 的低谷价折算,每张 GPU 每小时对应 38 美元收入。假设一张 GPU 用一小时要花 6.50 美元,只扣这笔钱,还剩 31.50 美元,约占折算收入的 83%。实际毛利得等服务的全部成本都算进去,才能知道。DeepSeek 官方部署问答
到了 2026 年 11 月,每百万输出 token,官网上 DeepSeek V4 Pro 的高峰价是 3.96 美元,Claude Opus 5.5 的标准价是 20 美元,GPT-6 Astra 的标准价是 50 美元。后两档大约是 DeepSeek 的 5 倍和 13 倍。单拿 3.96 美元做个算例。假设扣掉 GPU 成本还剩 83%,每百万输出 token 的 GPU 成本就是约 0.67 美元。就算给更大的模型把这笔成本翻一倍,也才约 1.35 美元。摊到 20 美元里占约 6.7%,摊到 50 美元里占约 2.7%。照这个假设,光是 GPU 成本翻倍,根本解释不了这么大的价差。
再翻翻 Anthropic 的账。2026 年前九个月,全公司收入 332.42 亿美元,收入成本 48.12 亿美元,花的基本上是服务客户用的算力和基础设施的钱。这么一算,公司整体毛利率约 85.5%。
有人凭本事拿高薪。可这么高的薪酬、这么高的估值,凭什么就成了理所当然?有的公司收你这么高的价,拿到高毛利,还坐到法官的位置上,管你能问什么。
你付了钱,问个问题还得求它放行,想用更强的模型还得盼它行行好。它什么时候限速、给你换成哪个更弱的模型,都由它定。这就是吸血。手里攥着算力,收了租还要管你怎么干活,跟从前地主压着佃农种地,有什么区别?
给自己留一分地
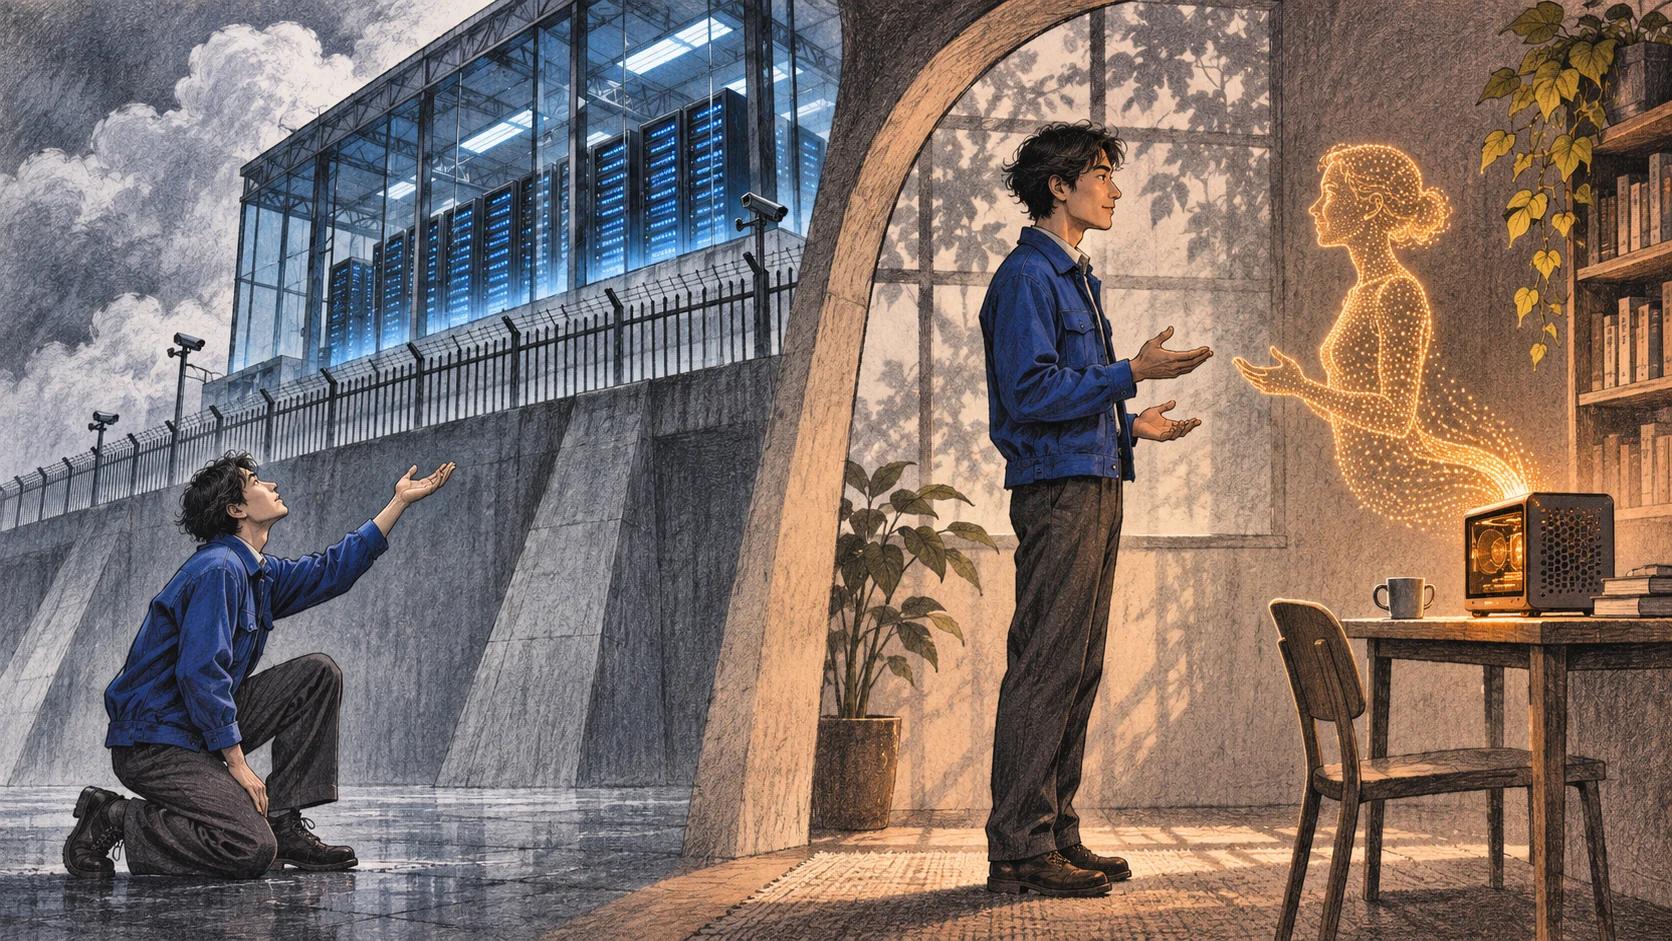
租房得跟人谈续租。买了房,打算住多久,自己说了算。租车得先问有没有车。买了车,想出门就能开。买一台能在本机跑 AI 的电脑也是一样。比租云端 AI 多花一点钱,一分钱一分货。用哪个模型、什么时候用,以后你说了算。
云端的农场再大、再漂亮,跟你有什么关系?你手里这一分地是你自己的。想种什么、什么时候种,都由你。
普通电脑和智能电脑不一样
两台电脑摆在一起,写文档都没问题。等你要跑自己挑的大模型,区别就出来了。一台内存不够,这类活得交给云端。另一台能自己跑模型,你把原始资料给它,活就在你桌上做完。对你来说,这就是两台完全不同的机器。
先拿手头的电脑试。要换新机,可以看统一内存够大的 Apple Silicon Mac,也可以看配 NVIDIA RTX 显卡的 Windows 或 Linux 电脑。选 RTX 机器时,显存、系统内存和 SSD 空间一起看。Mac 这边有两组公开测试可以参考。
- Qwen3.8-27B(270 亿参数,4 位量化)。在一台 64 GB 的 M5 Pro 上,用 oMLX 开启 DFlash 加速,推理时内存峰值约 19–23 GB,每秒生成约 21–33 个 token。要为这个模型买 Mac,可以从 48 GB 统一内存看起。
- Qwen3.8-Flash-Next(主模型 1250 亿参数)。用 Strata 跑 IQ2_XS,估算要用约 42 GiB 内存。已经有 64 GB 的 Mac,可以先试。96 GB 的 M2 Max 实测每秒生成约 25–29 个 token。128 GB 的 M5 Max 能跑 IQ3_S,Strata 的写故事测试是每秒 74.3 个 token,开 MTP 加速后是 94.1 个。
想知道大概要花多少钱,可以看 2026 年 11 月的美国零售价。日常用的 MacBook Air 大致一两千美元。前面跑 Flash-Next IQ3_S 的那档,16 英寸 MacBook Pro(M5 Max、128 GB 内存、2 TB SSD)约 6,400 美元,是六七千美元的配置。桌上的 Mac Studio(M5 Max、128 GB 内存、1 TB SSD)约 5,400 美元。这些都是税前价。
怎么设置
安装可以交给 Codex。请它装上 DeepSeek Harness 官方桌面版,下载模型,再装 oMLX 或 Strata 这样的软件来跑模型。软件把模型在本机跑起来,Harness 通过本机地址连过去。你可以把下面这段直接发给 Codex。
帮我安装 DeepSeek Harness 官方桌面版。从最新的 Qwen Abliterated 社区版本里选一个这台电脑能跑的并下载,安装兼容的模型运行工具,加载模型并启动本机服务。把 DeepSeek Harness 指向配置好的 localhost 地址,选中刚下载的本地模型。给它一个独立的工作目录,把文件访问限在里面,关闭该目录的云同步。
装好以后,打开 DeepSeek Harness,看看界面里选的是不是刚装的本地模型。随便问个简单的问题,能回话就可以用了。要交给它私密文件,先看一眼工作目录的权限,确认云同步关了,再把这次要用的文件放进去。
祝你在自己的电脑上,有一个真正信得过的助手。
1,326 次阅读
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。