
[从零训练一个
我盯着训练面板看了一会儿。5,120张B200大多处于忙碌状态,日志不断滚动,新的检查点也在按时生成。可把已完成的训练量和经过的时间放在一起,重新估算出来的结束日期,却落在原定76天之后。
带着这个疑问,我打开最近一段稳定运行的日志。两次参数更新完成之间,隔着12秒。机器就在这12秒里读材料、计算、交换结果,再把参数往前推一步。要追回工期,我得走进这12秒,找到真正挡住进度的地方。
日志里的12秒
第十六篇定下了每次更新的工作量:1,920条8K序列,窗口装满时一共15,728,640个输入token。把它除以12秒,得到整个集群每秒处理1,310,720个输入token。
15,728,640 ÷ 12 = 1,310,720 token/s
这个速度终于能接上工期:10T材料已经读到了哪里,剩下的部分还需要多久。顺着这个数字往下核对,填充位置有没有被算进去,是否出现跳过的更新,故障后重做的那段材料有没有重复记成新进度。比较速度时,样本、批量和评分位置都要对齐。
12秒只是稳定训练中的一次更新。保存、评估和故障恢复还占用另外的时间,所以结束日期要用整个作业的进度来估算。两笔记录由此分开:更新耗时用来找程序里的瓶颈,实际经过的时间用来追踪工期。
但日志只给了一个总数。它没有告诉我,12秒里究竟哪一段最值得动。于是截取几个连续更新,把其中的工作铺到时间线上。
吞吐:单位时间完成的工作量。这里指整个集群每秒处理的非填充输入token。
墙上时间:现实中实际经过的时间,包括计算、等待与中断。
计算已经结束,后面还拖着一段尾巴
在Nsight Systems里,CPU与GPU的活动可以放在一起看。我用NVTX标出读取材料、前向计算、反向计算、通信和参数更新。采集从编译和缓存准备完成后开始,先看流水线开头、中间、结尾的代表性进程,再对照相应副本。
时间线展开以后,末尾的一段等待很显眼。把主要工作放到同一把尺子上,计算占了8秒,后面跟着4秒传输。计算轨道已经停下,通信轨道还在往右延伸;下一次更新要等它结束。
看到这里,很容易想去加快网络。但通信传的是前面计算出来的结果。如果某个结果迟迟没来,再快的网络也得等。我先顺着这段尾巴往前追,找最后交出结果的环节。
数据入口最容易做对照。把同样形状的材料提前准备在本地,保持模型和批量,再跑一小段。更新仍然接近12秒,入口没有出现明显的空档。第十三篇算过平均读取量,眼前的时间线也没有把等待指向供数。
材料及时到了,接下来就看谁迟迟没有算完。模型分成8个阶段,也就是PP8。把各阶段的持续耗时排在一起,没有一段反复拖后腿。再看同样位置的80个数据并行副本,也找不到一个固定的迟到者。
放大后的时间线露出了更具体的线索:一部分梯度早已经准备好了,却还没有发出去。它们留在原地,等到后面的计算也结束,才集中开始传输。等待并非全部来自“结果尚未算出”,其中有一段,是已经算好的结果在等发送。
性能剖析:记录程序各部分何时运行、耗时多久,用来寻找瓶颈的过程。
NVTX:给程序中的阶段添加名称与时间标记的工具,便于在时间线上找到具体工作。
PP8:把模型按先后顺序分成8个计算阶段,材料依次经过这些阶段。
Rank:分布式训练中一个进程的编号。日志用它区分各个参与计算和通信的进程。
出现数据断供或阶段不均衡时,具体怎样处理?
数据断供先定位最早出现等待的环节。反复读取小文件,可以在保持样本和边界规则的前提下整理文件布局;固定的CPU转换重复执行,可以提前完成;预取队列经常耗尽,就逐步增加准备深度,同时检查内存和缓存占用。如果只有保存检查点期间读取变慢,就检查共享存储的读写竞争。改完后,用同一批材料复测等待时间,并核对内容与顺序。
阶段不均衡先调整合适的层分配,再测整次更新耗时、峰值显存和通信。我保持每次1,920条序列,先处理实现问题。增加微批数可以摊薄流水线启动与收尾,但在其他条件不变时也会增大全局批量,学习率与学习效果要另做对照。
我暂时保留非交错PP8。交错流水线让一台设备负责多个分散阶段,可能减少空闲,也会增加调度与通信复杂度。时间线确认流水线空泡占据主要损耗后,再按Megatron Core 0.19.2的调度实现比较支持的路径。每次选择同时看正确性、显存和吞吐。
把已经算好的结果先送走
反向计算会陆续产生梯度。前面一部分准备好了,后面仍然可以继续算。只要后续计算不依赖这次汇总的结果,两件事就有机会同时推进。
第十五篇已经选择了梯度归约和参数收集重叠。现在要弄清楚的是,这个安排为什么没有充分出现在时间线上。梯度就绪的时刻与实际发起汇总的时刻之间,隔着一段空白。沿着它查下去,才能找到把发送推到后面的依赖或调度。
同时用nccl-tests测相同消息范围的独立通信。网络单独传输时表现正常,问题集中在训练中怎样安排传输。修改范围也随之收窄,集中在已经就绪结果的汇总时机。
调整之后,再展开同一段时间线。计算仍然占8秒,传输仍有4秒工作量,但其中2秒已经移到计算期间。留在最后单独等待的,只剩2秒。下一次更新在第10秒就能开始。
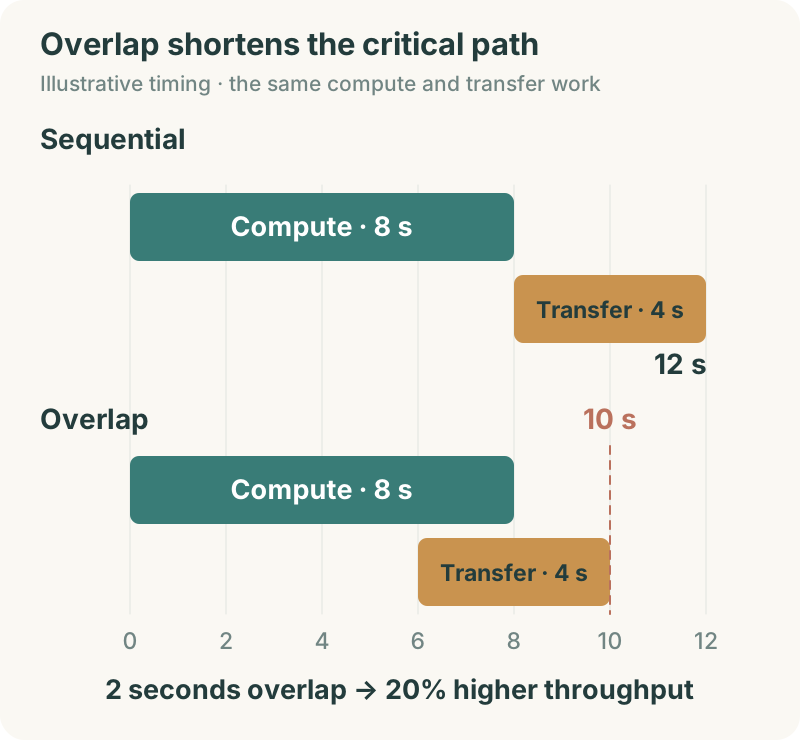
图里两条传输带一样长,改变的是它们开始的位置。4秒传输完整保留,其中2秒与计算共用时间。沿着下一次更新必须等待的那串工作看,整条路径短了两秒。
通信重叠:在进行一部分数据传输时,同时执行能够独立推进的计算。
关键路径:决定整体完成时间的一串相互依赖的工作。缩短它,才可能缩短整次更新。
进一步阅读:2026年通信策略的新尝试
NCCLbpf论文研究把可验证的策略接入NCCL插件,用消息大小等信息调整通信选择。它的公开实验范围是8张B300。我把它作为通信策略可编程化的研究方向,正式500B运行先保留已验证的NCCL组合;新策略使用实际B200拓扑和训练消息做独立对照。
把十秒放回训练过程里
这份十秒的记录还牵着另一件事:我刚改过梯度汇总的时机,必须核对参数更新是否仍然正确。配置和时间线保留下来,再把改动前后使用相同输入的更新记录并排打开。
两份记录从相同参数开始,使用同一批材料、相同批量和损失规则。梯度与参数变化逐项核对之后,还要用相同token预算运行一段,比较损失和独立验证表现。并行顺序改变可能带来数值差异,比较采用事先约定的容差。通信与计算重叠后,临时数据也可能同时占着显存,因此峰值显存和持续运行稳定性一起看。
这些检查通过,10秒才进入新的进度账:
15,728,640 ÷ 10 = 1,572,864 token/s
相同材料的处理速度提高了20%。最初让人担心的结束日期,也终于可以重新算了。
结束日期提前了,仍然晚于原计划
第十六篇按完整更新向下对齐,安排635,782次更新。每次省2秒,整个计算阶段就少了1,271,564秒,约14.72天。
原来12秒一次,纯更新时间约88.30天;现在10秒一次,约73.59天。沿用90%的日历有效比例,把保存、评估和恢复放回排期,两种速度对应约98.11天和81.76天。若计时窗口已经包含这些损耗,就直接换算,保留一套完整口径。
81.76天已经比原来提前很多,但那条76天的计划线仍在前面。前文按每张B200每秒约1PFLOP有效计算规划;眼前这份10秒记录,还没有达到那组速度输入。
把76天倒过来除,需要追到的速度就清楚了:
76 × 86,400 × 90% ÷ 635,782 ≈ 每次更新9.30秒
从10秒到9.30秒,还差大约0.70秒。这给了下一次排查一个具体目标。通信已经与计算重叠了一部分,时间线上仍占着大块位置的,是那8秒计算。观察窗口便移到了这里。
剩下的八秒里,有多少工作做了两遍
第十五篇为了让模型放进显存,采用了重计算:一些中间结果当时不存,需要时再算。这个选择换来了空间,也让同一批token多做了一些前向工作。
显存记录与刚才那段计算轨道放在一起,出现了新的余地。显存还有余量,有些中间结果可以留下来,后面就不用再算一遍。重做的部分逐项列出来,每项占多少空间、花多少时间,排在一起比较,先挑最值得保留的一项。每改一处,就重新跑同一批材料,看完整更新省了多少时间,显存峰值又涨了多少。那还差着的0.70秒,让这次取舍有了明确的方向。
走到这里,开头那个“GPU明明很忙”的现象也更容易理解了。重复计算会让设备持续工作,却没有让模型多读新的材料。我要的进度,是同一项学习任务完成得更快。
性能报告中的MFU把模型有效工作量与硬件理论能力作比较,能帮助我观察这件事。它和token/s、更新耗时一起记录:设备的活动有没有变多,模型推进材料的速度有没有变快,两者终于可以分开看。
重计算:为节省显存而不保留部分中间结果,在后续需要时重新计算它们。
MFU:模型计算利用率,以模型有效计算速率相对于所选硬件理论峰值的比例表示。
怎样计算MFU,怎样决定是否继续优化某个算子?
沿用系列的主要计算粗估,500B稠密模型处理一个token约需6 × 500B次计算。集群每秒处理S个token时,模型有效计算速率近似为6 × 500B × S。再除以5,120张卡在所选精度下的理论峰值,得到同一口径的近似MFU。
分母明确采用BF16、FP8还是其他精度,以及是否使用稀疏峰值;分子说明是否包含Attention等额外计算。长上下文下,简单6N与完整计数会有差异。固定口径以后,MFU可以帮助比较实现;材料进度与学习结果继续单独记录。
如果时间线显示某个矩阵计算长期占据关键路径,再深入检查它的形状、精度与实现。矩阵乘法等一项具体计算称为算子。算子融合把原来分开的几项计算合并实现,减少启动和中间数据读写,但仍要保持模型计算规则。
先看该算子在整次更新里占多少时间,再决定投入。某项计算占10秒里的2秒,若把它缩到1秒,而且这1秒确实位于关键路径上,整次更新才有机会缩到9秒。改变后重新检查完整更新时间、峰值显存和学习表现,而不只记录单个算子的速度。
10秒这份通过检查的配置,与改动前后的时间线一起归档。它把末尾集中传输的一部分工作提前,结束日期从约98.11天推到81.76天。任务记录里留下下一次试验的目标:9.30秒。剩余计算里能拿回多少时间,还要继续跑,但现在我知道该从哪里动手。
再看训练面板,GPU还是很忙。但这一次,那片忙碌里发生了什么,结束日期为什么向前挪了,都有了可以追溯的依据。
等这轮主训练结束,我还要把模型放到另一张考卷前:让它读一段材料,再按我的要求回答。读过很多文字,与做一个好助手之间,还有一段路。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。