
[从零训练一个500B大语言模型] 13/25:数据怎样不断供,训练进度存在哪里?
机房和网线准备好了,5,120张B200可以开始工作了。接下来,我们要让这批机器连续训练约76天。每天都有两件事在发生:新的材料不断读进来,模型的参数不断被更新。
设想训练已经进行到第十天。下一批材料还没有送到,GPU就得等;一台服务器突然坏了,我们还得知道怎样接着第十天的进度往下跑。让机器一直有材料可读,让已经完成的训练可以找回来,就是这一篇要解决的问题。
我们沿着一次训练的过程来安排:先看教材怎样从硬盘进入GPU,再看训练进度怎样存回硬盘。弄清这两件事以后,需要多少空间、读写要多快、最后买什么设备,就都能一步步算出来。
GPU每次只读面前的一小批材料
先接上第九篇。当时我们已经把文字变成token编号,并整理成了可以训练的序列。比如一份中文材料文件,打开以后,主体可以写成[418, 732, 25, …]这样一长串整数。这里展示的是形式,具体编号由分词器决定。
这些文件放在一套共享存储里。它相当于640台训练服务器共用的教材库,保存同一版本的完整教材。每台服务器需要哪一部分,训练程序按既定配方来安排。
真正计算时,GPU只接收当前这一小批序列。程序先从教材库取出接下来要用的文件,放到服务器自己的固态硬盘上;再从中取出一批编号,放进服务器内存,最后送进GPU。GPU处理这一批时,程序提前准备下一批。
为什么不每次都直接去教材库拿?因为材料会打乱顺序、混合使用,也会重复阅读。把近期要用的文件放在服务器身边,可以少跑几趟。我们先给每台服务器安排1TB本地缓存,放它近期需要的材料;这块空间用完后,按接下来的取样计划替换内容。
因此,5T token的完整库存留在共享存储中,各台机器各取所需,GPU每次只处理一小批。它们沿着“共享教材库 → 服务器本地硬盘 → 内存 → GPU”这条路接力。
共享存储:多台服务器都能访问的文件存放系统。本文用它保存统一的训练材料和近期进度。
缓存:把近期会用到的内容放在更近的位置。这里指服务器自己的固态硬盘空间。
预取:在当前一批还没有处理完时,提前准备下一批材料。
5T token的教材,为什么只占20TB?
这里有两个容易混在一起的数字。第七篇安排的是约5T token的独立合格库存目标;训练时,有些材料会读不止一遍,累计读到10T token。
可以把它理解成一套有500万页的教材,最终累计阅读1,000万页。重复阅读某一页,取样程序再找到那一页即可,硬盘里仍然只需要保留一份。
这些token在文件里以编号保存。本计划给每个编号用4字节,于是5T库存的编号主体是:
5万亿个编号 × 每个4字节 = 20万亿字节 = 20TB
为什么这么小?因为硬盘里放的是“词的编号”。编号对应的向量属于模型,训练时由模型查出来。我们没有为每一次出现的token,都在教材文件里存一条完整向量。
20TB算清楚以后,还要给索引和配套文件留地方。索引让程序知道某份文档从哪里开始、有多长,不必为了找一段材料从头翻整个文件。我们为正式训练材料安排30TB可用空间:20TB放编号主体,其余留给索引、文档边界等配套内容。
原始网页、清洗前后的版本还要保存,它们放在另外的归档空间。训练工作区先保留已经选定、即将交给模型使用的版本。
为什么编号按4字节计算?
Megatron的数据集实现会根据词表大小选择整数格式。本计划采用大词表的4字节整数,也就是int32。最终制作数据时,把选定的分词器、编号格式和实际文件大小一起核对。
TB:本文按十进制计算,1TB等于1,000GB。20TB描述文件有多大。
索引:记录文档位置和长度的信息,帮助程序直接找到需要的内容。
跑到第十天,怎样保存已经学到的东西?
教材从硬盘读进来以后,GPU会用它计算,再更新模型参数。第十天的模型和第一天已经不同。要保住这十天的成果,就需要把当前训练状态保存下来。
这份保存文件叫检查点。它很像长任务的一份存档:恢复以后,模型知道参数已经变成什么样,程序知道运行到第几步,也知道教材接下来从哪里继续读。
我们先算最直接的一部分。500B模型有5,000亿个参数,每个参数按2字节保存,模型权重就是:
5,000亿 × 2字节 = 1TB
但接着训练还需要另外一份记录。负责调整参数的优化器,会根据过去的更新情况决定下一步怎样调整。只有当前参数,优化器就接不上原来的调整过程。因此,这份存档还要带上它的工作记录。
本计划使用常见的混合精度Adam方案。在一个完整训练步结束后,保存三部分主要内容:
| 保存什么 | 为什么要存 | 容量 |
|---|---|---|
| 模型当前权重 | 恢复模型此刻的参数,每个2字节 | 1TB |
| 更高精度的主权重 | 更新参数时使用,每个4字节 | 2TB |
| Adam的两组历史状态 | 延续此前的更新方向和幅度,每个参数共8字节 | 4TB |
| 合计 | 每个参数共14字节 | 7TB |
这就是“存一次进度要7TB”的来历。它保存的是整个500B模型的训练状态,与刚才读入的那一小批教材相比,规模大得多。
7TB由整个集群分担。各个训练进程保存自己负责的那部分,合起来才是一份完整检查点。同时保存的还有步数、学习率安排、随机状态和材料读取位置。NVIDIA的检查点文档也把这些信息放在完整恢复流程中。
前面算训练内存时用过8TB,为什么这里是7TB?因为用途和时点不同。训练过程中还要存放梯度,用来完成这一步的参数更新;我们在更新结束后保存检查点,梯度已经完成这一步的任务,恢复下一步时会重新计算。这份存档的主状态就按7TB安排。
检查点:某一时刻的模型和训练状态存档。恢复它,可以接着此前的进度训练。
优化器:根据计算出的梯度调整模型参数的算法。它保存的历史状态,会影响下一次怎样调整。
BF16与FP32:保存数字的两种精度。本文分别按每个数字2字节和4字节计算。
存档保留几份,放在哪里?
先定一个容易执行的起始方案:每小时保存一次,快速共享存储中保留最近三份。假如10:00保存成功,10:40一台机器出了故障,就可以从10:00接着跑,把后面的40分钟重新计算。
保存越频繁,故障后需要重算的工作通常越少,同时写硬盘的工作也越多。我们先采用一小时的间隔,等试跑时测出保存耗时、恢复耗时和故障情况,再调整。
写下一份存档时,已有的三份都要留着。等新的一份写完整、检查通过,再删最旧的一份。所以快速工作区需要同时装下四份:
三份已完成 + 一份正在写 = 4 × 7TB = 28TB
再留出配套文件和写入过程所需的空间,我们为近期检查点安排35TB。
还有一种情况:坏的是共享存储本身。最近三份存档都在里面,就需要另一处能够找回进度的位置。因此,每天再选一份完整检查点,复制到独立的归档系统中。
主训练计划76天,每天一份,每份连同配套文件先按7.5TB安排:
76份 × 7.5TB = 570TB
我们向上留到600TB,也就是0.6PB,专门保存整个训练周期的每日检查点。原始材料和清洗版本的归档空间另外安排。
现在,两类存档各有用途:最近三份放在快速共享存储中,方便尽快重启;每日一份留在独立归档中,用来保留长期进度,也给共享系统故障留一条恢复路径。
归档:保存需要长期保留、但平时较少读取的文件。本文的检查点归档放在独立系统中。
PB:1PB等于1,000TB。这里0.6PB就是600TB。
空间够了,还要等多久?
到这里,我们已经知道要存多少。下一步再问速度:启动时等多久,保存时等多久?这两个场景决定了读写要求。
先看普通训练期间。累计10T token,每个编号4字节,76天里交给模型的有效编号输入合计约40TB。均摊到每一秒,大约只有6.1MB。模型会对每批输入进行大量计算,所以输入文件的平均量可以不大。
可第一次开机时,640台训练服务器的缓存都还没有准备好。我们希望它们尽快拿到接下来需要的材料。为此设置一个集中装载测试:让集群按真实分配方式读取一份20TB编号主体,目标十分钟完成。
20,000GB ÷ 600秒 ≈ 33.3GB/s
因此,选40GB/s作为共享存储的读取验收目标。这里比的是“开机时集中搬一批教材”,前面的6.1MB/s说的是“76天里平均每秒交给模型多少编号”。一个是短时间集中读取,一个是长期平均输入,回答的是两个问题。
实际取样会读索引,也可能把同一份文件送到多台机器。验收时照真实分配方式运行,把重复传输一并计入,记录每台机器何时准备好。
接着看写入。每小时要存约7TB主状态,我们给整份检查点十分钟完成。十分钟里要完成状态整理、传输、文件检查和最终确认,所以先给其中的数据传输留五分钟:
7,000GB ÷ 300秒 ≈ 23.3GB/s
向上取整,采用25GB/s持续写入目标。测试时同时让训练读取教材,观察保存进度会不会让GPU长时间等材料。能在后台保存的部分,与训练尽量重叠;仍要记录训练实际停了多久。
于是,采购要求就变成两件具体的事:集中装载能按时完成,约7TB的存档能在十分钟内完整可用。40GB/s读、25GB/s写,是为完成这两件事设定的验收目标,最后用我们的真实文件和训练程序来测。
GB/s:每秒传输多少GB,描述读写速度。TB回答“能装多少”,GB/s回答“搬得多快”。
异步保存:先形成一致的训练状态,再由后台继续写文件,让部分保存工作与训练重叠。
把三种存储放回机房里
现在可以选设备了。共享工作区首先要容纳30TB教材和35TB近期检查点,共65TB;数据转换、切换版本时还要有操作空间。我们选DDN AI400X3M的120TB可用容量档作为具体采购样例。
DDN的2026年官方介绍列出了120TB、250TB和500TB可用容量方案。这次选择120TB,是因为它能放下当前这张空间计划:
| 用途 | 安排多少 | 为什么 |
|---|---|---|
| 正式教材和配套文件 | 30TB | 20TB编号主体,再留索引等空间 |
| 最近的训练存档 | 35TB | 保留三份,同时写一份 |
| 数据转换和版本切换 | 35TB | 切换时容纳一套30TB材料的临时副本及处理文件 |
| 后续余量 | 20TB | 随实际文件开销与实验需求分配 |
| 合计 | 120TB | 按实际可用容量验收 |
每台训练服务器身边的1TB缓存,以及独立的0.6PB日存档归档,都各有位置。640台服务器的缓存虽然加起来有640TB,却分散在不同机器上,里面还会有重复内容;共享系统仍然按自己的120TB计算。
再看这张图:蓝线把教材从共享存储送到服务器身边,再进入GPU;橙线把训练状态写回共享存储,并按天复制到独立归档。图里的三处存储,分别服务于“统一教材与近期进度”“机器眼前要用的内容”“长期留存的进度”。
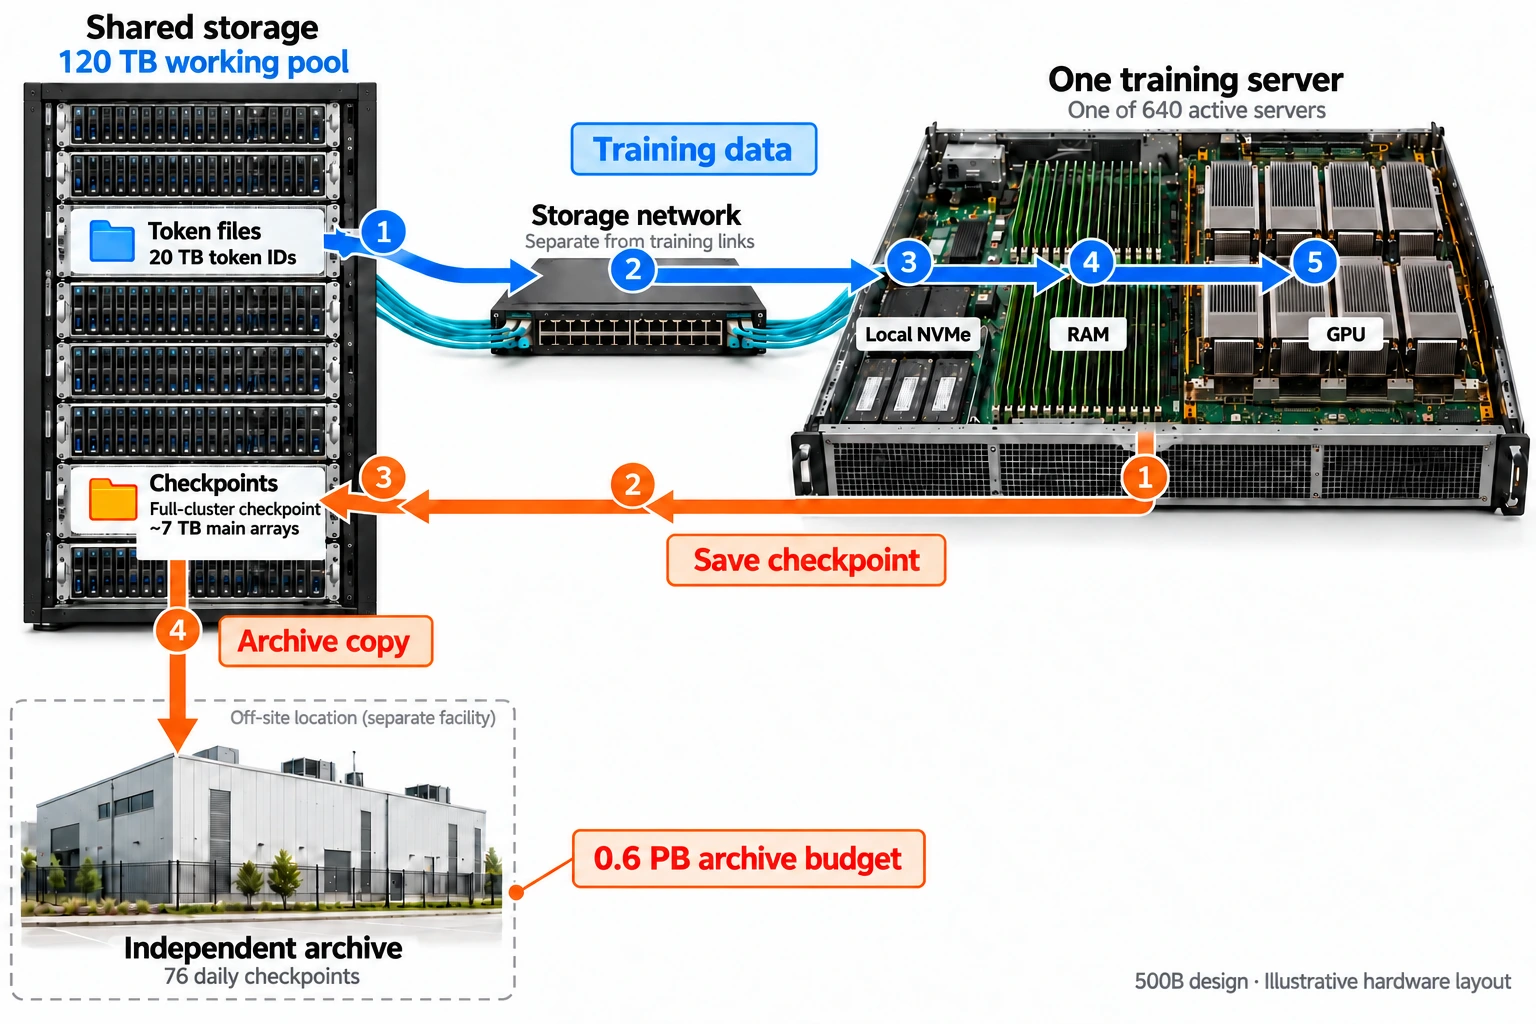
沿蓝线看教材读入,沿橙线看进度保存。设备布局为规划示意;点击图片查看高清原图。
供应商需要交付的是能被640台训练服务器共同访问的完整系统,并用这套120TB配置接受读40GB/s、写25GB/s的并发测试。具体软件、连接和耐久要求,可以展开下面的清单逐项核对。
采购与集成时,把这些项目写进清单
订单包括AI400X3M设备、配套ES400NVX2管理节点、EXAScaler文件系统软件和支持服务。文件系统负责让各台机器按目录读取、保存和管理共同的文件。可用容量按扣除系统与数据保护开销后的120TB验收。
存储单独走一张网络。第十二篇的训练交换机端口已经分配给GPU之间的通信,这里按独立200GbE以太网要求供应商配置额外网卡与交换机,并核对服务器剩余插槽和PCIe连接。200Gb/s换成字节,单条链路标称约25GB/s,实际文件速度还会降低;存储侧需要多条连接承接集群并发,再验证整体读写目标。
服务器的1TB缓存先从整机配置中的本地固态存储划出工作配额,实际可用空间、系统盘占用和盘的数量在集成清单中确认。本地机器更换后,缓存可以从共享存储重新填入。
固态盘还要检查耐久度。每小时写7TB主状态,一天约168TB逻辑写入;容量只保留最近几份,已经发生的写入仍然计入盘的使用量。供应商按真实检查点大小、写入频率和服务期限核对盘的耐久与更换方案。
DDN的平台峰值可用于筛选候选设备。最终验收使用这套120TB具体配置,同时读教材、写真实检查点,记录持续速度、训练等待时间和完整保存时间。
可用容量:扣除系统与数据保护开销后,真正能分配给文件的空间。
最后,真的停下来,再接着训练一次
有了设备,还要做一次完整演练。先让一段训练正常运行,保存一份检查点,然后主动停止,用备用服务器替换一个位置,再从刚才的存档继续。
首先确认所有分片都写完、文件检查通过,把这份检查点标为可恢复。恢复时,逐项看参数、优化器状态、步数和材料读取位置是否接上。接着再跑一小段,与未中断的对照运行比较,按训练实现允许的数值差异核验结果。
共享存储和独立归档都各做一次这样的恢复。这样才知道,“存好了”确实意味着以后能用,而不只是目录里出现了几个文件。
| 要验证的事情 | 本计划的目标 |
|---|---|
| 教材有地方放 | 共享系统120TB可用,按上表划分空间 |
| 开始时拿教材够快 | 按真实分配装载20TB编号主体,目标十分钟,重复传输计入测试 |
| 训练时可以边读边存 | 并发验收读40GB/s、写25GB/s,并记录GPU等待时间 |
| 一份进度能及时保存 | 约7TB主状态及配套文件,目标十分钟内完整可恢复 |
| 出故障以后能继续 | 从共享存储和独立归档各恢复一次,核对训练状态与后续结果 |
这套起始方案最终是:120TB共享工作区,每台训练服务器1TB缓存,另留0.6PB保存76天的每日检查点。GPU不断读入一小批一小批教材,系统每小时保存进度。我们既知道下一批材料从哪里来,也知道机器停下来以后,怎样把训练接回去。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。