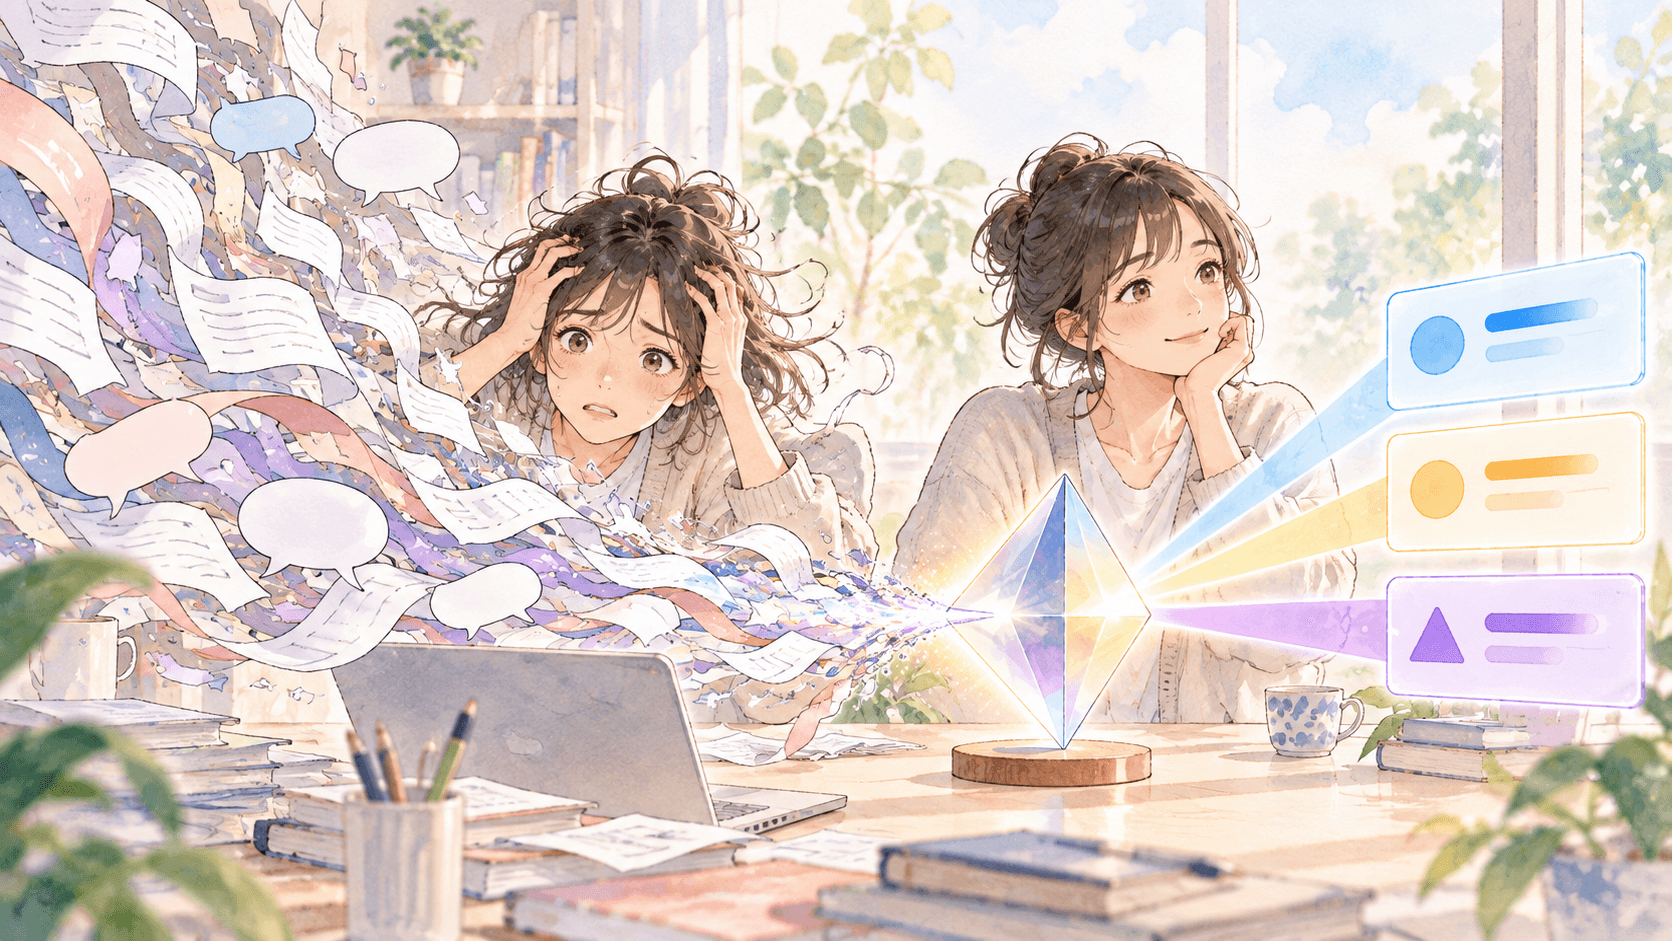
Jev:不生成文本,几百毫秒返回概率决策
问一个人不懂的问题,他可以说:“我不知道。”问大模型一个不懂的问题,它通常会先说:“这是一个很有意思的问题。”接下来就很难收场了。大模型有点像在会议上突然被老板点名的人,脑子里明明只有三分把握,嘴上已经开始第一点、第二点、第三点;说到第三点时,第一点是真是假已经不重要了,重要的是会议室里不能突然安静。
这不是因为模型故意撒谎。它的工作本来就是继续写下去:看到前面的文字,猜下一个词;有了下一个词,再猜后面一个。只要没有生成“结束”,它就必须继续。一个不太确定的猜测一旦写进上文,后面的内容就会努力配合它。一个不存在的公司,很快可以拥有创始人、融资历史和企业文化,除了没有公司,其他都很完整。
今天的大模型已经非常强,但它最常用的输出仍然是一段文字。人可以阅读、怀疑和追问这段文字,软件却更难处理。软件真正想知道的通常不是“请展开谈谈”,而是“这是 A、B 还是 C?你有多大把握?把握不够时,我要不要交给人?”
TypeSafe AI 发布的 Jev 就是从这个问题出发。它不和人聊天,也不写长答案;你给它一份信息和几个明确问题,它直接返回选择、分数和概率。它不试图成为一个什么都会说的模型,而是专门负责在软件里做判断。这听起来像是少做了一件事,但很多时候,少做恰恰是产品终于能用的开始。
Top-K 和 Top-P 管的是怎么说,不是该不该说
要理解 Jev,先不需要学习复杂数学,可以把大模型想成一个“下一个词竞猜器”。比如看到“法国的首都是”,模型会给接下来可能出现的词排队:“巴黎”的概率最高,其他答案低很多。问题简单时,队伍秩序井然;问题冷门或信息不足时,前几个候选可能都差不多。可无论它有多犹豫,系统还是要求它选一个,而 Top-K、Top-P 和 Temperature,都是在这一步控制模型怎样选。
Top-K 的意思是,只留下概率最高的 K 个候选。例如 K 等于 10,就让前十名参加决赛,其他词提前下班。Top-P 则不固定人数,而是从概率最高的候选开始往下加,直到累计概率达到 90% 之类的阈值。Temperature 决定比赛有多刺激:温度低,热门选手几乎稳赢;温度高,冷门选手也有机会上台领奖。
这些设置能够控制输出是稳定还是有创意,却不能判断答案是不是真的。把 Top-K 从 50 调成 5,只是缩小了模型可以选择的词,不会让缺失的事实突然出现。把 Temperature 调成 0,也只是每次选择最可能的下一个词,不代表整句话一定正确。
原因很简单:模型计算的是“这个词接在前面是否自然”,不是“整件事是否真实”。如果模型已经编出了一个像真的公司名,那么后面接“有限公司”的概率可能非常高。语言上完全合理,工商局里查无此人。
所以幻觉不只是参数没调好。更根本的问题是,模型内部明明有概率,软件拿到的却只是一段写完的文字;概率被用来帮助模型继续说,而不是帮助程序决定是否应该行动。既然自由发挥容易出问题,工程师很自然地想到了一个办法:让模型不要写散文,改填表格,于是有了 JSON Mode、Structured Output 和各种 Schema。大模型终于穿上了西装,看起来很适合进入生产环境,只是穿西装的猜测,仍然是猜测。
JSON 让答案整齐,Jev 让答案可以执行
Structured Output 非常有用。如果程序需要的是:
{ "department": "billing" }
那当然比模型先写三段分析,最后含蓄地表示“也许应该找财务”安全得多。Schema 还可以保证字段存在、类型正确,并阻止模型突然发明一个公司根本没有的部门。
但普通 LLM 底层仍在逐词生成。JSON 解决的是格式,未必解决判断本身。程序知道结果是 billing,却不一定知道模型是在 95% 确定的情况下选择它,还是在 billing 和 technical 之间掷了一枚比较有文化的硬币。
实际系统于是经常要走完一条很长的路:先写 Prompt,让模型生成 JSON,再检查字段、转换类型、解释置信度,最后才进入业务逻辑。一个本来只想知道“A 还是 B”的程序,经过现代 AI 工程以后,获得了一条小型供应链。Jev 把接口直接放在这条供应链的终点:它接收状态和问题,返回程序真正需要的值。
它有三种基本问题。Choice 是选择题:从预先规定的答案中选一个,并返回每个选项的概率。Score 是打分题:按照一组有顺序的等级评分,同时给出各等级的概率分布。Noul 是判断题:直接返回 0 到 1,表示一句话成立的概率。
假设客户写道:“Stripe 已经连续三天连不上,我们每天都在损失订单,请马上帮忙。”普通 LLM 可能生成一段分析;Jev 可以直接告诉程序:这个问题属于 technical 的概率是 0.81,具有紧急性的概率是 0.99,客户高度不满的概率是 0.65。程序接下来不需要揣摩模型的语气,可以把工单交给技术支持并提高优先级;如果几个部门的概率非常接近,就转给人工。模型负责理解那段充满情绪的自然语言,代码负责阈值、权限和执行,各自做擅长的事情,谁也不用跨界兼职。
Jev 真正有价值的地方,是把“不确定”交给程序
对于人来说,“大概”“好像”“我个人倾向于”已经能传达不确定;对于程序来说,这些词的主要作用是让正则表达式失眠,程序真正需要的是数字。如果欺诈概率是 0.97,可以暂时冻结交易;如果是 0.68,可以要求补充验证;如果是 0.42,可以先不采取行动。模型不必永远正确,但系统必须能够在模型不确定时换一种处理方式。
这就是概率比一段完整回答更有价值的地方。它可以用来排序候选、设置自动执行的阈值、决定何时转人工,也可以在事后和真实结果比较。模型犯错不再只是一次“它怎么又胡说了”的事故,而会变成能够记录、分析和改进的数据。
想看更多实战拆解?
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。
TypeSafe 把 Jev 的训练方法称为 Reinforcement Learning for Calibrated Decisions,也就是 RLCD。这里最重要的词是 calibrated,校准。简单说,如果模型长期把一批判断标成 80% 概率,那么其中应该有大约 80% 最终是对的。它不是保证某一次一定正确,而是让概率在大量使用中具有实际意义。这里也要避免一个容易发生的误会:TypeSafe 的 RLCD 不是 2023 年那篇 Reinforcement Learning from Contrast Distillation 论文,二者只是缩写相同。
至于 Jev 究竟怎样训练,公开答案目前很有限。TypeSafe 只披露了三个层次:一套新的模型架构、一个让多个输出并行产生的 sampler,以及以校准决策为目标的 RLCD;网络结构、训练数据、奖励函数、loss、模型规模和可复现代码都没有公开。因此,任何更具体的描述——例如它是否由某个 LLM 蒸馏而来、是否使用某种分类头——目前都只能算推测,不能写成事实。
对于 Choice 和 Score,Jev 会返回完整的概率分布,还会提供一个根据分布集中程度计算出的 confidence。Noul 则直接返回命题成立的概率。应用仍然需要用自己的历史数据检查这些阈值是否适合自己的业务。卖鞋的网站和拦截银行转账的网站,不应该因为都看见了 0.8,就采取同样的动作。
TypeSafe 还说 Jev 不会产生幻觉,这个说法需要准确理解。如果预先规定的部门只有 billing、technical、sales 和 other,Jev 不会突然创造一个“量子客户关怀部”;需要数字时,它也不会返回一首诗。它仍然可能选择错误的已有答案,但错误被限制在程序事先定义的范围里。这不是“模型永不犯错”,而是把错误关进一个可以管理的笼子;对于生产系统,这已经是很大的进步。
Jev 实际怎么用
真正接入时,逻辑并不复杂:先把客户消息、账户状态或文档内容放进 state,再列出程序需要的几个判断。下面不是某一种语言的精确语法,而是整个接口最核心的样子:
结果 = Jev判断(
  状态 = 客户消息,
  问题 = {
    负责部门: 从 billing / technical / sales / other 中选择,
    是否紧急: 返回 0 到 1 的概率,
    不满程度: 从 calm 到 angry 评分
  }
)

如果“负责部门”的信心不足 60%:转人工
如果“非常紧急”且属于 technical:通知值班工程师
否则:按照部门和不满程度正常路由
真实的 Python SDK 只是把这段伪代码换成 Choice、Noul 和 Score 对象。重要的不是函数叫什么,而是输入一次业务状态,同时拿回多个可以直接参与程序控制的判断,不需要先生成一篇解释,再从解释中猜出模型到底想选什么。
设计问题时,最好每次只问一件事。“我们应该怎样处理这个客户?”太大,也太像让模型替整个公司值班。可以分别问:客户是否要求退款、哪个部门负责、影响是否严重、证据是否充分,再让代码组合这些结果。
这种设计也解释了 Jev 的速度和成本优势。普通 LLM 处理完输入以后,还要逐词把答案写出来;Jev 的答案范围已经提前确定,多个问题还可以并行计算。TypeSafe 公布的端到端延迟大约是 70 到 500 毫秒,输入价格为每百万 token 0.042 美元,输出不单独计费。不同业务中的实际数字会变化,但方向很清楚:如果程序只需要一个判断,就没有必要先花钱让模型写一篇文章,再花代码把文章变回判断。
用一个 Prompt,能不能把 LLM 变成 Jev?
短答案是:可以模仿 Jev 的接口,不能把它变成 Jev。TypeSafe 自己开源的 System One Adapter 已经证明,普通 LLM 配合 Prompt、JSON Schema 和 Structured Output,也能返回 Choice、Score、Noul 以及每个选项的概率。从产品接口看,两边可以长得几乎一样;从计算过程看,它们仍然是两种东西。让一个散文家只填写选择题答题卡,并不会让他的脑子突然变成阅卷机。
第一个差别是概率的含义。直接问 LLM“你有多大把握”,它给出的 0.9 仍然是生成出来的一串字符,模型可能在正确和错误时都很自信。更好的做法是限制答案集合,从候选标签的 logits 得到分布,再用留出的真实数据做 temperature scaling 或 isotonic calibration;但许多 API 不提供稳定可比的标签 logits,多 token 标签还会带来额外偏差。JSON 能保证 0.9 是一个数字,不能保证这个数字真的值 0.9。
第二个差别是计算路径。LLM 读完输入以后,仍要依次生成左括号、字段名、选项、概率和右括号;问题越多,JSON 越长,等待时间越长。Jev 声称会共享同一份 state,并行计算所有独立问题。官方文档中的一个例子把 13 个问题放在一次请求里,相比 13 次单独调用快 9.6 倍;这不是因为问题变简单了,而是因为并行 fan-out 避免了重复读取状态和串行等待。
速度到底能差多少,要看比较对象。TypeSafe 的 workflow eval 把四种业务流程取平均:Jev 的准确率为 67.8%,耗时 0.4 秒;几乎同样准确的 Terra workflow 是 67.9% 和 10.1 秒,约慢 25 倍;Sonnet 5 workflow 同样是 67.8%,耗时 78.1 秒,约慢 195 倍。这解释了官方“最高 193.6 倍”的来源,也说明它不是一个适用于所有请求的常数。官方自己承认这是收益较高的一组工作流,参考答案来自大模型共识,评测也由 TypeSafe 设计,因此应该把它看成有数据支持的公司 benchmark,而不是独立实验。
如果任务只是一个固定的二分类,一个很小的本地分类器完全可能比远程 Jev 更快;如果只问一个简单问题,并让高速非推理 LLM 输出一个标签,差距也会明显缩小。Jev 最有优势的不是“世界上最快的分类器”,而是在选项和问题由程序运行时定义、需要接近前沿模型的语义理解、同时又要在一次调用中完成十几个判断时,仍能把延迟压在几百毫秒。这是一种 intelligence per second,而不是单纯的 tokens per second。
能不能自己训练一个类似模型?如果问题和标签长期固定,完全可以:收集业务状态、问题和真实结果,用强模型加人工复核生成第一批标签,再训练一个小型 encoder、cross-encoder 或带分类头的小模型。Noul 可以训练成二分类概率,Choice 使用候选项上的 softmax,Score 使用有序分类;训练时关注 cross-entropy 或 Brier score,训练后再用独立验证集做校准,并测量 accuracy、Brier score、ECE 和 P95 latency。很多公司并不需要复刻 Jev,只需要把自己每天重复一百万次的那一道选择题训练好。
真正困难的是让新问题和新选项在运行时出现。如果今天的选项是客服部门,明天是网页按钮,后天又变成 200 个工具,普通固定分类器就失效了。要接近 Jev,需要一个由自然语言指令控制的通用打分模型:共享编码一次 state,再同时理解每个问题和候选项,为它们产生可校准的 logits。怎样在保持这种开放性的同时做到高准确率、低延迟和稳定校准,正是 Jev 尚未公开、也最可能构成技术壁垒的部分。一个 Prompt 能复制外观,复制不了这条训练与推理管线。
它不会取代 LLM,但会出现在 LLM 旁边
Jev 最直接的用途是客服路由、文档分类、退款意图识别、销售线索评分、安全告警分级和搜索结果排序。这些任务表面上都在处理语言,最后需要的却通常只是一个选项、一个分数或一个概率。
另一个很有价值的方向是监督 Agent。一次 Agent 运行可能包含计划、工具调用、检索证据和最终动作。Jev 可以分别判断:证据是否支持结论、Agent 是否遵守用户要求、准备执行的动作是否可逆、回复里是否包含敏感信息、是否需要人工审核。这样系统拿到的是一组可以执行的信号,而不是让第二个 LLM 写一篇《论第一个 LLM 为什么表现不佳》。
文档工作流也很适合这种分工。发票不需要文学性,系统只需要知道供应商是否匹配采购单、金额是否异常、收货证据是否完整,以及差异是否超过审核阈值。Jev 负责理解,代码负责算钱。这个分工通常比让模型同时担任会计、审批人和散文家更稳妥。
发布后的两天里,X 上已经出现了几个很能说明问题的实验。Browser Use 的开发者 Gregor Zunic 做了一个开源浏览器 Agent:每走一步,程序把当前 DOM 当作状态,把页面上能点击的元素当作选项,Jev 直接决定下一步点什么;只有需要输入文字时,才交给一个小型 LLM。演示中,它在 Google Flights 上搜索苏黎世到伦敦的机票大约用了 7 秒,报告成本为 0.0039 美元。在网页上点按钮,本质上不是写诗,而是连续做选择题,这几乎就是 Jev 最自然的使用场景。
另一个实验来自开发者 Paolo Rosson。他把一份 PR diff 作为共同状态,在一次调用里同时检查 14 个问题,例如是否存在硬编码密钥或 SQL 风险,每个检查都返回概率;他报告的响应时间约为半秒,单个 PR 成本约 0.00007 美元。这里最有意思的不是“AI 又会 Review 代码了”,而是一次输入可以并行产生一组相互独立、带类型、带概率的判断。代码审查不一定需要模型先写一篇检讨书,很多时候,十四盏风险指示灯更有用。
产品层面的进展也很快。9 月 16 日,Vercel 正式宣布 Jev 已接入 AI Gateway,AI SDK 7 的实验性 evaluate 接口可以直接调用 typesafe-ai/jev,并把多个判断和概率带回应用。这意味着 Jev 已经不只是发布文章里的概念,开发者可以把它放进现有的模型网关、日志、预算和数据保留设置里。上面的速度和成本仍是开发者自报的早期演示,不是独立 benchmark;但这些 demo 已经说明了一件更重要的事:一旦接口从“生成文本”变成“返回判断”,软件架构会立刻开始变化。
未来的 AI 系统不会只用一种模型。推理模型负责调查、规划、解释和生成;Jev 这类决策模型负责分类、评分、验证和路由;普通代码负责计算、约束和执行;人负责那些模棱两可、后果又很严重的案例。
Jev 仍处于 Early Access。公开信息还不足以完整判断 RLCD 的训练细节,它在不同业务中的概率校准也需要真实数据验证。把这些问题说清楚,并不影响它的核心价值。Jev 提出的方向非常实际:不要总让模型先写一段话,再从话里寻找决定;直接返回可能的决定、每个决定的概率,以及系统什么时候应该停下来找人。
LLM 的价值仍然是开放式推理和生成。Jev 的价值则是提醒我们:不是每一次调用人工智能,都必须得到一篇小作文。有时候,软件需要的全部答案就是:A 的概率是多少,B 的概率是多少,以及这一次最好别让 AI 自己做主。
参考资料
- TypeSafe AI, Introducing System One Models & Jev, 2026年9月15日。
- TypeSafe AI Documentation, Introduction 与 AI Primer。
- TypeSafe AI Documentation, Primitives、Confidence 与 Quick Start。
- TypeSafe AI, Workflow Evals。
- Vercel, TypeSafe AI's Jev now available on AI Gateway, 2026年9月16日。
- Gregor Zunic, Browser Use + Jev 开源浏览器 Agent 演示, 2026年9月17日。
- Paolo Rosson, 使用 Jev 并行检查 Pull Request 的演示, 2026年9月17日。
- TypeSafe AI, System One Adapter 与 Workflow Evals。
- TypeSafe AI Documentation, Ask multiple questions together 与 Confidence。
- Yang et al., RLCD: Reinforcement Learning from Contrast Distillation, 2023。该论文与 TypeSafe 同名缩写的训练方法不是一回事。
本文中的判断与观点属于作者。写作本文的 2026年9月17日,Jev 仍处于 Early Access;未来的开放范围、API 行为、限制、延迟和价格都可能变化。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。