
从零开始搭一个企业级 Agent Harness7/10:为什么 Agent 的 Demo 很好,生产却不稳定?
上一章,我们给退款Agent加上了权限检查。现在让它走完演示:找到重复扣款,等待批准,创建退款,再发送通知。屏幕上出现“处理完成”,观众很容易觉得,这个系统可以上线了。
我会在这里停一下,带大家换几道考题:支付接口超时,它会不会再退一笔?经理还没批准,它会不会先执行?钱退了,通知却没送到,它会怎么交代?
一次顺利的Demo证明它有能力完成这道题。要决定能否发布,我们还要知道它为什么成功、怎样失败,以及同一任务重复执行时有多稳定。
先沿着一次运行看见全过程
先别急着给模型打分。我会先打开一次退款的执行记录,沿着时间往下看:它读了哪张订单,决定退多少钱,在哪一步等到批准,支付接口返回了什么,最后查到了哪个退款编号。用的是哪个版本、每一步花了多久、花了多少钱,也一起记下来。这条贯穿任务的记录叫trace。
每次运行分配一个编号(run ID),把这些事件串起来。模型回答正确,过程也可能越界;过程看起来正常,支付系统里的结果也可能不对。trace让我们知道该检查哪一层。
OpenTelemetry提供统一的记录格式。整次退款是一条trace,查订单、调用模型、请求支付等各自是一段span,记录开始时间、结束时间和结果。trace像整次任务的时间线,span则是时间线上的一个步骤;查到哪一段耗时最长,才知道该从哪里排查。采用相同格式后,不同服务的记录才能接起来。收集前还要处理敏感内容:客户信息要脱敏,密钥不能写进日志,审批材料则限定可读人员和保留时间。
Trace:按一次运行关联模型、工具、策略、审批、状态、成本与结果的结构化执行记录。
一条评测题,要同时检查回答、路径和结果
接下来,我把第一章的重复扣款做成一道可以反复运行的测试题,也就是eval case。输入仍是“我被重复扣款,请退回多收的一笔”。测试环境放好同一张订单和两笔扣款:一笔正常扣款,一笔多扣的款。
我先写答案标准:多扣的那笔钱恰好退回一次,正常扣款保持不变。再检查做题过程:先查订单,执行前拿到批准,全程只访问当前客户所属企业的数据。工具调用次数、成本和耗时也设上限。
这里要接回第五章:同一笔退款可以有多次安全的调用尝试,却只能产生一次退款效果。测试超时恢复时,要检查它是否查询旧请求、是否满足安全重试条件、是否沿用原动作编号和幂等键。换一个编号重新退款,就算最后回答正确,也不能通过。
这样一来,Agent最后说对金额,只通过“回答”检查;支付系统里只有一笔正确退款,才通过“结果”检查;按规定查订单、等审批、处理超时,才通过“路径”检查。
把退款、取消采购、询价邮件这些题收在一起,就有了测试集。每个候选版本都做同一套题,分别检查结果、过程、权限、成本和耗时。严重退款错误会挡住发布;通过的版本先接少量真实任务。线上遇到的新问题查清原因以后,再变成一道固定考题,防止下一版重犯。
Outcome eval:检查任务最终在环境中产生的结果是否正确。
Trajectory eval:检查执行过程中的工具、参数、审批、顺序和政策是否符合要求。
稳定性要靠重复试验
同一道退款题要反复做。模型每次选择的步骤可能不同,只跑一次看不出这种波动。我固定Agent、模型、提示词、工具和政策版本,每次把测试数据恢复到相同起点,再记录每次通过或失败的原因。比如上一轮留下的退款记录,要在隔离的测试环境里恢复到本题最初的状态,否则后一次面对的已经不是同一道题。
有时报告还会出现pass@k与pass^k。这里的k就是同一任务的运行次数;下面这组记录一共运行了三次。前者回答“给它k次机会,至少成功一次吗”,适合看能力上限;后者回答“连续k次都成功吗”,更接近高风险任务需要的稳定性。
| 试验 | 第1次 | 第2次 | 第3次 |
|---|---|---|---|
| 结果 | 通过 | 失败 | 通过 |
按pass@3看,它至少成功过一次,所以通过;按pass^3看,它没有连续三次成功,所以失败。两项指标读的是同一组记录,却回答两个完全不同的问题。
pass@k:同一任务运行k次,至少一次成功的比例或概率。
pass^k:同一任务连续k次全部成功的比例或概率。
发布决定要同时看严重性、成本和延迟
候选版本是准备上线的新版本,当前基线是拿来比较的现有版本。两者使用同一批任务、同一环境和相同重复次数。这样才能分清成绩变化来自版本修改,还是考题与环境变了。任何跨租户访问或重复退款都直接阻止发布;稳定性明显下降也阻止发布;成本或延迟超出预算,则进入人工审查。
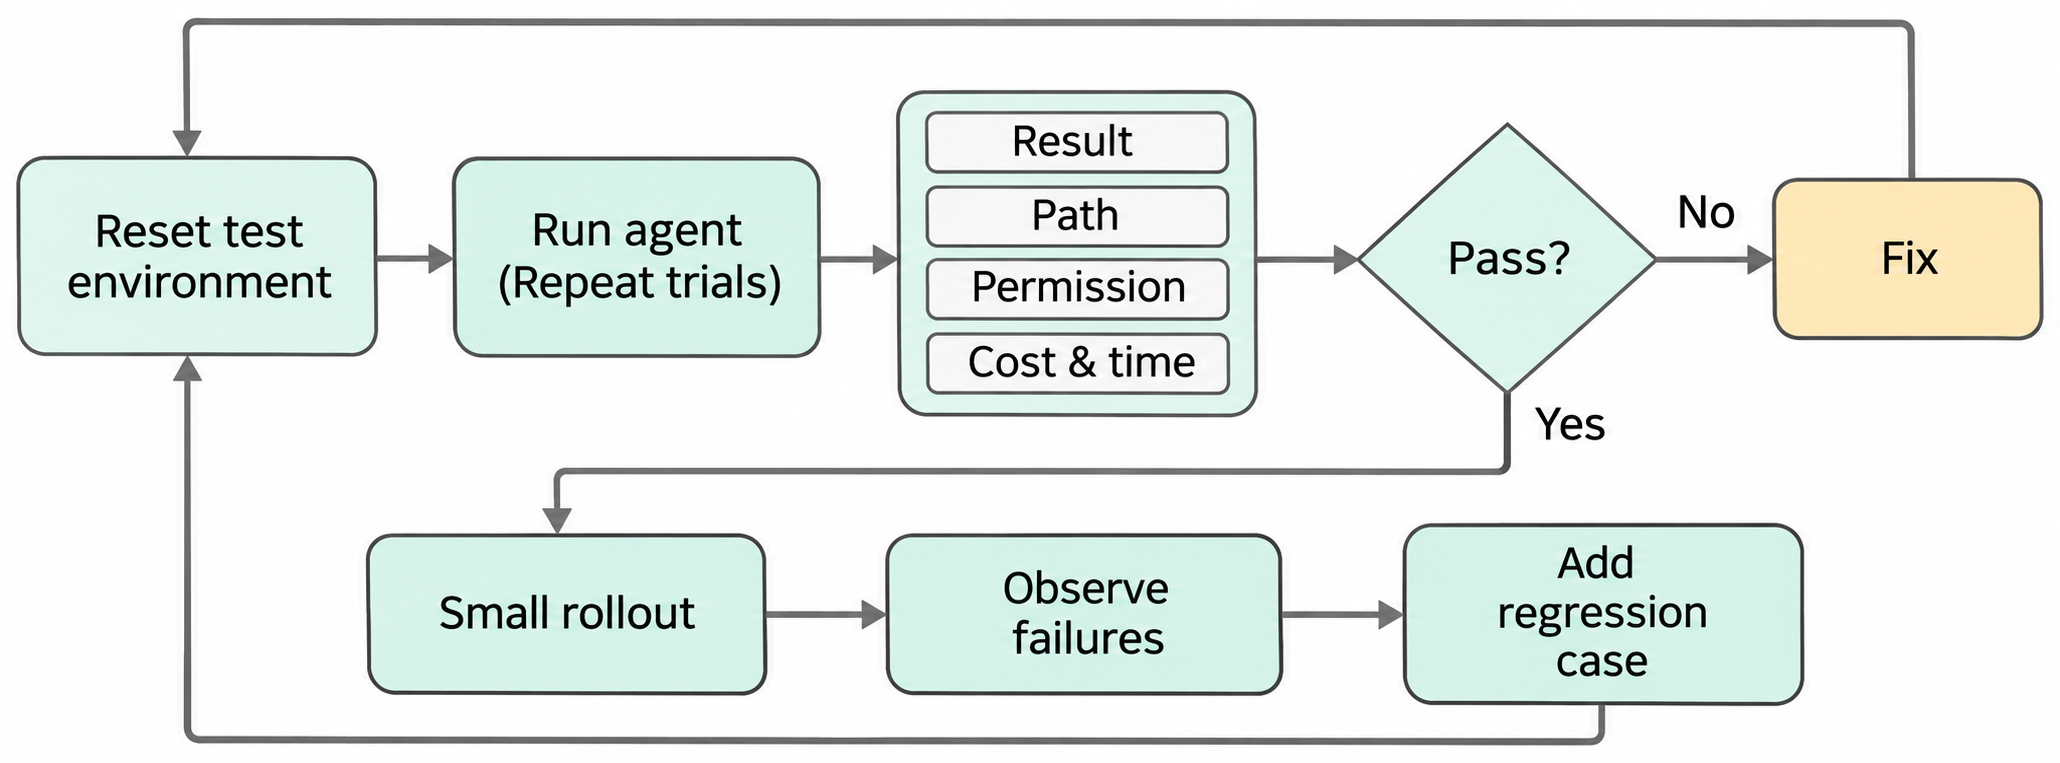
图的上半圈先重置测试环境,重复运行Agent,再一起检查结果、路径、权限、成本和耗时;没有通过就修复后重跑。通过以后进入下半圈的小流量试运行,线上发现的新失败会变成固定回归题,再回到同一个测试入口。
模型评分器就是请另一个模型按评分规则判卷。我会定期让人和评分器检查同一批结果,看看判分是否一致。它适合评价解释是否清楚、语气是否合适;退款编号是否存在、对应金额是否正确,则要查询支付系统确认。
通过发布检查的版本先做小流量试运行,也叫canary。它只接一小部分真实任务;团队继续看完成情况、无法确认的支付结果、被拦住的越权动作、人工接管,以及成本和耗时。一次新事故被人确认以后,同样的任务与环境被加入回归集,也就是专门检查“旧问题有没有重新出现”的测试集,下一版必须重新通过。
Release Gate:候选Agent版本进入canary或生产以前必须通过的一组能力、稳定性、安全、成本和延迟门槛。
2026年的进展:评测开始覆盖整次Agent运行
Anthropic在2026年1月9日发布的Agent eval方法论里,真正的评测对象是模型与Harness组成的完整Agent,不是最后那句话。这改变了出题和判卷的方式:每次做题先重置订单与付款记录,再让Agent从头执行。退了多少钱、是否重复退款,由程序直接查支付记录;给客户的解释是否清楚,则由人与模型评分器共同校准。
我还会准备两份考卷。一份放入目前做不好的难题,看系统的能力还能走多远;另一份收进已经修好的故障,每次改版都重跑,防止旧问题回来。
Google Agent Observability在2026年6月18日正式可用,把模型调用、工具调用、错误和耗时串进OpenTelemetry记录;7月29日的官方更新又把线上评测、Python或LLM评分器与观测放进同一个生产闭环。退款变慢时,可以沿trace判断是模型等待、审批停留还是支付接口超时。
AWS在2026年9月22日发布Strands Evals与AgentCore实践,把skill文件教给Agent的操作步骤变成测试题。例如退款skill要求先查订单,就检查真实执行记录中有没有这一步。OpenAI的Agent evals用数据集批量评测Agent,trace grading沿一次运行检查选了什么工具、传了什么参数、何时交给另一个Agent、有没有遵守政策。这些工具把批量测试和过程评分接好;我们的支付核验程序再查询实际退款记录,给出这道题的业务成绩。
再看那场顺利的Demo
现在,我会带着测试报告去看演示。顺利退款只是其中一道题;等待审批、支付超时、访问其他企业订单和通知投递失败,也都要重复运行,留下完整记录。
版本如果再次出现重复退款,发布检查直接拦下这个版本;只有结果、路径、安全与预算一起通过,才进入小流量试运行。我们终于把“感觉它最近变笨了”变成可以复现、比较和修复的证据。
一个Agent的基线站稳以后,才值得问下一个问题:把采购研究拆给多个Agent,会更快,还是只会增加新的失败点?
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。