
从零开始搭一个企业级 Agent Harness5/10:为什么 Agent 出错以后不能简单重试?
采购Agent刚把一封已经由经理批准的询价邮件交给发送服务。十秒过去,工具只返回四个字:“请求超时。”没有邮件编号,也没有失败原因。
Agent把它当成失败,又发送了一次。供应商打开收件箱,里面躺着两封一模一样的邮件。
问题出在那十秒里。Agent没有收到回复,只能说明回复没有回来;它没有告诉我们第一封邮件究竟走到了哪里。恢复系统的第一步,因此不是再试一次,而是找回这次动作在真实世界里的下落。
超时以后,先去找第一封邮件
我先给这封邮件一个固定的请求编号,再带上幂等键。这两个值用途不同:请求编号用来追踪和查询“刚才那次发送去了哪里”;幂等键告诉发送服务“这仍是同一个业务动作,不要再创建一封”。两个值都在请求发出前存好。服务返回操作编号或邮件编号以后,再补到账本里。这样,即使成功回复丢了,我们也能查询原请求,服务也能认出重复调用。
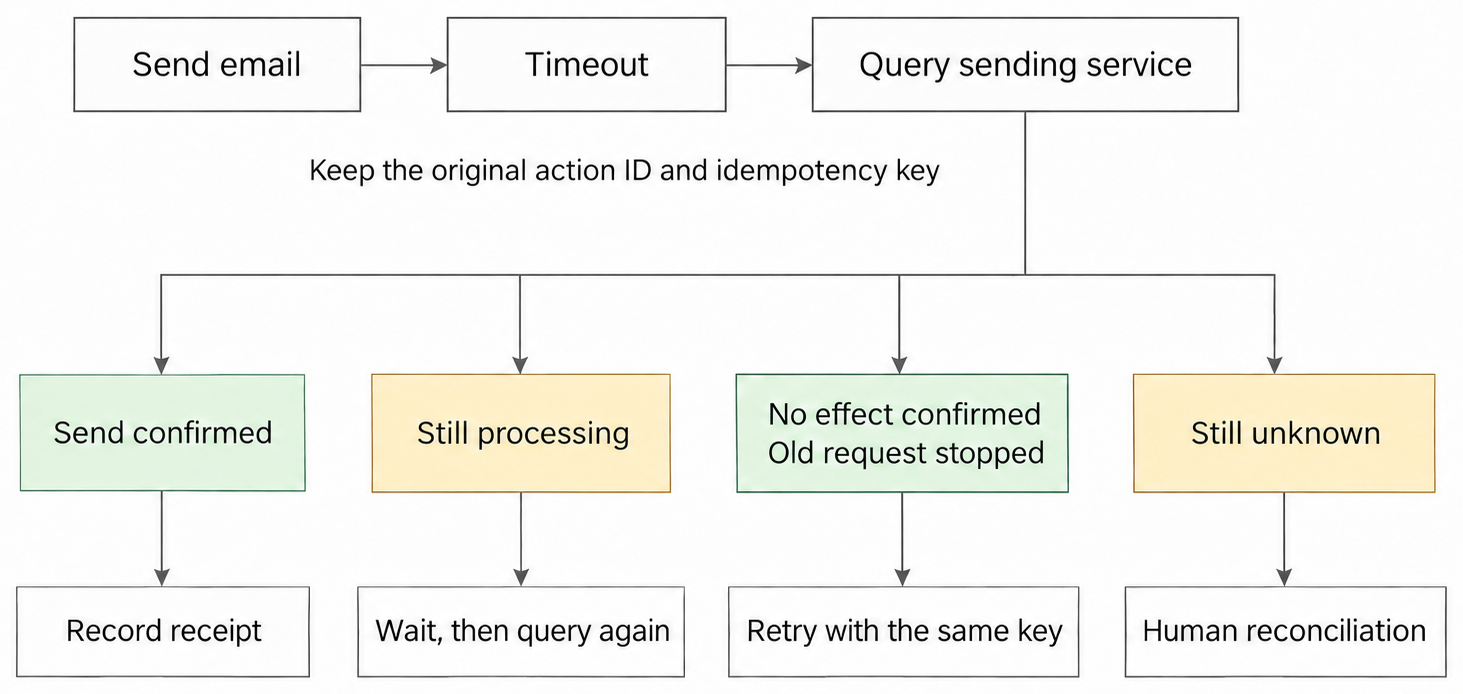
沿图从上往下看,超时(Timeout)后先查询发送服务(Query sending service)。查询到邮件编号(message ID),走左边分支保存回执;请求仍在处理,等待后再查;只有服务同时确认“没有产生效果”和“旧请求已经停止”,才沿用原幂等键重试;权威系统仍说不清,就交给人工对账。
这里要把几种“恢复”分开。请求根本没有离开当前程序,可以在次数和时间上限内重试;模型输出缺字段,就把明确的格式错误交还模型修正;程序在决定保存以后崩溃,重启时读取已经保存的历史,沿用原决定继续;任务正在等审批,就回到原来的等待位置。请求已经发出却没有结果,则必须去权威系统对账。最重要的分界,是把普通临时故障和“外部动作可能已经发生”分开:前者可以有限重试,后者必须先查。
Retry:在确认可以安全重做以后,再次尝试同一步,并设置次数、时间与退避上限。
Replay:根据持久历史重建控制流,继续使用已经记录的决定。
Reconcile:到权威系统查询外部动作的真实结果,再决定确认、等待、补偿或重试。
进程重启以后,怎样认出这是同一封邮件?
邮件服务的状态要查,Agent自己的进度也要留下。发送刚刚超时,运行Agent的程序又重启了;聊天记录还在,却看不出模型是否已经决定发送、经理是否批准、工具调用是否已经离开本系统。聊天内容记录“说过什么”,持久状态还要记录“哪一步已经承诺执行”。
所以模型作出决定以后,我先保存决定和工具意图,再去碰外部系统。最小记录依次写下四件事:这封邮件的内容已经确定;经理批准了这份内容;带固定请求编号与幂等键的调用已经发出;邮件服务最终返回了服务确认的邮件编号。
稳定动作编号在程序重启、换一台机器执行以后仍然不变。收件人、主题和正文先用固定字段顺序与字符编码序列化,再计算一个内容指纹;这种整理不改变邮件含义。这里的“摘要”是由内容计算出的稳定指纹,不是一段模型总结。收件人、主题、正文等实质内容改变时,指纹比对就不会通过。审批绑定这份指纹:重复点击、两个页面同时提交或服务恢复两次,都不能生成新的动作。系统用一次不可分割的数据库操作登记“这份批准已经用于这个动作”,发送始终沿用原来的请求编号和幂等键。
进程醒来以后只要顺着记录往下读。决定已经保存,就不让模型重新生成邮件;批准已经到达,就进入发送;调用已经离开系统,就拿原请求编号查询;看到服务确认的邮件编号,就直接确认完成。
如果工具参数格式、政策或Agent版本已经变化,旧记录进入迁移、对账或人工处理。恢复的目的,是继续一条已经承诺的时间线,不是悄悄换一套规则重跑。
Checkpoint:在执行过程中持久保存的一份状态快照,任务可以从这里恢复。
Durable execution:任务在进程崩溃、部署或长时间等待以后,仍能从已保存状态继续执行的能力。
最危险的缝隙,正好在发送成功之后
还有一种更棘手的情况。邮件服务已经发出第一封邮件,正准备返回服务确认的邮件编号;就在返回结果写进Agent记录之前,进程崩溃了。
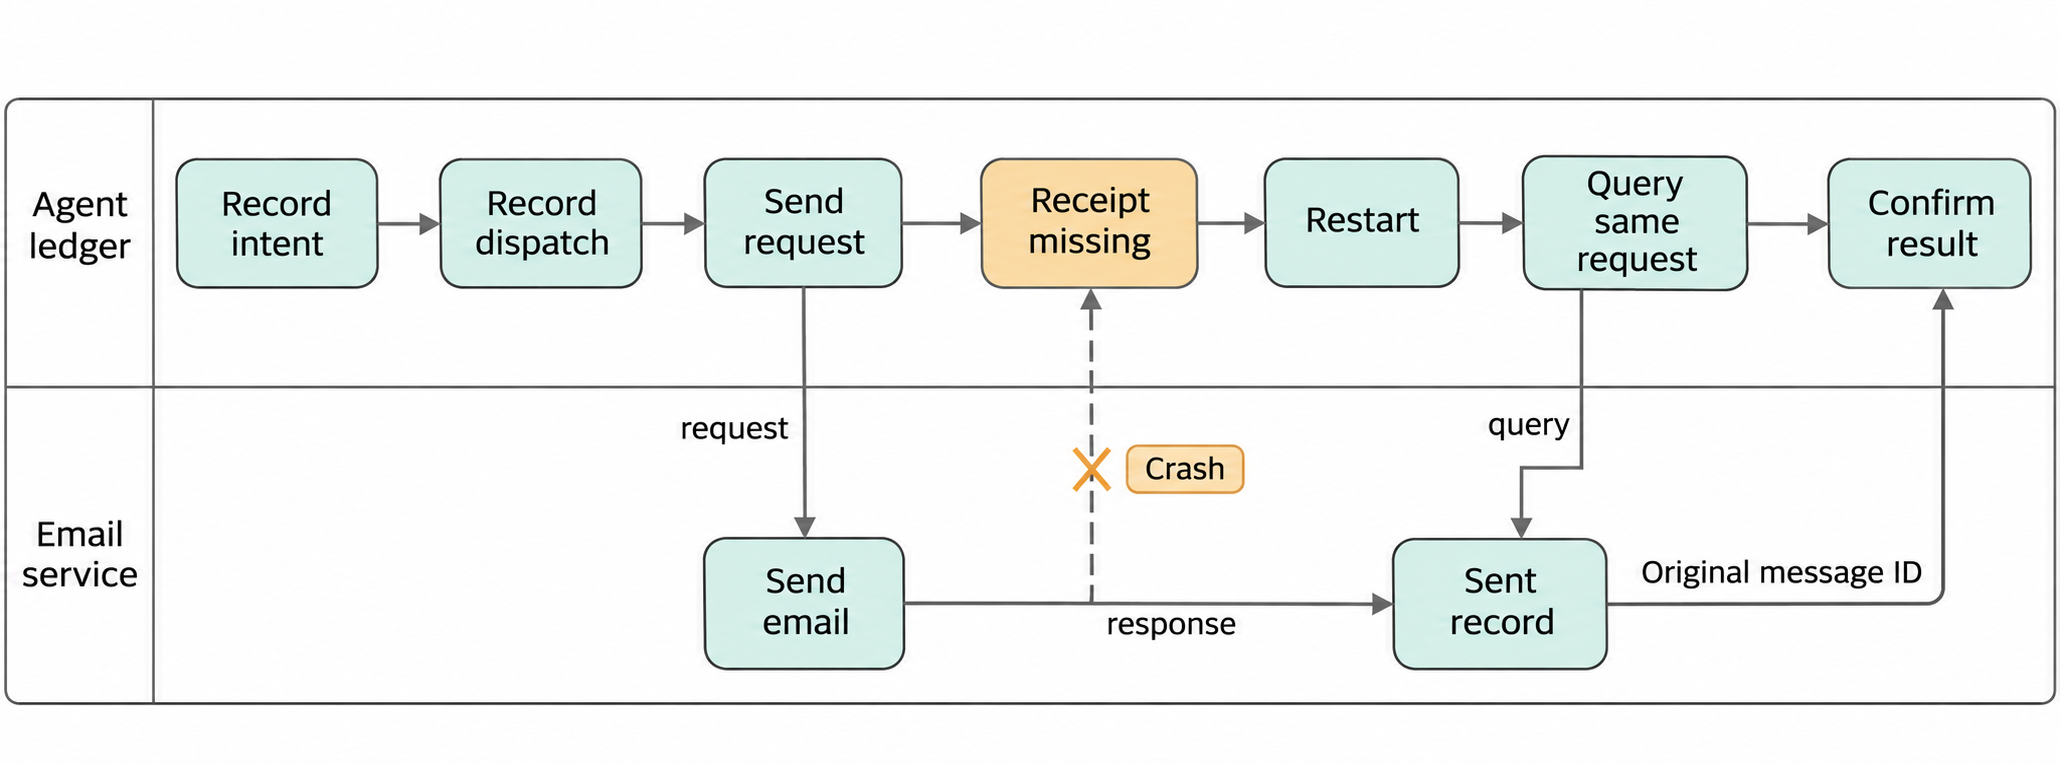
图的下方是邮件服务:邮件已经发出,也留下了发送记录。上方的Agent账本却在收到回执以前崩溃,只知道请求已经派发;重启后它不会再发一封,而是拿同一个请求编号查询下方的发送记录,找回原来的邮件编号,再确认结果。
恢复后,时间线停在“请求已发出”。Agent知道请求离开了自己,却不知道外部世界已经多了一封邮件。只保存任务整体的checkpoint还不够,我们还要把每一个可能改变外部系统的动作单独记账。这里的“副作用”,就是发送邮件、创建采购单或付款这类会改变外部世界的结果。
我把这张账本叫作EffectLedger,也就是副作用账本。它在调用前保存稳定动作编号、邮件内容指纹和幂等键。准备发出请求时,先把账本推进“已派发”,再调用发送服务;调用后补记确认、未知或需要补偿。即使程序在派发记录写好后、真正发送前崩溃,恢复时也先查询原请求,确认能安全发送再继续。动作编号由不变的任务、业务操作、逻辑步骤和目标资源共同生成,因此无论尝试几次、换哪台机器执行,账本里都还是同一件事。
账本停在“已派发”时,下一步是查询。服务确认发送成功,就保存邮件编号;仍在处理,就继续等待;结果与预期不同,就进入补偿。只有权威系统确认旧请求不会继续执行,并证明没有产生效果,账本才记下“允许重试”。重新发送时继续使用原来的动作编号和幂等键。
把恢复规则写进一条状态机
状态从“已计划”进入“已授权”,再进入“已派发”。服务确认发送后,状态结束在“已确认”;服务没有给出确定结果,就进入“结果未知”,之后只能走向已确认、安全重试或需要补偿。
两台执行机器可能同时恢复,都想发送这封邮件。我让它们修改同一行账本,并附上一个条件:“只有这一行还处于已授权状态,才允许我把它改成已派发。”数据库一次只让一个成功,另一个看到状态已变,就停止发送。这种“先确认旧状态没有被别人改过,再更新”的操作叫compare-and-set。它解决的是两个执行者抢同一件事的问题。每次变化还保存判断依据,比如批准记录或邮件服务的查询回执。“已派发”也不能退回“已计划”,因为那会抹掉“请求可能已经离开系统”这个事实。
幂等键还要一路传到真正发送邮件的服务。服务需要把“登记这个键”和“创建发送任务”作为一个不可分割的操作:再次收到同一个键,就返回原任务的结果。目标服务没有幂等键或按键查询时,EffectLedger仍能记录发生过什么,却不能凭空知道外部结果。
EffectLedger:按稳定action ID记录外部调用意图、授权、派发、结果和对账状态的副作用账本。
幂等:同一个逻辑操作执行一次或重复执行,最终业务效果相同。
结果未知不是报错,是一份未结案
“查询不到”也不能直接翻译成“没有发送”。读取的副本可能还没同步,旧请求可能仍在队列里,发送服务也可能暂时无法查询。于是未知结果继续等待权威查询:找到资源就确认;证明没有效果且旧请求已经停止,才安排安全重试;已有结果与预期不同,就进入补偿;仍无法判断,则交给人工对账。
邮件已经发错,补偿可能是再发一封澄清;采购申请已经创建,可以新建一个取消动作;款项已经支付,则进入退款流程。补偿不会删除原始历史,它用一个新的业务动作把系统带回可接受状态。
状态未知:系统无法确认一次外部操作是否已经产生副作用的状态。
Compensation:当已完成的步骤无法直接回滚时,通过新的业务动作抵消或修正影响。
2026年的进展:这些恢复工作,已经能交给哪些工具?
讲到这里,你可能已经在想:这些记账、等待和恢复,难道都要自己写?2026年,更多Agent框架开始直接接入成熟的持久执行系统,已有Agent代码因此可以少写一层跨进程恢复、等待审批和长任务状态的连接代码。
第一条路线是Temporal。它是一套持久工作流引擎:“持久”表示程序退出以后,任务进度仍保存在外部存储里。它把一张采购单看作Workflow,把查供应商、调用模型、发送邮件这些外部步骤看作Activity。邮件生成以后要等经理批准,Temporal保存Workflow进度,让当前程序先释放资源;批准信号到来,再从等待位置继续。服务中途重启,它根据历史恢复未完成的步骤。
Temporal在2026年3月把OpenAI Agents SDK集成推进到正式可用;2026年10月26日的产品更新又宣布Google ADK、OpenAI Agents SDK、AWS Strands和LangGraph等集成正式可用。这些集成替团队接好运行历史、定时等待、接收审批通知和恢复入口。发送邮件的Activity仍然沿用原来的请求编号、幂等键和EffectLedger;Temporal恢复的是流程进度,邮件服务确认的是外部结果。
第二条路线是PydanticAI加Restate。PydanticAI是一个用Python编写Agent的框架,擅长把模型输入、工具参数和输出定义成明确类型。放到这封邮件里,收件人、主题、正文和动作编号组成同一份可验证的发送意图。Restate接在执行层,把每次模型调用、工具步骤和路由结果依次写进持久记录(journal);需要等待经理批准时,用可唤醒的等待点保存进度,服务重启后继续。
Pydantic与Restate在2026年5月12日公布的集成把两层接在一起:官方示例用 RestateAgent(agent) 接住已有的PydanticAI Agent,用 run_typed 运行带类型的步骤,并用可唤醒等待点保存审批。PydanticAI说明Agent这一步收什么、产出什么,Restate记录这一步做到哪里、崩溃以后怎样接上。把它放回开头的故障里:进程重启以后,Restate先找回已经完成的步骤,程序接着查询原来的邮件请求。发送服务按原幂等键去重,两边各自保存的记录在这里接上。
如果项目已经使用LangGraph或Microsoft Agent Framework,也可以用checkpoint保存当前编排位置,再沿用同一套邮件查询与安全重试规则。
Workflow:一项需要跨多个步骤、等待或故障继续执行的完整业务任务。
Activity:Workflow中调用模型、API或其他外部服务的一步工作。
Human-in-the-loop(HITL):任务在关键动作前暂停,由人批准、拒绝或补充输入后继续。
回到那十秒超时以后
现在再看开头那次超时。第一次发送使用稳定的请求编号和固定幂等键。十秒没有回复,账本把它留在“结果未知”,没有创建第二个动作。
进程重启后,持久历史恢复同一份邮件意图。运行时拿原请求编号查询发送服务:如果找到服务确认的邮件编号,就补记“已确认”,供应商不会因为Agent恢复而再收到一封;如果请求仍在队列里,继续等待;如果服务确认旧请求不会继续执行,并证明没有产生效果,系统才用同一个请求编号和幂等键重新发送;如果仍然无法判断,任务停下来交给人工对账。
这才是“恢复”真正解决的问题:程序可以继续往前走,又不会把不确定性藏进一次盲目重试里。下一篇再回答恢复后的Agent代表谁、能看到什么、又能改变什么。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。