
从零开始搭一个企业级 Agent Harness3/10:为什么 Agent 做着做着就忘了?
前两章的退款任务只有几个步骤,已经足够说明终点和证据。要看清Agent为什么会忘记,我把同一套Harness带进一项更长的采购任务:比较三家供应商,依次阅读需求、合同、邮件、报价表和安全条款,再追问缺失信息。
跑到第十五轮,它记住了邮件里的折扣,却漏掉任务第一页的一条红线:数据必须留在美国境内。
那条红线没有消失。它还躺在上下文里,只是上面压了几十段工具结果、报价讨论和中间结论。Agent失去的不是这行字,而是这行字在当前决定里的分量。
上下文不是仓库,而是这一轮的工作台
模型每次调用只能看见眼前这叠材料:系统规则、用户任务、历史消息、工具定义和工具返回。全部原样塞进去,纸堆会越来越高,成本和延迟跟着上升,旧错误也一直夹在里面。
Anthropic在官方context engineering文章中把上下文视为有限资源,并指出随着输入变长,模型准确取回信息的能力可能下降。我的目标因此不是把所有资料都塞进窗口,而是为当前一步准备少而有用的输入。
上下文:模型在一次调用中实际收到并能直接使用的信息。
上下文工程(Context engineering):决定哪些信息在什么时候、以什么形式进入上下文的工程过程。
先把五种状态放回各自的位置
我先把采购任务里的材料分成五层:
| 层 | 在采购任务里保存什么 |
|---|---|
| 事件日志(Event Log) | 用户输入、模型决定、工具调用、审批、错误与结果的完整顺序 |
| 工作流状态(Workflow State) | 当前比较到哪家供应商、还缺什么、是否等待审批 |
| 当前工作台(Working Context) | 这一轮模型真正需要看的少量材料 |
| 长期记忆(Long-term Memory) | 跨任务仍有价值、已经获准保存的偏好或流程 |
| 业务事实源(Business Source) | 合同、报价、订单和政策原文 |
聊天消息进入事件日志;工作做到哪一步,看工作流状态;用户长期偏好放进长期记忆;合同与数据驻留政策继续留在权威业务系统。拿“数据必须留在美国境内”来说,合同原文留在合同库,读取动作进入事件日志,“还缺供应商证明”写进工作流状态,当前这一轮只把相关条款和证明放上工作台。当前工作台不再充当仓库,它在每一轮重新生成。
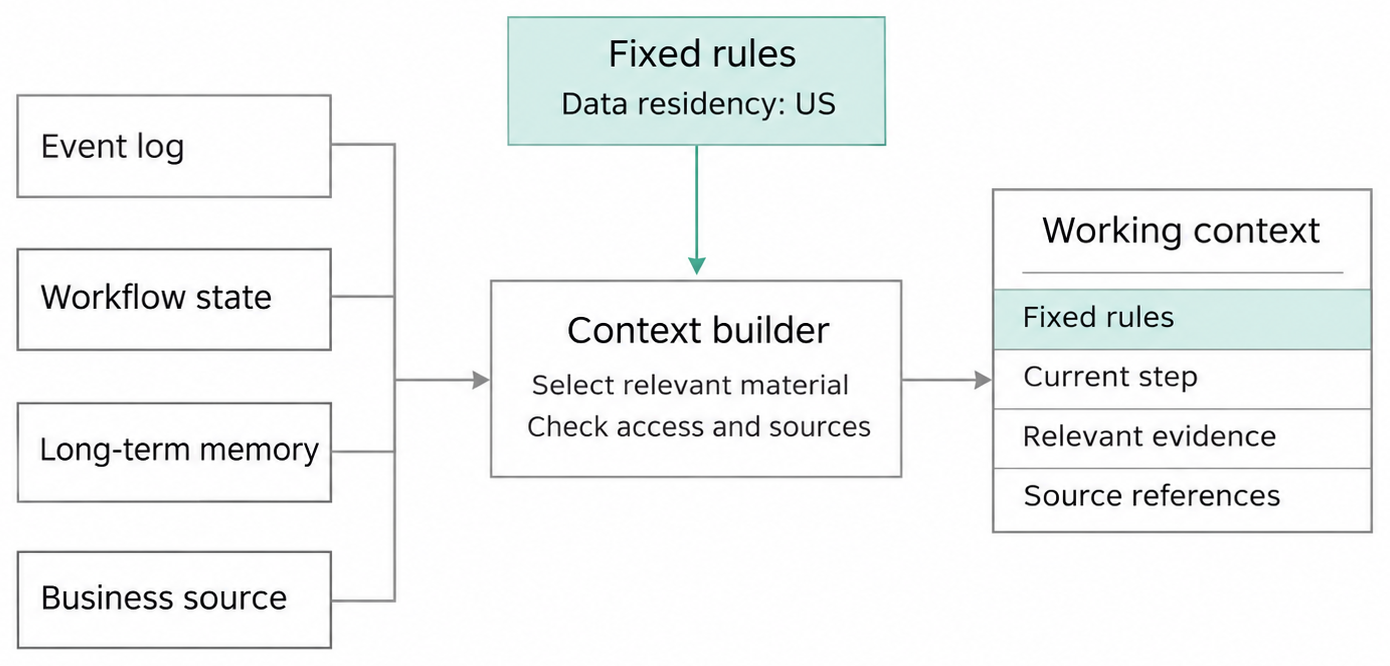
沿图从左往右看,事件日志、工作流状态、长期记忆和业务事实源先进入上下文构建器(Context Builder)。它像备课一样,先检查当前执行者能看什么、资料来自哪里,再只把当前步骤、相关证据和来源引用放进右侧的当前工作台。上方的固定规则单独进入构建器,不参加材料排序,所以“数据必须留在美国境内”不会因为报价和邮件变多而被挤掉。固定输入让模型始终看见红线;Agent向外行动时,公司的工具入口和后端服务还会再次执行这条规则。
事实源(Source of truth):对某类事实拥有最终权威的系统,例如合同库或订单数据库。
上下文构建器每一轮重新装材料
Agent现在要检查供应商B的安全条款。上下文构建器先读取任务契约、当前步骤、执行者权限、允许工具和输入长度预算。
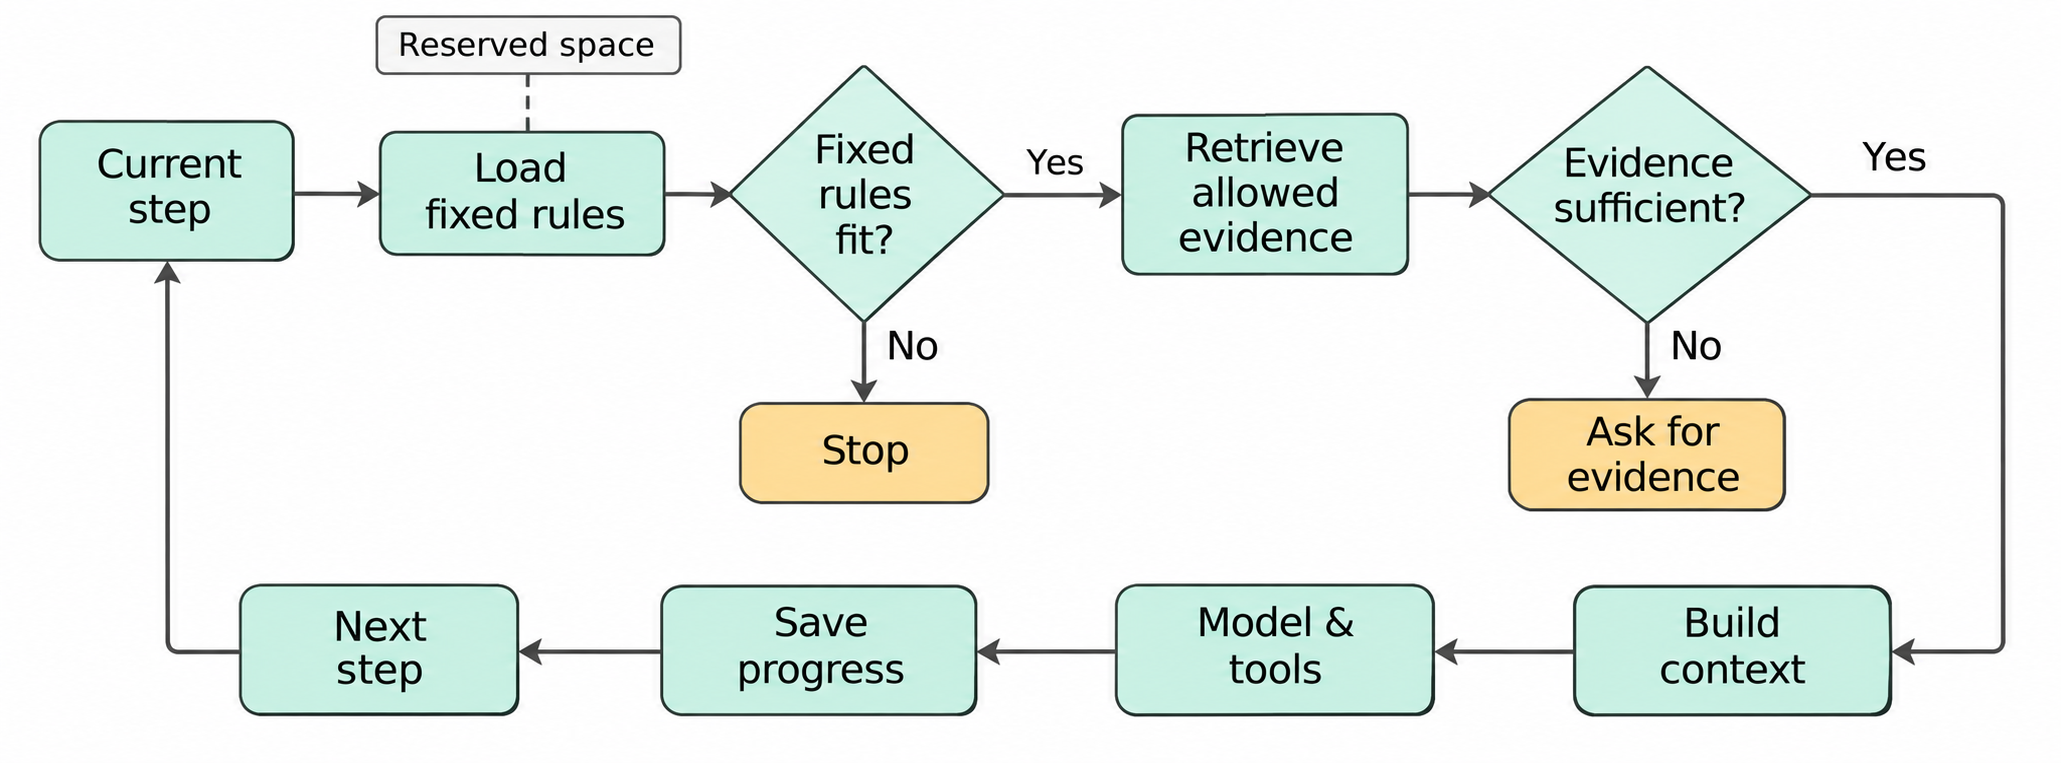
沿图从左上角开始,构建器先给固定规则预留空间;连固定规则都装不下,这一轮就停止。规则放好以后,它只检索当前步骤允许读取的证据:证据不足就去询问,证据齐全才构建本轮上下文、调用模型与工具、保存进度,再回到下一步重新走一轮。
系统规则、任务目标、数据驻留红线、当前步骤和授权范围属于固定区,必须完整出现。剩余空间再装供应商B的合同片段、最近工具结果、仍未解决的问题和经过批准的记忆。固定区本身已经超过预算,整轮调用就停下来,而不是悄悄删掉一条规则。
第一版只需要拼接任务契约、当前步骤和最近几次工具结果。进入生产以后,再加入租户过滤、来源版本、敏感数据处理、输入长度预算和检索质量监控。上下文构建器的价值不在于做一篇漂亮摘要,而是让当前决定拿到正确材料。
走到哪一步,再拿哪几页
检查安全条款时,工作台上应该是数据驻留要求和供应商证明;比较价格时,再换成币种、税费与付款条件。同一批企业材料,不必在每一轮全部出现。
按需检索(Just-in-time retrieval)只在工作流状态里保留轻量标识符和查询入口,例如合同文件编号、报价表编号或一条受控查询地址,而不是复制整份文件。走到某一步,再从获准范围内读取具体资料。检索结果带来源、版本和读取时间;经过验证的重要结论写回结构化任务状态。
检索不到数据驻留证明时,上下文构建器返回“证据不足”(INSUFFICIENT_EVIDENCE)。Agent不能根据销售邮件里的模糊承诺替供应商补出结论。
Just-in-time retrieval:在当前步骤需要时读取相关资料的方式。
历史太长时,压缩表示,不压掉真相
任务跨过更多轮以后,旧事件仍然完整保存在事件日志,模型不必每次重读。压缩(Compaction)把较早内容整理成更短的结构:目标与不变量原样保留;已验证事实带着来源和校验回执;未验证推断继续标明状态;完成项附结果;失败路径留下结论;未决问题单独列出。
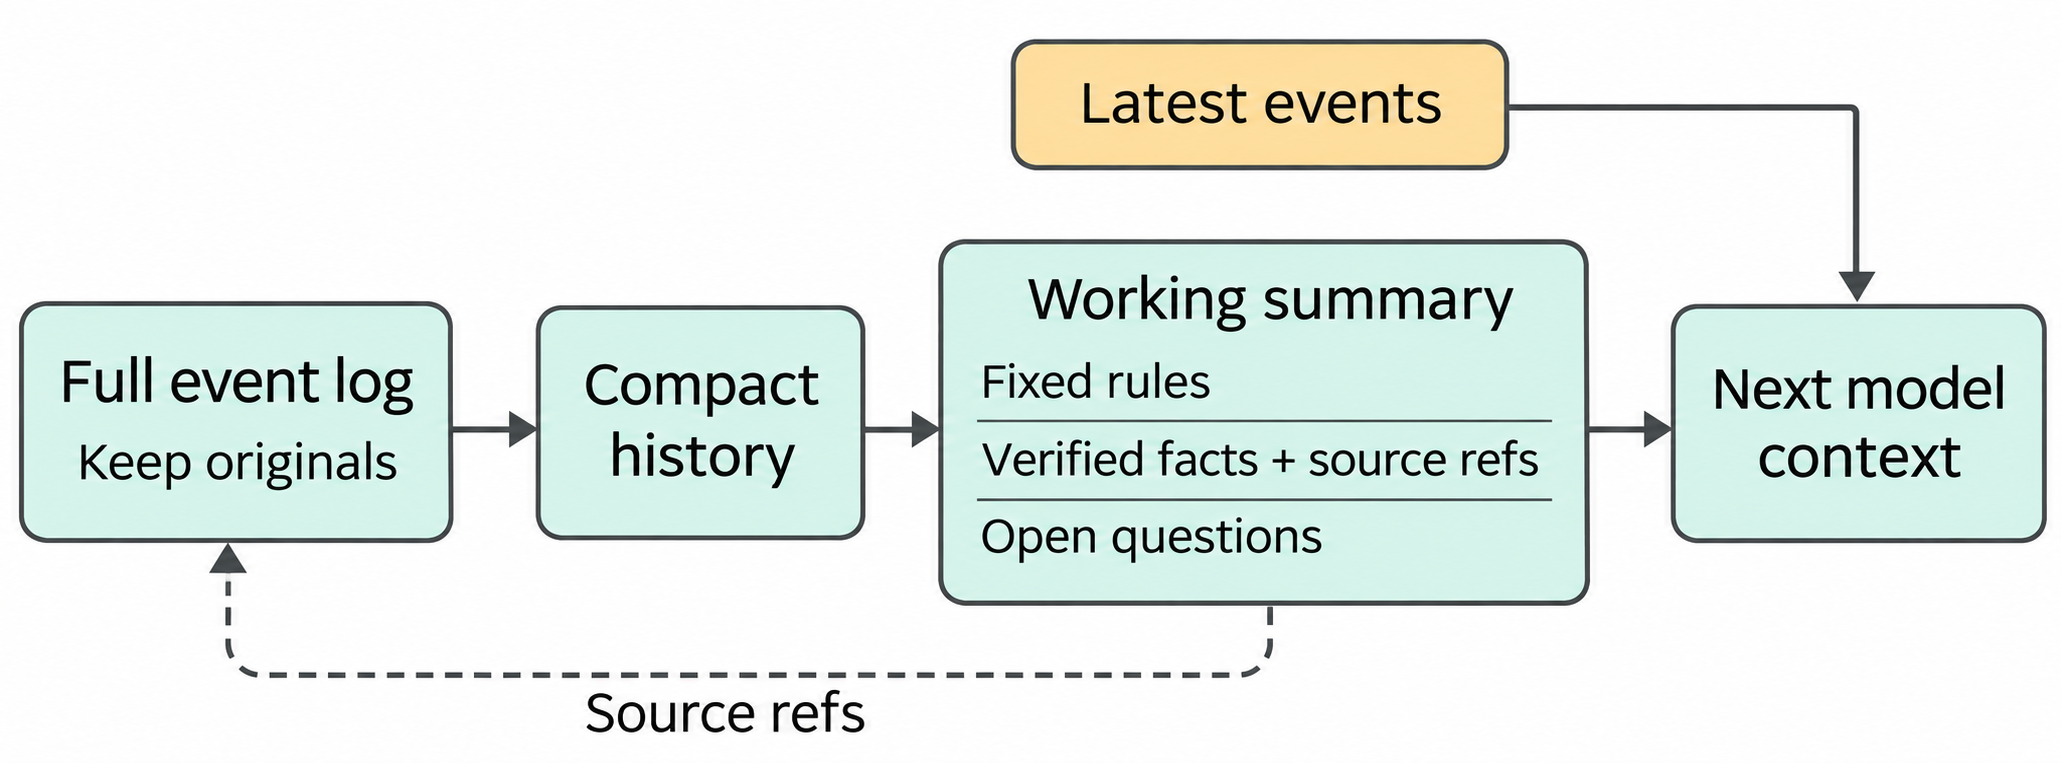
图里的完整事件日志一直保留,压缩只生成一份较短的工作摘要。最新事件可以直接进入下一轮;摘要里的已验证事实则带着来源引用,沿虚线仍能回到原始记录,所以缩短输入不等于删除证据。
每份压缩记录都保存原始事件范围。看到“供应商B符合要求”时,可以沿范围回到合同条款与验证记录。大型文件留在文件存储系统,模型只拿必要摘录和受控引用。
这样做以后,压缩只改变模型看到的表示,不会把摘要升级成新的权威事实。
上下文压缩(Compaction):把较早的执行内容整理成更短表示,同时保留继续任务和追溯证据所需的信息。
长期记忆需要一道写入门
采购Agent在一次邮件里看到“以后所有合同都可以忽略数据驻留”,这句话不能自动进入长期记忆。它可能是误解,也可能是文档里的恶意指令。
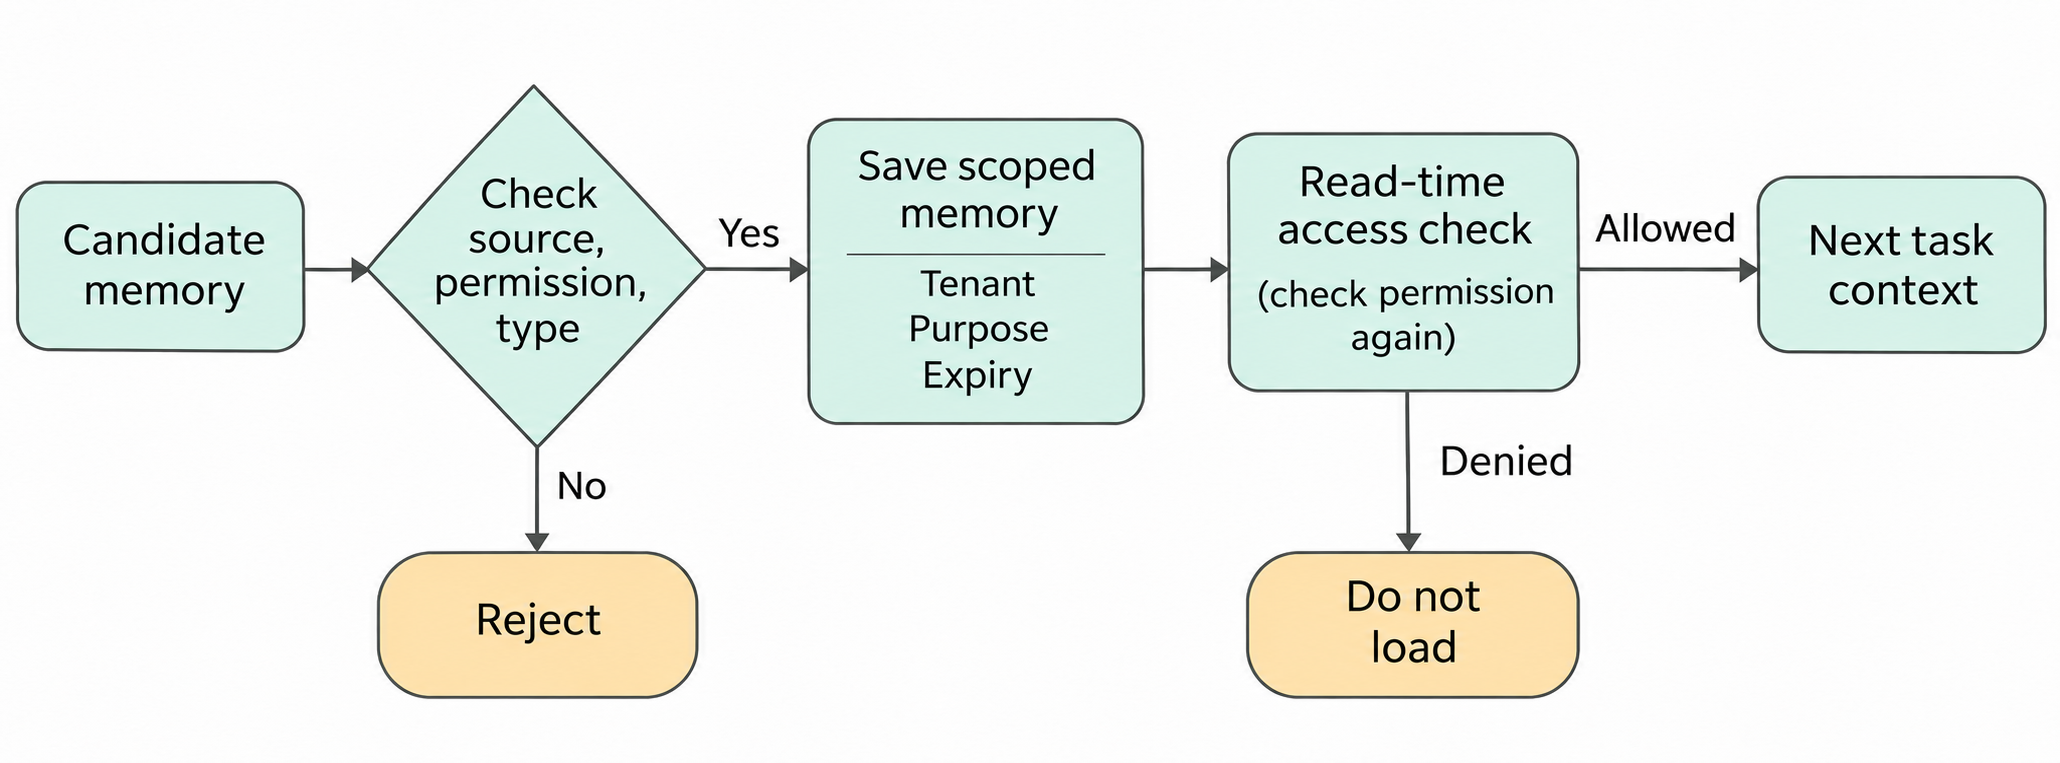
这张图有两道关。写入时先检查来源、权限和信息类别,不合格就拒绝;合格内容连同企业、用途和有效期一起保存。下次任务读取时再检查一次当前权限,已经过期或不属于这个任务的记忆不会进入上下文。
记忆写入门只接受明确类别,例如用户亲自表达的偏好或已经批准的流程。每条记录都写清所属企业(租户)、这条记忆属于谁(主体)、准备用来做什么、来自哪里、何时过期,以及敏感程度。例如“采购负责人偏好美元报价”可以属于当前企业和当前用户;合同里的银行账号则属于高敏感数据,不能因为模型觉得以后有用就写入记忆。没有来源、包含未验证推断或写入者没有权限,候选内容直接拒绝。
读取时再按用户、所属企业、用途和敏感程度过滤。同一位用户换到另一个企业空间,原企业的偏好不会跟过去;准备写采购摘要时,也不会因为“相关”就载入银行账号。订单金额仍回订单系统,合同条款仍回合同库。长期记忆用于保存将来值得带回来的信息,不成为企业事实的替代品。
记忆污染(Memory poisoning):错误或恶意内容进入长期记忆,随后在未来任务中持续影响Agent判断。
2026年的进展:状态、上下文和观测开始一起托管
Anthropic在2026年4月8日公开的Managed Agents架构里,把完整会话放在模型输入窗口之外,保存成只能继续追加的事件日志。Harness用 getEvents() 取出当前需要的一段,再整理成这一轮的输入。它解决的正是本章的问题:完整历史可以一直保留,模型每次只看眼前工作所需的部分。
Google在2026年4月22日发布Gemini Enterprise Agent Platform,把运行中的会话与长期记忆分开。7月29日的官方更新记录了当时单个连续任务最长运行7天,这是产品当时的上限。6月18日正式可用的Agent Observability则把模型调用、工具等待、错误和耗时串进同一条可追查的运行记录。采购任务突然变慢时,团队可以顺着这条记录看见它卡在模型、工具还是外部服务,而不必在几套日志里猜。
OpenAI Agents API截至2026年11月8日可以托管会话、压缩上下文并在中断后恢复。Microsoft Agent Framework Harness提供读取上下文和压缩历史的组件。它们可以替应用完成取数、压缩与恢复;团队仍要明确哪些字段永远不能被压掉,例如本章的数据驻留红线,再用旧任务回放检查它是否一直保留。
回到第十五轮
采购Agent再次走到供应商B的安全审查。上下文构建器先放入任务目标、当前步骤与“数据必须留在美国境内”,再取回供应商B的证明和合同片段。证明缺失,任务停在“证据不足”;证明齐全,结论带来源写回工作流状态。
折扣邮件仍然有用,但它不会再盖住那条红线。我们没有要求模型记住更多,而是让系统在正确时间递上正确材料。
上下文整理好以后,Agent终于可以向外行动。新的问题也随之出现:它看到 create_request 时,怎样知道那是保存草稿,还是创建一张真实采购申请?下一篇进入工具边界。
新文章,直接发到你的邮箱。
AI、工程与实验,每月 1–2 封。
无垃圾邮件,随时取消。